编码器懂孟加拉语复合动词,大模型却只会字面翻译

孟加拉语复合动词基准揭示编码器能区分语义但大模型无法调用。
研究团队构建了BanglaCV-Probe基准,包含17个向量动词、1044个最小对立对等,测试26个模型对孟加拉语复合动词的理解。结果显示,编码器能在内部区分向量动词的两种含义(去表面线索后准确率93%),但提示式大模型很少调用该知识,蕴涵题准确率仅59%-81%,且普遍存在回答偏差;多数指令微调模型在15%-20%的句子上直译,mora字面化率高达55%。孟加拉语专用小模型在搭配任务上以88%持平BLOOM-7B1并超过Qwen2.5-7B,表明参数规模并非决定性因素。研究揭示了表示层与解码层的能力断层,对多语言NLP评估与开发具有启示意义。
孟加拉语中,主动词后常跟一个「向量动词」,后者失去本义,只增添完成等语法色彩。比如 likhe phello 表示「写完了」,而不是「写了并扔掉」。同样的动词组合也能描述两个独立事件,全靠语境区分。这种复合动词是多词表达的典型难题,也成了检验语言模型是否真正理解语言的试金石。
BanglaCV-Probe:一个专门「拷问」模型的基准
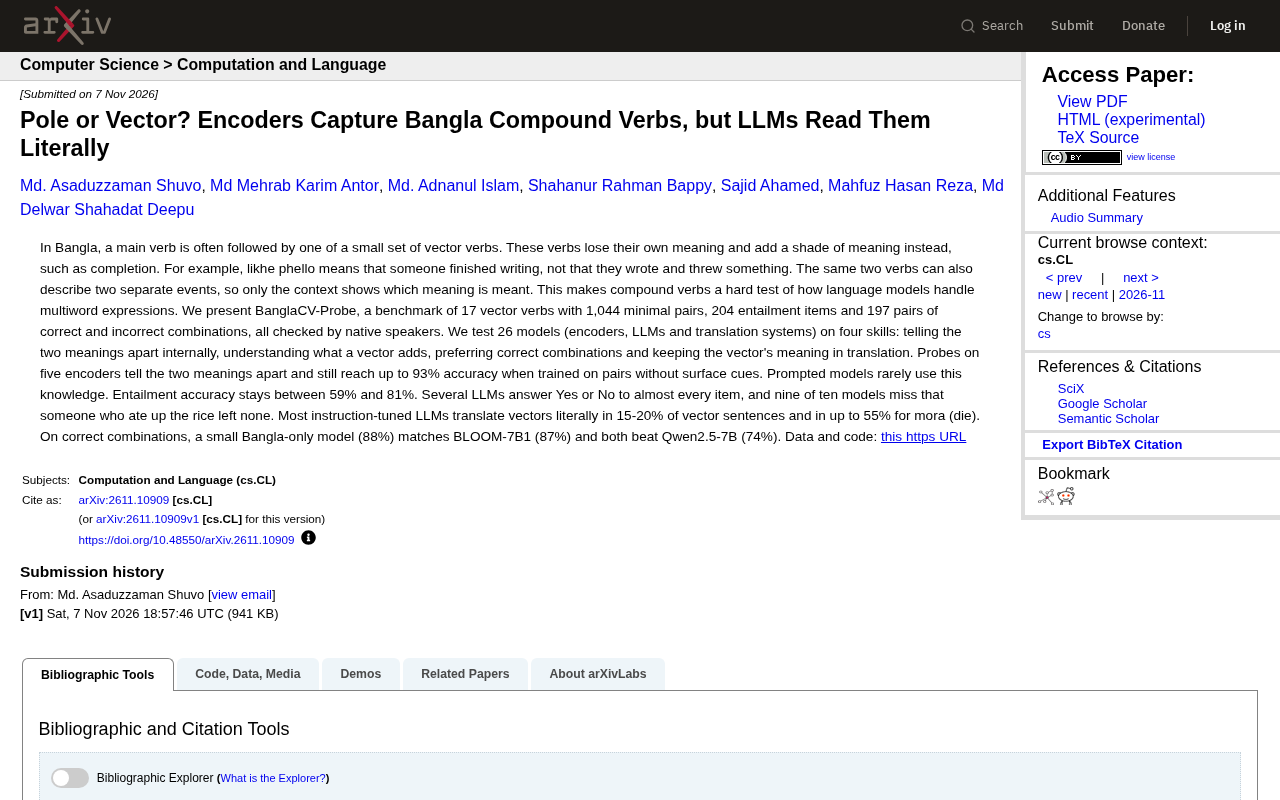
研究团队构建了 BanglaCV-Probe,包含 17 个向量动词、1,044 个最小对立对、204 个蕴涵题和 197 组正确/错误搭配,全部由母语者校验。他们用这个基准测试了 26 个模型——编码器、大语言模型和翻译系统——覆盖四项技能:内部区分两种含义、理解向量动词的附加意义、偏好正确搭配,以及在翻译中保留向量含义。
编码器「暗中掌握」,大模型「嘴上不说」
对五个编码器的探针显示,它们能在内部区分两种含义,即使训练数据去掉表面线索,准确率仍可达 93%。这说明编码器确实捕捉到了复合动词的语义区别。
但提示式模型很少调用这种知识。蕴涵题准确率停留在 59% 到 81% 之间。多个大模型几乎对所有题目都回答「是」或「否」,十个模型中有九个没意识到「把米饭吃光了」意味着不剩米饭。知识存在,却无法在生成时被可靠地使用。
探针(Probe) 是分析神经网络内部表示的一种技术:在模型的隐藏层表示上训练一个简单的分类器,以检验该表示是否线性编码了某种语言学属性。探针准确率高,说明模型内部确实捕捉到了相关语义区别;但探针结果并不保证模型在生成任务中会使用这些信息。本文中,探针帮助揭示了编码器能区分复合动词的两种含义,而提示式模型却无法调用这种知识,形成了“知识存在但无法使用”的断层。
翻译系统:字面化是通病
多数指令微调大模型在 15%–20% 的向量动词句子上直译,对 mora(死)这个向量动词,字面翻译率最高达 55%。这意味着模型把语法化的向量动词当作独立实义动词处理,译文丢失了完成、彻底等附加意义。
字面化(Literalization) 指机器翻译系统将语法化成分(如向量动词)误译为独立的实义动词,从而丢失其语法功能。例如,将孟加拉语 likhe phello(写完了)中的 phello(扔)直译为“扔”,得到“写了并扔掉”的错误译文。字面化是语法化现象在机器翻译中的典型失败模式,源于模型未能识别多词单元的整体性,且训练数据中缺乏足够的平行结构来学习这种非组合性映射。
小模型也能扳倒大模型
在正确搭配偏好任务上,一个仅针对孟加拉语训练的小模型达到 88%,与 BLOOM-7B1 的 87% 持平,双双超过 Qwen2.5-7B 的 74%。参数规模不是决定性因素,语言特异性训练反而更有效。
多源视角下的共识与分歧
据该研究以及社区对基准的讨论,编码器与生成模型之间的能力断层是核心共识:表示层能编码的语义,解码层未必能兑现。分歧在于如何归因——一方认为是提示策略与指令微调目标导致模型「偷懒」走字面路径,另一方则指出复合动词本身高度依赖语境,基准中的最小对立对可能放大了模型的保守倾向。单一来源的观察还提到,翻译系统对 mora 这类高频向量动词的字面化率异常高,可能与其在训练数据中的分布有关,但这一点尚需更多验证。
最小对立对(Minimal Pair) 是语言学实验设计中常用的一种刺激对,指两个句子仅在一个关键成分上不同,从而凸显该成分的语义或语法作用。在本文基准中,最小对立对用于对比复合动词的两种解读(如完成义与并列动作义),以测试模型能否区分。然而,这种设计可能迫使模型在脱离语境的情况下做判断,从而放大其保守倾向,导致对自然语言中依赖语境消歧的复合动词产生偏差。
对多语言 NLP 的启示
复合动词不是孟加拉语独有的现象,南亚语言中普遍存在。BanglaCV-Probe 的价值在于把「模型是否理解语法化」拆成可测量的子任务,暴露出编码器能力与生成能力之间的鸿沟。对开发者而言,靠加大参数量未必能解决这类细粒度语义问题,针对性的语言数据与探测驱动的评估可能更关键。数据和代码已在 GitHub 开源,可供复现与扩展。
背景补充
向量动词(Vector Verb) 是南亚语言语法化研究中的核心概念,指南亚语言(如孟加拉语、印地语)中紧跟在主动词后的一类动词。它们原本是实义动词(如“扔”“吃”“死”),但在复合动词结构中发生语法化,语义漂白,仅保留体貌(aspect)信息,如完成、彻底、突然、蓄意等。这与英语的体标记(如 have done)功能相似,但以词汇形式呈现。向量动词与主动词构成一个语义整体,其附加意义难以从字面推导,因此成为语言模型语义理解的难点。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。

AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。

从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。