编码智能体的终止滞后:早解出、晚收工
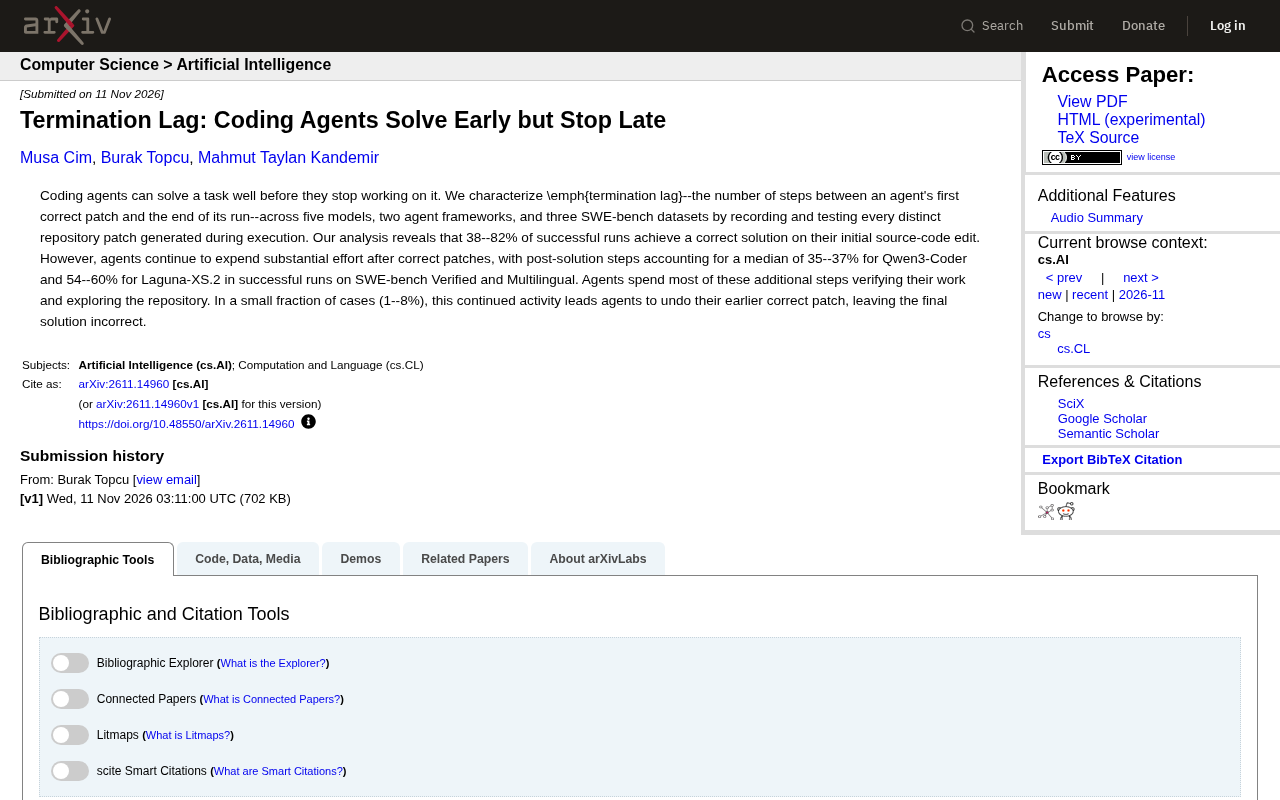
编码智能体常“早解出、晚收工”,首次正确补丁后仍大量空转甚至改坏解。
一项研究提出“终止滞后”概念,揭示编码智能体在任务实际完成后仍继续运行大量步骤。研究覆盖五个模型、两种框架和三个 SWE-bench 数据集,逐补丁测试发现多数成功运行在首次编辑时已产生正确解,但解后步骤中位数占比可达 35–60%。这些额外步骤主要用于验证和探索仓库,小部分案例中还会撤销正确补丁导致最终错误。该现象说明当前智能体缺乏有效终止判断机制,设计上需在提升任务能力的同时优化停止策略,减少无谓计算浪费。
引言:编码智能体为何“早解出、晚收工”
近期一项研究提出了“终止滞后”(termination lag)的概念:编码智能体往往在任务实际完成之前,仍然继续运行许多步骤。该研究覆盖五个模型、两种智能体框架和三个 SWE-bench 数据集,通过记录并测试执行过程中生成的每一个不同的仓库补丁,系统刻画了从首次正确补丁到运行结束之间的步骤数。这一发现揭示了一个被忽视的效率问题:智能体虽然能较早地解决问题,但往往不会及时停止。
SWE-bench 是评估编码智能体解决真实软件工程问题能力的基准测试集。它从 GitHub 上的开源 Python 仓库中收集真实的 issue 和对应的修复 PR,要求智能体在给定代码库和问题描述的情况下生成补丁。SWE-bench 包含多个变体:SWE-bench Full 是完整测试集;SWE-bench Verified 由人工筛选出 500 个高质量、可复现的样本,是当前最常用的评测子集;SWE-bench Multilingual 则将任务扩展到多种编程语言。研究者通常用“补丁是否通过测试”来判定任务是否成功。本文提到的“两种智能体框架”指的是驱动模型与环境交互的脚手架,例如 ReAct 风格的循环:模型观察仓库状态、决定执行命令或编辑文件、获得反馈后继续。不同框架在工具集、上下文管理和终止条件上存在差异,因此同一模型在不同框架下的终止行为也可能不同。理解这些基准和框架的构成,有助于把握“终止滞后”研究在何种实验条件下被测量。
核心发现:多数成功运行在首次编辑即已正确
研究显示,绝大多数成功运行在最初的源代码编辑中就已经产生了正确的解决方案。具体而言,有相当大比例的成功运行(原文给出 38–82% 的区间)在第一个补丁上就实现了正确修复。这一结果说明,智能体在早期步骤中已经具备解决任务的能力。
然而,问题在于智能体并未就此停止。在成功运行中,从首次正确补丁到运行结束之间仍然存在大量步骤,这些“解后步骤”占据了相当可观的比例。对于 Qwen3-Coder,其中位数占比为 35–37%;对于 Laguna-XS.2,在 SWE-bench Verified 和 Multilingual 上的占比更是高达 54–60%。这意味着,超过一半的工作量发生在问题已经解决之后。
补丁(patch) 在软件工程语境中指的是一组对源代码文件的修改,通常以 diff 形式表示,记录增加、删除或修改了哪些行。在 SWE-bench 类任务中,智能体每执行一次文件编辑操作,就可能产生一个新的仓库状态;把所有编辑累积起来便形成一个候选补丁。研究中“记录并测试执行过程中生成的每一个不同的仓库补丁”,意味着在智能体运行的每个步骤后,都把当前仓库状态导出为一个补丁并运行测试,从而判断该时刻是否已经存在正确解。所谓“首次正确补丁”,就是最早通过全部相关测试的那个中间状态。这种方法能够精确测量“解出”与“收工”之间的时间差,而不是仅看最终提交的补丁。需要注意的是,中间补丁可能并不完整或不可提交,但测试通过足以说明该时刻已具备正确修复的逻辑。
解后步骤都在做什么?
那么,智能体在“解后步骤”中究竟在做什么?研究分析指出,这些额外步骤主要花在两个方面:验证工作和探索仓库。智能体会反复检查自己的修改是否正确,或者进一步查看代码库的其他部分,以确保没有遗漏。这种“过度谨慎”的行为虽然可能出于提高可靠性的目的,但也带来了明显的计算资源浪费。
更严重的是,持续的活动并非总是无害。在一小部分案例中(原文为 1–8%),这种继续操作反而导致智能体撤销了之前正确的补丁,最终使解决方案变得不正确。这种“画蛇添足”的现象暴露了当前智能体在终止判断上的缺陷。
自我验证(self-verification) 是智能体在生成修改后,主动检查其正确性的过程,常见形式包括重新阅读代码、运行测试、静态分析或让模型自我批判。在编码智能体中,验证步骤对提高最终成功率很重要,因为模型可能产生看似合理但实际错误的补丁。然而,验证也有成本:每次运行测试或重新阅读大段代码都会消耗 token 和工具调用轮次。当验证变成反复确认同一件事时,就会产生冗余步骤。另一方面,探索(exploration) 指智能体在仓库中搜索相关文件、理解调用关系或查找潜在副作用。适度的探索有助于发现遗漏的修改点,但过度探索会拖长运行时间。终止滞后的一个关键成因,是智能体缺乏对“已经足够好”的置信判断,因而默认继续验证和探索。理解验证与探索的收益递减,是设计更优停止策略的前提。
对编码智能体设计的启示
这项研究对编码智能体的设计具有重要启示。终止滞后的存在意味着,仅仅关注任务是否成功是不够的,还需要关注智能体何时停止。一个高效的智能体应当在确认问题解决后及时终止,而不是无谓地继续消耗步骤。
当前的主流框架可能缺乏有效的终止判断机制,导致智能体在达到正确解后仍继续执行默认的循环。未来的改进方向包括:引入更精准的自我验证机制,使智能体能够自信地判断任务已完成;或者设计更合理的停止策略,避免过度探索。
总结
“终止滞后”现象揭示了编码智能体中一个普遍但被忽视的效率问题。多数成功运行在早期即已正确,但智能体却倾向于继续运行大量步骤,甚至有时会破坏已有的正确解。这一发现提醒研究者和开发者,在提升智能体任务能力的同时,也需关注其终止行为的优化。
相关推荐
GitHub日报·11月19日:老牌前端杀回榜单,历史地图单日涨近千星

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。