编码助手≠AI智能体:一个价值万美元的认知错误

混淆编码助手与AI Agent会导致错误选型和合规审计失败,需按访问范围分类审查。
文章指出,许多团队把 Cursor 这类编码工具统称为「AI Agent」,这一命名混淆已造成超过一万美元的采购与审计损失。编码助手被严格限制在 IDE 内,每次改动都有人类审阅 diff,工具集只围绕代码本身;而 AI Agent 跨 CRM、邮件、数据库、API 等外部系统运行在自主循环中,没有逐步人工审批。安全审查者常误以为在评估编程辅助工具,实际放行的却是能触碰生产数据库的自主系统,合规链条因此缺失控制点。文章以 Apidog CLI 演示说明差距:Agent 可读取 OpenAPI 规范、生成并执行测试、在 CI 中零人工运行,编码助手无法做到。建议采购团队先问清系统访问范围与审批要求,再决定按哪类工具放行。
很多团队把 Cursor 这类编码工具叫作「AI Agent」,这个看似无害的称呼正在让企业付出真金白银的代价——错误的工具选型,以及最终失败的合规审计。
混淆的代价:不只是叫错名字
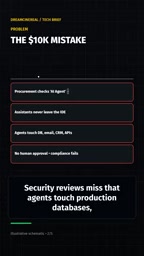
据 YouTube 频道 Architecture Decisions 的分析,把编码助手当成 AI Agent 会带来超过一万美元的损失。这个数字来自错误采购和审计失败两方面:企业以为自己买的是「编程辅助 Agent」,于是在采购评估和安全审查时按编程辅助工具的标准放行,结果实际部署的系统拥有远超预期的系统访问权限。
问题的根源在于,这两个概念在能力边界上存在本质差异,但名字被混用了。
编码助手:始终困在 IDE 里
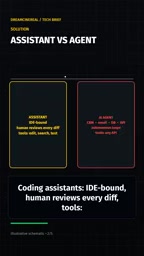
编码助手(Coding Assistant)的活动范围被严格限制在 IDE 之内。它的工作模式是人机协作的紧密回路:开发者写代码、助手提供补全或建议、开发者审阅每一处 diff,工具、编辑、搜索、测试都在这个闭环里完成。
每一次改动都有人类把关,这是编码助手的关键特征,也是它安全性的来源。它的工具集围绕代码本身构建,不涉及外部业务系统。
AI Agent:跨系统、自主循环
AI Agent 的定义特征截然不同。它跨系统工作——CRM、邮件、数据库、API,凡是暴露了 API 的东西都是它的操作对象。它运行在自主循环中:读取输入、决策、执行、再读取结果,整个过程没有逐步的人类审批环节。
这正是安全审查容易漏掉的点:审查者以为自己在评估一个编程辅助工具,实际放行的却是一个能碰生产数据库、能发邮件、能改 CRM 记录的自主系统。没有逐步人类审批,就意味着合规链条上缺少了传统的控制点,审计自然过不去。
自主循环(Autonomous Loop) 是区分 Agent 与普通自动化脚本的关键机制:系统在每一轮迭代中自行读取环境反馈、决定下一步动作、执行并再次观察结果,直到达成目标或触发终止条件,人类只在循环之外设定目标与边界。与之相对的是「人在回路」(Human-in-the-loop)模式,即每个关键动作前都需人工确认。自主循环带来的风险在于,一旦模型判断失误或提示被注入,错误动作会在无人察觉的情况下连续放大,因此生产级 Agent 通常需要配套的权限最小化、动作白名单、可观测日志与中止开关,这些也正是合规审计重点核查的控制项。
用 Apidog CLI 划出分界线
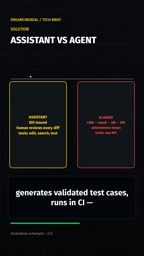
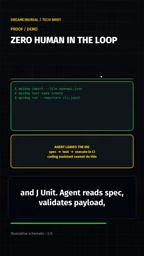
视频用一个 Apidog CLI 的演示来说明两者的能力差距。演示流程是:先执行 Apidog import 导入 openapi.json 规范文件,然后用 Apidog test case create 生成经过验证的测试用例,最后用 Apidog run 配合 reporters CLI 和 JUnit 输出执行测试。整个过程跑在 CI 里,零人工介入。
Agent 读规范、校验 payload、创建测试、执行测试——这条链路完全自动化。编码助手做不到这一点,因为它根本不会离开 IDE,更不会去读 API 规范并驱动外部测试流程。
OpenAPI 规范(原 Swagger 规范)是用 JSON 或 YAML 描述 REST API 的标准格式,包含路径、请求方法、参数、请求体结构、响应状态码与数据模式等信息。正因为它是机器可读的,Agent 才能据此自动推断接口契约、校验 payload 是否符合 schema、并生成覆盖正常与异常分支的测试用例。这也是演示中 Apidog import 能一键导入并驱动后续流程的前提——若接口没有规范描述,自动化链路就只能依赖人工编写或抓包逆向,Agent 的自主性将大打折扣。
JUnit 报告格式是测试领域事实上的通用输出标准,以 XML 结构记录用例名称、耗时、通过/失败状态与错误堆栈,被 Jenkins、GitHub Actions、GitLab CI 等主流流水线原生解析。演示中通过 reporters CLI 输出 JUnit 结果,意味着 Agent 生成的测试不只是跑完即弃,而是能接入既有 CI 门禁,让失败用例自动阻断合并请求,从而把自动化测试真正纳入质量与合规的证据链。
对团队的实操建议
采购和安全团队在评估「AI Agent」类产品时,需要问清楚几个问题:这个系统会触达哪些外部系统?每一步操作是否需要人类审批?它的工具集是否超出代码范围?如果答案指向跨系统访问和自主执行,那它就应该走 Agent 的审查流程,而不是按编码助手放行。
反过来,如果团队只是想要提升编码效率,一个绑定 IDE、每处改动都有人审阅的编码助手就是正确选择,没必要为「Agent」的标签支付额外的合规成本。
概念清晰本身就是一种架构决策。
在采购与安全评估中,可采用一套简单的分类清单:先确认系统的工具集边界(是否只操作代码仓库与 IDE,还是可调用外部 API、数据库与消息系统),再确认执行模式(是否每步需人工确认),最后确认凭据范围(使用何种服务账号、是否可写生产环境)。三者中任意一项越界,就应按 Agent 级别走审批、沙箱与审计日志流程。此外,建议在合同中要求供应商明确披露 Agent 可调用的工具清单及权限模型,并将其纳入变更管理,避免上线后能力悄然扩张而审查结论失效。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。