表格空白单元格如何拖垮AI Agent的决策准确性

OCR解析表格时空白单元格易致数据错位,会沿AI Agent决策链放大并污染最终输出。
文章聚焦于文档智能处理中一个常被忽视的数据陷阱:OCR工具在读取含连续空白单元格的表格时,容易因缺乏文本锚点而产生行列错位,导致数值归属出错。这一错误的隐蔽性在于OCR仍会输出外观完整的表格,但数据对应关系已被打乱。更危险的是,AI Agent的工作流是链式的,解析阶段的错误会逐级向下传导,最终渗透到推理决策与执行动作中。文章指出,对于开发者而言,选型文档解析工具时须专门评估复杂/稀疏表格场景,并在数据进入推理前增加行列一致性校验,对高风险文档保留人工复核。LlamaIndex为此推出LlamaParse,专注于高精度复杂表格解析。
一个被忽视的数据陷阱
在文档智能处理链路中,OCR(光学字符识别)往往被视为已经解决的问题。但一个看似微不足道的细节——表格中的空白单元格——正在悄悄破坏下游 AI Agent 的决策质量。
根据 LlamaIndex 团队在 Twitter 上分享的观察,许多文档 OCR 工具在读取包含多个连续空白单元格的表格时会出现问题:数值会从原本所属的列和行发生错位(shift),最终导致下游系统对数字的错误解读。
这类问题的隐蔽性在于,OCR 引擎通常仍会输出一个结构完整、看起来合理的表格,但其中的数据对应关系已经被打乱。对于人类审阅者来说,错位可能一眼就能看出;但对自动化的 Agent 来说,它只会照单全收地把错误数据传递下去。
空白单元格为何如此棘手
结构对齐的挑战
表格的本质是二维的结构化数据,行列关系承载着语义。当某些单元格为空时,OCR 引擎缺乏可识别的文本锚点来判断边界,只能依靠视觉线条或空间位置推断。
一旦推断失误,原本属于第三列的数值可能被错误地归入第二列。这种「列偏移」在财务报表、实验数据表、账单等场景中尤其危险——一个数字放错位置,可能意味着完全不同的业务含义。
从技术实现角度看,主流 OCR 引擎处理表格时通常依赖两种策略:一是检测物理线条(ruled table),通过实线或虚线框定单元格边界;二是无线表格识别(borderless/spanning table),依靠文本块的空间分布和投影切割来推断列对齐。第二种策略在处理空白单元格时尤为脆弱——当某列连续多行为空时,投影算法可能将相邻两列之间的间距误判为「无列分割」,从而将后续列的内容整体左移。此外,PDF 本身的编码方式也是一个隐患:扫描件 PDF 需要 OCR 重建布局,而原生 PDF 虽然保留了字符坐标,但表格结构往往没有被显式标记,解析库仍需靠空间推断来还原行列关系,同样容易在稀疏区域出错。
错误的向下传导
AI Agent 的工作流通常是链式的:文档解析 → 数据提取 → 推理决策 → 执行动作。如果解析阶段的数据就已经错位,那么后续每一步都是在错误的基础上运算。
LlamaIndex 强调,这会造成「错误的数值解读在下游发生」。换句话说,问题的代价不会停留在解析环节,而是被放大并渗透到最终的 Agent 决策中。这正是为什么表格准确性对于关键文档的处理如此重要。
对文档密集型 Agent 的启示
随着越来越多企业尝试用 AI Agent 处理合同、发票、财报和研究数据,文档解析的质量正成为整个系统可靠性的地基。一个再强大的推理模型,也无法从错误的输入中得出正确的结论——garbage in, garbage out 在 Agent 时代依然成立。
对于开发者和团队来说,这意味着在选型文档解析工具时,不能只看整体识别率,还需要专门评估工具在复杂表格、稀疏表格(含大量空白)场景下的表现。LlamaIndex 为此推出了 LlamaParse,主打对复杂文档中高精度表格解析的支持,尤其面向那些「表格准确性极为重要」的场景。
如何降低风险
在实际工程中,可以考虑以下几个方向来缓解空白单元格带来的错位问题:
- 选择针对表格结构做过专门优化的解析工具,而非通用 OCR。
- 在数据进入 Agent 推理前,增加校验环节,例如行列数一致性检查、数值范围合理性检测。
- 对高风险文档保留人工复核,尤其是财务和法律类文件。
- 利用结构化输出(如带明确行列标记的格式),减少下游对空间位置的依赖。
「Garbage in, garbage out」这一原则在大语言模型(LLM)驱动的 Agent 场景下有其特殊性:传统程序遇到格式异常的输入往往会抛出错误,提醒开发者排查;而 LLM 具有较强的容错与补全倾向,面对错位的表格数据通常不会报错,而是「自信地」基于错误数据给出一个看似合理的推断。这种「有毒的流畅性」使得表格错位问题在 Agent 系统中比在传统程序中更难被发现。数据质量问题被掩盖在模型的自然语言输出之中,只有当最终决策结果出现偏差时,才可能被人工注意到——而此时错误往往已经造成实际影响。
小结
这条来自 LlamaIndex 的提醒,点出了 Agent 系统中一个容易被忽略却影响深远的环节。空白单元格问题看似技术细节,实则关乎整个自动化决策链路的可信度。在把文档处理交给 AI Agent 之前,先确保它读到的表格是对的——这一步的投入,远比事后追查错误决策来得划算。
相关推荐
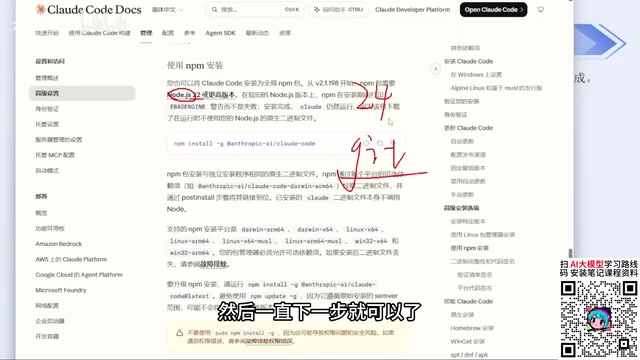
Claude Code国内环境实战:安装配置与防封号全攻略
Claude Code国内环境安装配置实战教程:详解NPM安装方式、Node.js与Git前置准备,重点介绍用CCSwitch绕过账号登录防封号的方法,并给出模型选择与科学上网建议。
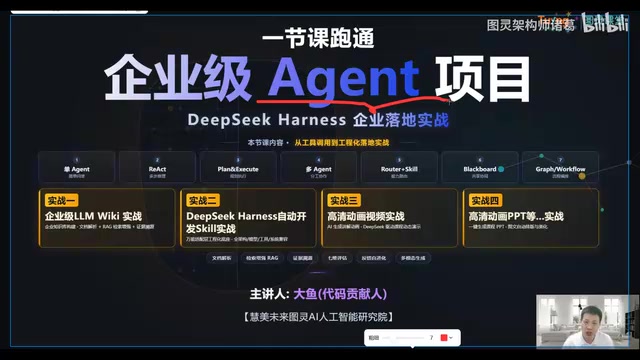
DeepSeek Harness 实战入门:从工具调用到 Agent 工程化落地
本文梳理 B 站 DeepSeek Harness 实战分享的技术要点,解析 Agent 的四大核心能力(翻译官、工具达人、记忆管家、任务管家)与三次技术跃迁,并理性评估这类入门教程的实际价值与局限。
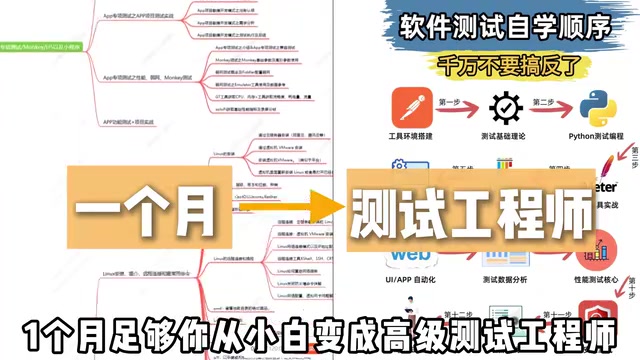
0基础转行软件测试:一个月上岸的高效学习路线
一套面向零基础学员的软件测试四周学习路线,涵盖用例设计、Linux与网络基础、接口测试、Python自动化框架到项目实战。本文梳理路径并客观分析其可行性,帮助转行人群理性规划。