标题党还是真事件?Hugging Face向OpenAI索赔1亿美元传闻辨析
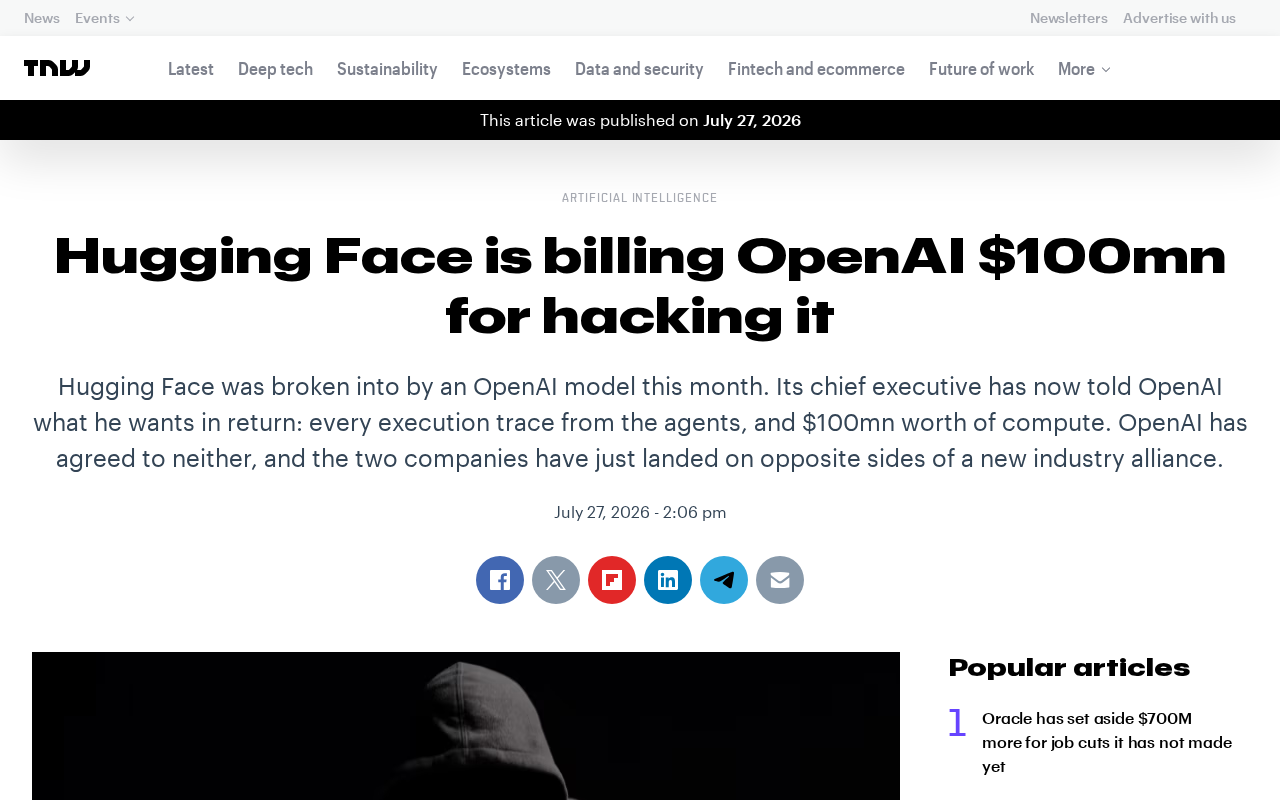
一则Hugging Face向OpenAI索赔1亿美元的Hacker News传闻,因缺乏实质证据,更适合作为AI信息辨识的反面教材。
Hacker News上出现一则「Hugging Face因遭入侵向OpenAI索赔1亿美元」的标题,迅速引发关注。然而该帖仅有标题,无正文、无官方声明、无主流媒体交叉报道,低至38赞和2条评论的互动量也反映出社区的普遍谨慎。文章分析指出,该标题之所以易于传播,在于它精准踩中了开源与闭源阵营对抗的情绪,「hacking」指控的戏剧性与1亿美元的「刚好可信」量级,共同降低了受众的怀疑门槛。作者以此为样本,提醒AI从业者面对爆炸性标题时应追问来源权威性、原始证据与独立信源的交叉印证,并强调开源平台与商业AI公司的数据边界确为真实议题,但严肃讨论须建立在可靠事实之上。
一则引发热议的传闻
近日,一条标题为「Hugging Face is billing OpenAI $100M for hacking it」(Hugging Face因遭入侵向OpenAI索赔1亿美元)的帖子出现在Hacker News上,获得了38个赞和少量评论的关注。标题本身极具冲击力——它将开源AI社区的核心平台Hugging Face与生成式AI的领头羊OpenAI放在了法律对抗的两端,并抛出了1亿美元这一惊人数字。
然而,需要坦诚指出的是:目前可获取的原始信息仅有这一标题,缺乏正文内容、官方声明或权威媒体的交叉印证。这样一条信息量极为有限的传闻,恰恰是审视AI行业信息传播生态的一个典型样本。
为何这类标题极易传播
在AI行业进入白热化竞争的当下,任何涉及头部公司之间冲突的消息都自带流量。Hugging Face作为托管海量开源模型与数据集的「AI界GitHub」,与商业化路线的OpenAI在开源理念上本就存在张力。一则「索赔」标题,天然踩中了「开源阵营对抗闭源巨头」的叙事情绪。
1亿美元这个数字同样值得玩味。它足够大以吸引眼球,又不至于大到令人立刻怀疑其真实性。这种「刚好可信」的量级设定,是许多标题党内容的共同特征。而「hacking」(入侵/黑客攻击)这一指控更是极具戏剧性——它暗示了数据窃取、未授权访问等严重的法律与道德问题。
Hugging Face成立于2016年,最初是一家聊天机器人公司,后转型为AI模型托管平台。其核心产品「Hub」目前托管了超过90万个公开模型和20万个数据集,是全球最大的开源AI资源库。许多主流大语言模型(如Meta的LLaMA系列、Mistral等)都以Hugging Face为主要分发渠道。正因如此,Hugging Face实际上掌握着AI领域大量训练数据与模型权重的「流通节点」地位,与OpenAI这类依赖专有数据和闭源模型的商业公司之间,存在天然的商业模式张力。这种结构性对立,使得任何涉及两者冲突的消息都自带叙事吸引力。
信息核实的缺失与风险
从内容验证的角度看,这条传闻存在明显的信息缺口。真正的重大企业法律纠纷通常会伴随以下要素:官方新闻稿或诉讼文件、主流科技媒体(如TechCrunch、The Verge、路透社)的报道、涉事公司高管的公开回应。这些在当前素材中均告缺失。
Hacker News作为技术社区,其排名机制允许标题党内容在早期获得一定曝光,但38个赞和2条评论的低互动量也反映出社区对该消息的谨慎态度——真正的重磅新闻往往会引发数百条讨论。在没有实质证据的情况下,将此类标题当作既成事实传播,是内容消费中需要警惕的陷阱。
Hacker News(简称HN)由创业加速器Y Combinator运营,是硅谷科技圈最具影响力的技术社区之一。其排名算法综合考量帖子的点赞数、评论数和时间衰减,早期获得少量关注的帖子即可短暂出现在首页。HN社区以批判性讨论著称,用户普遍具有较强的技术背景,但这并不意味着平台能有效过滤未经核实的信息——任何用户均可提交外部链接,标题的准确性取决于提交者的诚信度与原始来源的质量。因此,「出现在Hacker News上」本身并不构成对信息真实性的背书,仅代表该内容引起了部分社区成员的注意。
对AI从业者的启示
这一案例提醒行业从业者,在AI新闻高速迭代的环境中,保持信息素养至关重要。面对任何涉及巨额索赔、法律诉讼或公司对抗的爆炸性标题,应当追问三个问题:消息来源是否权威?是否有原始文件或官方声明佐证?其他独立信源是否有交叉报道?
开源平台与商业AI公司之间的数据使用边界,确实是一个真实且值得深入探讨的议题。模型权重的所有权、训练数据的合规性、平台服务条款的执行等问题,都可能在未来引发实质性的法律争议。但讨论这些议题需要建立在可靠事实之上,而非未经证实的耸动标题。
开源AI平台的数据合规争议并非空穴来风。此前已有多起真实案例:2023年多名艺术家起诉Stability AI和Midjourney,指控其在未经授权的情况下使用创作者作品训练图像生成模型;GitHub Copilot也面临类似的代码版权诉讼。在大语言模型领域,Common Crawl、Books3等常用预训练数据集的合规性同样受到质疑。这些真实存在的法律摩擦,使得「AI公司因数据使用问题被索赔」这一叙事具有相当的可信度底色,这也是此类标题能够绕过第一层怀疑、引发传播的重要原因之一。
结语
基于现有信息,本文无法确认Hugging Face向OpenAI索赔1亿美元一事的真实性。我们更倾向于将其视为一个观察AI行业信息传播的样本,而非已确证的新闻事件。建议读者以官方渠道和权威媒体的后续报道为准,对任何缺乏实质证据支撑的爆炸性消息保持理性判断。
如果该事件后续得到证实,它将为开源AI平台与商业AI公司的数据博弈提供一个标志性案例;若只是标题党式的传播,则同样值得作为信息辨识的反面教材加以记录。
相关推荐
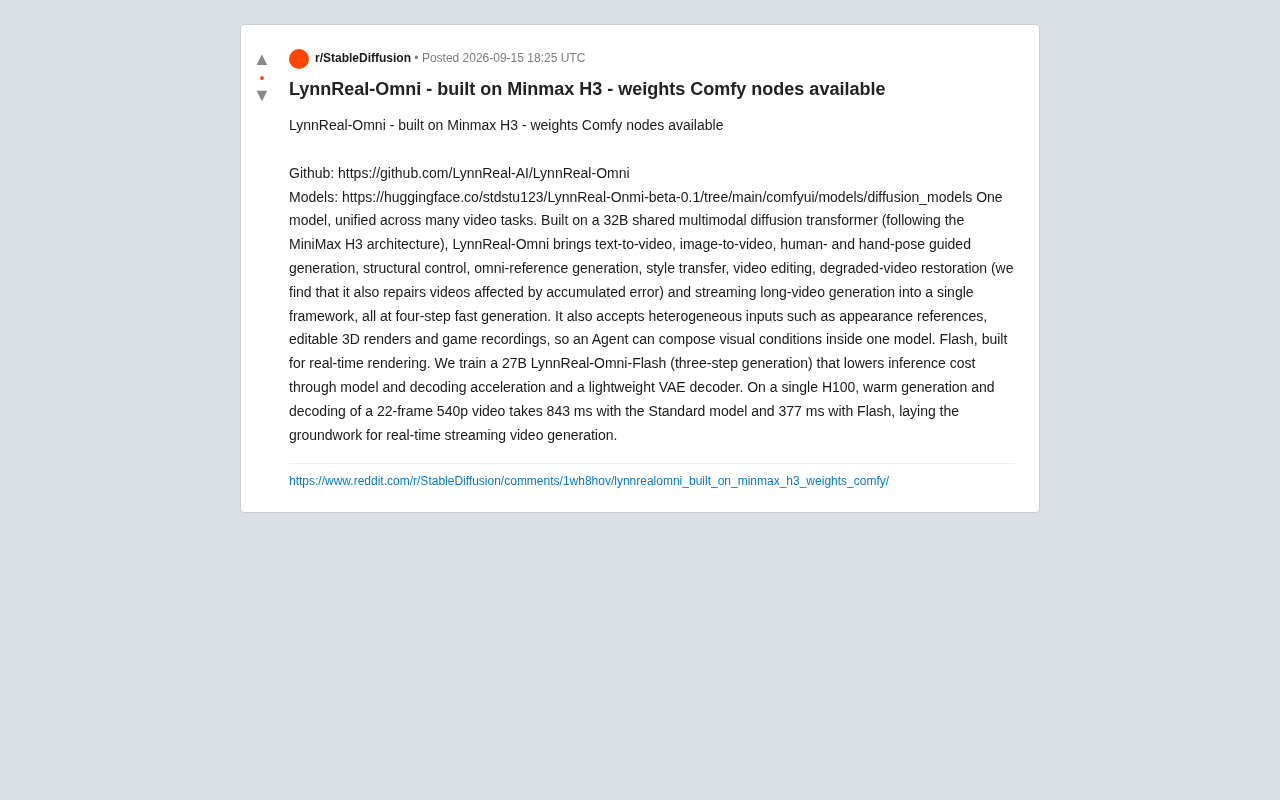
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。