标注覆盖如何扭曲RAG检索分数?乳腺病变系统实证

临床RAG研究发现检索分数高度依赖标注覆盖度,标注扩充后排名不变但相关证据量增加。
一项针对乳腺病变管理文献的临床RAG实证研究揭示,检索分数高度依赖标注覆盖度。研究构建18篇文档、18条查询的基准,混合检索器配合384 token块和20%重叠率在17条查询中top3命中证据,四项检索指标均达0.94。关键发现在于:标注从25个证据片段扩至37个后,检索排名纹丝不动,但可接受块从36增至51,说明原始标注可能遗漏大量相关证据。研究还指出18文档小样本和检索知情标注是主要局限,呼吁放射科医生独立评估,并建议RAG评估报告标注覆盖度、做标注敏感性分析。
当“标准答案”变多,检索分数为何纹丝不动?
在临床RAG系统的评估中,我们习惯用检索分数(Recall@K、MRR、nDCG)来判断系统好坏。但一项针对乳腺病变管理文献的实证研究揭示了一个容易被忽视的问题:检索分数高度依赖标注覆盖度。当研究者将证据片段从25个扩充到37个、可接受块目标从36个增加到51个后,检索排名竟然没有任何变化。这意味着,我们此前看到的分数,可能只是标注不完整下的“虚高”或“虚低”。
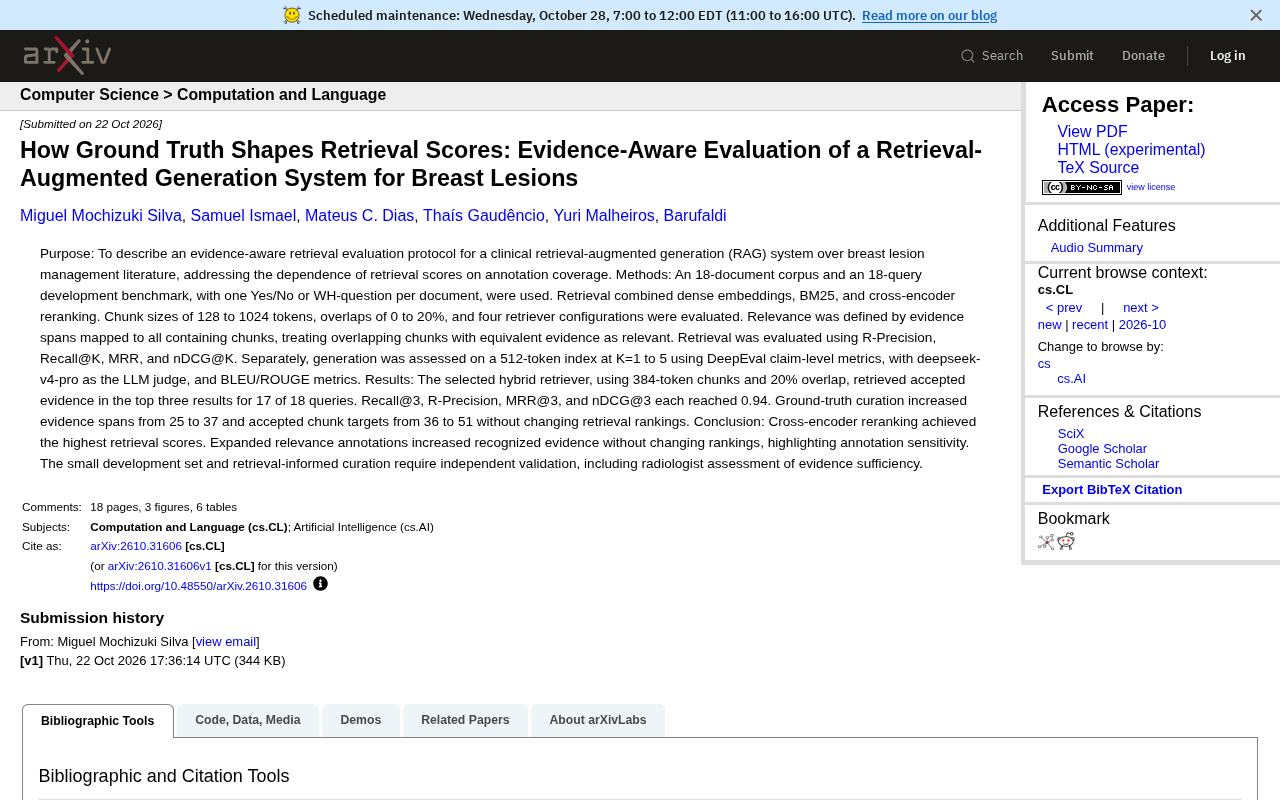
该研究构建了一个18篇文档的小型语料库和18条查询的开发基准,每条查询对应一篇文档中的一个是/否或WH问题。检索管线融合了稠密向量、BM25和交叉编码器重排序,并系统比较了128到1024个token的块大小、0到20%的重叠率以及四种检索器配置。相关性的定义不再停留在文档级别,而是要求证据片段映射到所有包含它的块——重叠块若含有等价证据,均被视为相关。
RAG(检索增强生成) 是一种将信息检索与大型语言模型生成相结合的技术架构:系统先从外部知识库中检索出与用户查询相关的文档片段,再将这些片段作为上下文输入给生成模型,由模型基于检索到的证据产出回答。在临床场景中,RAG 的价值在于让模型的回答“有据可依”,降低幻觉风险。检索环节的质量直接决定了生成内容的上限,因此 Recall@K、MRR、nDCG 等检索指标成为评估 RAG 系统的核心工具。但需注意,这些指标衡量的本质是“系统返回结果与标注的相关性集合之间的匹配程度”,而非绝对的临床证据完整性。当标注集合本身不完整时,指标反映的是系统与标注之间的相对一致性,而非系统在真实临床需求下的证据覆盖能力。这正是该研究强调“标注覆盖度”的背景所在。
混合检索配置下的最优表现
在四种检索器配置中,选定的混合检索器配合384 token块大小和20%重叠率表现最佳:18条查询中有17条在top 3结果中检索到了被接受的证据。Recall@3、R-Precision、MRR@3和nDCG@3四项指标均达到0.94。交叉编码器重排序被证实能带来最高的检索分数,这与此前在通用领域观察到的结论一致——精排阶段对语义匹配的精细化校正,在专业医学文本中同样有效。
| 指标 | 数值 |
|---|---|
| Recall@3 | 0.94 |
| R-Precision | 0.94 |
| MRR@3 | 0.94 |
| nDCG@3 | 0.94 |
生成侧则单独在512 token索引、K=1到5的设置下评估,采用DeepEval的claim-level指标,由deepseek广告-v4-pro担任LLM评判员,并辅以BLEU/ROUGE传统指标。这种“检索与生成分开评”的设计,避免了生成质量波动掩盖检索环节的真实问题。
交叉编码器重排序(Cross-Encoder Reranking) 是检索管线中精排阶段常用的技术。与双编码器(bi-encoder)将查询和文档分别编码后计算向量相似度不同,交叉编码器将查询与候选文档拼接后共同输入 Transformer,直接输出相关性分数。这种方式能捕捉查询与文档之间细粒度的语义交互,因此精度更高,但计算成本也更大,通常只用于对召回阶段返回的少量候选(如 top 50)进行重排。本文中,交叉编码器重排序在混合检索(稠密向量 + BM25)召回之后进行,正是这一“粗排召回、精排重排”的典型架构。BM25 负责捕捉关键词精确匹配,稠密向量负责语义召回,交叉编码器则在两者融合的候选集上做精细校正,三者互补共同支撑了 0.94 的检索指标。
标注敏感性:排名不变,但证据识别量变了
研究最值得关注的发现在于标注扩展实验。当真实标注从25个证据片段扩展到37个、可接受块从36个扩展到51个时,检索排名纹丝不动。表面看这是系统鲁棒性的体现,但更深层的含义是:原始标注可能遗漏了大量本应被认定为相关的证据。如果只用初始标注评估,系统检索到的某些块会被判为不相关;而扩充标注后,这些块被重新认定为有效证据。分数没变,是因为排名顺序稳定,但“相关”的绝对数量变了。
这直接指向一个方法论问题:RAG检索评估中的ground truth并非天然客观,它的覆盖范围会系统性影响我们对系统能力的判断。尤其在临床领域,证据片段的边界往往模糊,不同标注者对“充分证据”的理解可能存在差异。
R-Precision 是信息检索评估中的一项指标,定义为在检索结果的前 R 个位置中,相关文档数与 R 的比值,其中 R 等于该查询在标注中实际存在的相关文档总数。举例来说,若某查询共有 3 个相关证据块(R=3),而系统返回的前 3 个结果中有 2 个相关,则 R-Precision 为 2/3≈0.67。该指标的特点是它自动根据每个查询的相关文档数量调整截断位置,因此不像 Recall@K 那样固定 K 值,能更公平地反映系统在“应召回多少就召回多少”条件下的精度。本文中 R-Precision 达到 0.94,与 Recall@3、MRR@3、nDCG@3 一致,说明系统不仅在召回数量上达标,在排序质量上也表现稳定。但正如标注扩展实验所示,R-Precision 的分母 R 直接来自标注,标注覆盖度变化会改变 R 的取值,因此该指标同样对标注质量敏感。
小样本与检索知情标注的局限
作者坦承了两个关键限制。其一,18篇文档、18条查询的开发集规模很小,统计效力有限,结论需要独立验证。其二,标注过程是“检索知情”的——标注者可能受到检索结果的影响,存在循环论证的风险。因此研究明确提出,后续需要放射科医生对证据充分性进行独立评估,而不是仅依赖检索系统返回的片段来定义相关性。
这对临床RAG系统的开发流程有实际启示:在标注阶段就应当引入领域专家,并采用盲于检索结果的标注策略。否则,系统可能在一个被自身输出塑造过的标准上获得高分,却在真实临床场景中暴露证据覆盖不足的问题。
检索知情标注(Retrieval-Informed Annotation) 指的是标注者在标注相关性时已经接触或参考了检索系统的输出结果,从而可能使标注集合无意识地偏向系统已经能检索到的内容。这种做法的风险在于形成循环论证:系统在由自身输出塑造的标准上评估,分数自然偏高,却无法反映系统在未见过的新查询或真实临床场景中的证据覆盖盲区。在 RAG 评估中,理想的做法是采用“盲于检索结果”的标注策略——标注者仅依据原始文档和查询独立判断哪些片段构成充分证据,再由另一组专家对标注一致性进行校验。本文作者明确指出这一局限,并呼吁由放射科医生独立评估证据充分性,正是为了切断标注与检索系统之间的反馈回路,确保 ground truth 的独立性。
对RAG评估实践的启示
这项研究虽然规模有限,但提出的evidence-aware评估协议值得借鉴。它将相关性从文档级下沉到证据片段级,并要求所有包含等价证据的重叠块都被计为相关,减少了分块策略对评估结果的干扰。对于正在构建医学、法律等高 stakes 领域RAG系统的团队,至少有两点可操作的建议:
- 报告标注覆盖度:在公布Recall@K等指标时,同时说明ground truth的规模与来源,便于读者判断分数的可信区间。
- 做标注敏感性分析:在小规模开发集上刻意扩充或收缩标注,观察排名与分数的变化幅度,作为系统鲁棒性的辅助证据。
检索分数从来不只是系统能力的函数,它同样是标注质量的函数。把这层依赖关系显式地纳入评估协议,比单纯追求更高的nDCG更有意义。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。