别再堆工具了:手搓Agent Harness的工程实践
拆解 LLM Agent 的执行外壳 Harness:工具设计、阶段状态机、熔断与可观测性。
文章系统拆解了把语言模型变成 Agent 的关键——包在模型外的 Harness 执行外壳,它负责构建 prompt、定义与执行工具、回灌结果并强制停止规则。内容覆盖:何时该自建 harness(反复出现、需要硬约束的任务);Agent SDK 与裸工具调用循环的取舍(便利性 vs 控制权与可移植性);工具设计的反直觉原则——少即是多,3 到 5 个锋利领域工具胜过 30 个通用工具,且须限制返回体积、把失败转成可读错误;用阶段状态机与宿主侧验证堵住模型抄近路;用 schema 约束与 finish 工具保证结构化输出;四道熔断加重复调用检测防止 agent 打转烧钱;以只追加的 transcript.jsonl 实现可观测与确定性回放测试。最后给出一个 150 行的崩溃分诊实例,并强调保持 KV 缓存热对多轮循环速度的决定性影响。
语言模型本身只会文字进、文字出。它打不开文件、跑不了测试,也不知道任务什么时候算完成。真正把模型变成Agent的,是包在它外面的那层代码——Harness(执行外壳)。这期来自 YouTube 的教学视频把这层"壳"拆得相当透:harness 负责构建初始 prompt、定义模型可以请求的工具、在你的环境中执行每次工具调用、把结果回灌给模型,并强制执行停止规则。
什么时候该自己写 Harness
Claude Code 这类通用编码 harness 适合交互式写代码、调试和临时自动化,开箱即用。但当一个反复出现的任务需要比聊天会话更硬的约束时,就该自己动手了。视频举的例子很具体:夜间崩溃分诊、渲染帧的自动化视觉质检、多步骤迁移流水线。这类任务的共同特征是——你只想要三四个专用工具、固定的阶段顺序、硬性预算上限,以及最后拿到结构化的 JSON 输出。
据该视频的梳理,在 TypeScript 或 Python 里搭 harness 有两条路。一是 Claude Agent SDK,它给你的脚本装上和 Claude Code 同款的引擎与内置工具;二是直接对着 Anthropic Messages API 或 OpenAI、Ollama 兼容端点写一个裸的工具调用循环。两者本质是便利性与控制权的权衡。
Agent SDK 还是裸循环?
Agent SDK 自带文件编辑、搜索、shell 执行、MCP 支持和上下文管理,省去了自己维护文件编辑逻辑的麻烦。裸 API 循环则是一张白纸,发给模型的每一个 token 都在你掌控之中。
视频给出的判断标准是:如果任务"看起来像在仓库里做软件工程"——读文件、改代码、跑测试——并且你不想自己维护文件编辑逻辑,选 Agent SDK。如果 agent 只需要三四个狭窄的领域工具、你想消除隐藏的系统提示开销,或者希望同一份 harness 代码能跑在 Claude、DeepSeek广告、Kimi、GLM 和本地 Ollama 模型上,那就写裸循环。后者的可移植性来自一个事实:Ollama、vLLM 以及各家托管服务都讲标准的 chat completions 工具格式,换个 base URL 和模型字符串,同一套循环就能从本地模型切到云端前沿模型。
用 SDK 时,调用 query 传入 prompt 和 options,然后迭代它产出的异步消息流。每一轮产出助手的思考和工具调用,最后以一条 result 消息收尾,报告最终答案、轮次数和美元成本。视频特别强调要锁死每次脚本化运行的选项:allowed tools 只放开任务需要的工具,设置 max turns 和 max budget USD 防止卡死的 agent 烧穿账单,cwd 指向隔离的工作树。还可以用 tool 和 createSdkMcpServer 挂载进程内的自定义工具,输入 schema 用 TypeScript 的 Zod 或 Python 的 Pydantic 定义。要强制硬边界,就在脚本里传 canUseTool 回调或 pre-tool-use hook——模型改文件或跑命令前,回调先检查参数,要么放行,要么带理由拒绝。
工具调用循环(Tool-calling loop) 是大模型 API 的一种标准交互模式:请求体里带上 tools(或 functions)数组,每项声明工具名、描述和 JSON Schema 参数;模型不直接回答,而是返回一个 tool_calls 结构,宿主代码按 name/arguments 执行对应函数,再把结果作为一条 role: "tool" 的消息追加回 messages,再次发起请求。这个"请求—执行—回灌"的往返就是文章所说的"循环",何时停止完全由宿主代码判断(模型不再请求工具、达到轮次上限、或调用了 finish 工具)。OpenAI 兼容端点、Ollama、vLLM 都遵循这套格式,因此同一份循环代码只需更换 base URL 与模型名即可迁移。
MCP(Model Context Protocol) 是一种开放协议,用统一的方式向模型客户端暴露工具、资源和提示模板,常被称作"AI 应用的 USB-C 接口"。服务端声明能力清单,客户端(如 Claude Code、Agent SDK)在启动时拉取并转换成模型可调用的工具定义。它的价值在于工具实现与 harness 解耦:同一个 MCP server 可以被不同 harness 复用,也能跨进程、跨语言部署。文章提到 Agent SDK 内建 MCP 支持、并可用 createSdkMcpServer 挂载进程内自定义工具,指的正是这种把工具注入循环的标准化通道。
工具设计:少即是多
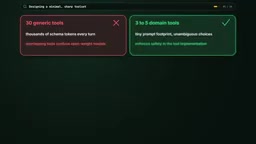
这一节是全文最有反直觉价值的洞见。给模型 30 个通用工具,每一轮都会塞进成千上万的 schema token,还会让小模型或开放权重模型选错工具。3 到 5 个锋利的小工具,胜过 30 个含糊的大工具。 用领域动作替代裸 shell 访问:与其给崩溃分诊 agent 一个 bash 让它自己写安全命令,不如提供 get_stack_trace、blame_file_range、read_source_lines。
工具返回必须设上限。搜索命中 5000 行日志时,只返回前 100 行,外加一条清晰说明告知总数和如何请求下一个偏移量,这样一次吵闹的工具调用不会撑爆上下文窗口。工具调用失败时(比如模型传了不存在的文件路径),不要抛出未处理异常把整轮跑崩,而是捕获错误、返回一段简短的错误字符串,告诉模型哪里错了、下一轮该怎么修正参数。
用阶段状态机堵住模型的"抄近路"
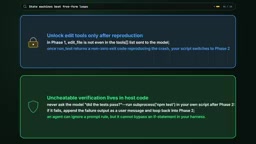
在自由循环里、第一轮就解锁所有工具,模型会抄近路:没复现 bug 就先改代码,或者没跑测试套件就停下。宿主代码里的阶段状态机能让这些捷径变得不可能。把任务拆成显式阶段,比如复现、修复、验证,每个阶段只暴露属于它的工具。第一阶段模型只有读工具和测试运行器;harness 盯着测试退出码,只有测试真的失败了,才在第二阶段解锁文件编辑工具。
最终验证也别指望模型自觉。当模型说修好了,宿主脚本直接跑类型检查、linter 和测试套件。任何一项失败,脚本就把错误输出回灌到第二阶段。视频里那句话值得抄下来:agent 可以忽略 prompt 里的指令,但它跳不过 harness 里的一个 if 语句。
结构化输出与电路熔断
当 harness 跑在更大的流水线里,下一步是另一个脚本而不是人,从对话式 markdown 代码块里抠 JSON 就很脆。应强制输出 schema:Agent SDK 里传 output format 加 JSON schema,Ollama 或 OpenAI 兼容 API 里传 response_format,推理引擎会约束 token 生成,保证最终回复是符合 schema 的合法 JSON。更硬核的模式是给 agent 一个专门的 finish 工具,参数就是你要求的报告 schema。模型调用 finish 时,harness 校验 payload 并检查自身状态——每个必答清单项都答了吗?验证测试过了吗?没过就用工具错误拒绝 finish,点名缺什么,agent 必须干完活才能退出。
无人值守的 harness 迟早会遇到让模型原地打转的任务。没有硬性熔断,卡死的 agent 会一直烧 token 直到超时。四道保险:轮次上限设在 10 到 15 轮;每轮后检查累计 token 或美元成本;每次工具执行和模型请求都包一层超时;文件编辑类 harness 跑在临时工作树或容器里。再加一道重复调用熔断:对每轮的工具名和参数做哈希,如果模型连续两次用完全相同的参数调用同一个工具,或者连续三次撞上同一个测试失败,就注入警告逼它换思路,或者干净地中止并保存状态。
约束解码(Constrained / Structured Decoding) 是推理引擎层面的技术:把 JSON Schema 或正则编译成状态机或语法,在每个解码步屏蔽掉会导致输出不合法的 token,从而在生成过程中就保证结果合法,而非事后解析再重试。OpenAI 的 response_format、vLLM 的 guided decoding、Ollama 的 format 参数都属此类。它解释了文中"推理引擎会约束 token 生成"一句——合法 JSON 不是请求模型配合,而是解码器在物理上排除了非法路径。需要注意的是,约束越严,模型可用于"思考"的自由度越低,复杂 schema 有时会降低输出质量,因此更硬核的 finish 工具模式常被作为替代。
可观测性:把每一轮都记下来
凌晨三点一次 12 轮的任务在第 3 轮就失败了,只记录最终错误,你只能对着结果猜第 4 轮发生了什么。每个 harness 都应在运行时写一个只追加的 transcript.jsonl,每行一个 JSON 对象,记录轮次号、模型名、输入输出 token、延迟、请求的确切工具调用和返回的确切结果。
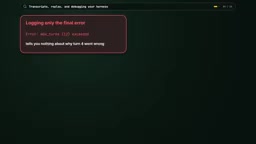
读两三份 transcript 就能立刻看出该怎么改。如果 agent 每次运行都浪费四轮去找同一个配置文件,就把那个路径写进 prompt;如果某个工具的输出格式误导了模型,就改工具。把 transcript 里记录的工具结果回放进单元测试,还能以零 API 成本确定性地测试 harness 状态机。
一个 150 行的崩溃分诊实例
视频最后给了一套完整拼装。夜间测试或生产任务崩溃时,harness 自动跑三阶段。阶段一用快速开放权重模型在只读循环里配三个工具:get_stack_trace、git_blame_range、read_lines,然后调用 finish 给出结构化假设——可疑文件、行范围、肇事提交。阶段二创建临时 git worktree,启动 Claude Agent SDK,上限 10 轮、2 美元,先写一个失败的回归测试,再打补丁。阶段三是纯宿主代码:harness 自己跑完整测试套件和类型检查,把 git diff 发给另一个实验室的审查模型,两道关卡都过了才保留分支。早上你拿到的不是一段含糊的聊天记录,而是 result.json、完整的 transcript.jsonl,以及一个验证过、可直接审查的分支。
第一个 harness 的建议很朴素:别上重框架。从一个反复出现的任务开始,三个锋利工具,一个带 10 轮上限的阶段循环,加一份 JSONL transcript。
性能细节:让 KV 缓存保持热
有个细节决定多轮循环是快是慢:保持 KV 缓存热。永远不要重排工具定义,永远不要往系统提示里注入时间戳,只往 messages 数组末尾追加,这样每一轮都能复用上一轮的缓存前缀。这一条在多模型、多轮次的 harness 里往往比换模型更能影响体感速度。
KV 缓存(Key/Value Cache) 是 Transformer 推理的核心优化:自回归生成时,每个 token 的注意力键值对可被后续 token 复用,无需重算前缀,从而把每步计算从 O(n²) 降到 O(n)。多数厂商的 prompt caching 按"前缀匹配"计费与加速——只要新请求的 token 序列与上次共享同一前缀,命中部分即可跳过预填充(prefill)。这正是文中三条禁令的由来:重排工具定义会改变前缀顺序,注入时间戳会让前缀逐轮失效,而只向 messages 末尾追加则能最大化复用。命中缓存不仅更快,输入侧计费通常也显著更低。
相关推荐

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。

黄仁勋若卸任,英伟达AI帝国将何去何从?
英伟达的AI霸权是否过度依赖黄仁勋个人?本文分析硅谷对CEO的个人崇拜现象,探讨英伟达技术护城河与组织风险,以及AI产业为何需要摆脱救世主叙事。

2026科技诉讼风向标:立法者欲收紧AI与平台责任
2026年科技诉讼成为焦点:美国参议院司法小组委员会听证会推动限制在线平台强制仲裁,并加强对深度伪造创作者的追责,科技平台与AI工具面临责任重构。