别再用蠢模型:为什么前沿AI的"下限"比"上限"更重要
前沿AI编程模型的真正价值在于抬高"下限"(更少犯蠢),而非提升峰值能力,这一优势随任务宽度延伸呈指数级放大。
一位AI开发者针对"换用旧模型感觉没差别"的观点提出反驳,核心论点是:评价AI编程模型应关注其最差表现(下限)而非峰值能力(上限)。他引入"prompt宽度"概念——即任务涉及的步骤数量与从问题到解决方案的跨度——指出宽任务对模型下限要求极高。通过真实日志数据,他展示了Agent运行时长从数月前的中位数53秒增长到2分20秒、P95从7分钟翻至16分钟的变化,并用串联成功率数学模型说明:单步失败率从5%降至3%这一"微小改善",在四小时尺度上会放大为20%的整体成功率差异。那些感知不到新模型优势的顶尖工程师,往往因已脱离日常编码、prompt停留在"旧写法",而未能触及新模型真正拉开差距的任务宽度区间。
一位知名AI开发者兼YouTube博主在最新视频中直接向Sentry创始人David Cramer(Zeeg)开炮,起因是后者的一条观点:使用Fable或Astra这类高端模型的人,不妨切回Opus、Sonnet等高推理模型,"你多半会发现任务表现没什么区别"。视频作者的回应毫不客气——"这是你有史以来最烂的观点",并借此展开了一场关于"如何正确使用编程Agent"的深度讨论。
这场争论的核心,其实触及了大多数工程师对AI编程模型的根本误解。
争论的起点:模型换代真的没差别吗?
视频作者坦言,之所以要做这期内容,是因为看到太多工程师在评论区里表达出与Cramer类似的观点——换回上一代模型、或降一个档位使用,感觉不出差别。他的判断很直接:如果你真有这种体验,"说明你的prompt写得很烂"。
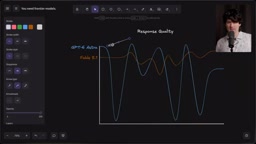
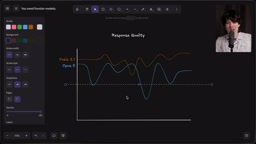
他特意区分了两个层次的问题。Astra与Sonnet之间的对比,与Fable对阵Opus、Sonnet的情况完全不同。Astra能做到史上任何模型都做不到的事,但也会犯下"自2025年认真使用Gemini以来就没见过"的低级错误。正因为Astra表现如此不稳定——时而惊艳,时而愚蠢——它反而让整场讨论变得难以聚焦。所以他在视频里干脆把Astra从图表中删掉,直言那些糟糕表现的时刻"和Flash没两样"。
他承认自己也犯过这类错误:曾经只盯着某个模型(比如Opus 5)的最佳表现,误以为它很好,实际上它出错的频率远超预期。
天花板 vs 地板:被忽视的模型"下限"
视频最有价值的洞见在于:大多数人评估模型时过度关注"天花板"(最佳表现),却严重忽视"地板"(最差表现)。
作者的核心论点是——提升下限比提升上限更有价值。"我不在乎模型能不能解新奇的数学难题,如果它连我说'revert'是什么意思都搞不懂。"他举了个扎心的例子:Astra真的曾困惑于"revert"这个词的含义,也曾无法把一个图标在div里居中。
他因此提出一个关键区分:"我喜欢Fable不是因为它更聪明,而是因为它更少犯蠢。'更少犯蠢'和'更聪明'几乎是相反的两件事,处在能力光谱的两端。"前沿模型真正的特别之处,正是它们触碰"愚蠢下限"的频率更低,且整体地板被显著抬高了。
关键概念:prompt的"宽度"而非"难度"
作者引入了一个精妙的框架来解释分歧的根源——prompt的宽度(width)。
他解释道,宽度不是指任务的难度或深度,而是指"要做的事情的数量,以及从起点到终点的距离"。更宽的prompt需要更高的模型下限来支撑。
他坦承Cramer在某种场景下是对的:如果你的目标只是"从Jira工单到代码"——给出格式良好的工单、列明文件路径和预期行为,那么Opus、Fable甚至Gemini都能相对可靠地完成,差别确实不大。
但他真正兴奋的能力完全不同:"我在手机上收到用户报告的bug截图,直接粘贴给T3 Chat里的Agent,说'修好它、测试它、录个视频证明能用、完事后把PR链接发我,盯着它直到review里所有问题都解决'。"这个端到端流程本身并不比编辑Jira工单更难,但它的"宽度"要大得多——模型需要在无人干预下从模糊的问题描述走到可运行的解决方案。
对于token成本,他的态度很明确:"token是贵,可我的工程师和时间更贵。如果Julius靠花token能提效三倍,这是笔稳赚的买卖。"
prompt"宽度"这一概念与AI研究中常讨论的**任务视野(task horizon)**高度重合。任务视野指模型在不寻求人类反馈的情况下能够独立完成的操作步骤数。学术界用它衡量Agent的自主能力边界:视野短的模型只能处理单步指令,视野长的模型才能在多步骤、跨工具、跨文件的场景中保持目标一致性。"宽prompt"在实践层面等价于要求更长的任务视野——从模糊的问题描述出发,经历代码定位、修改、测试、提交等多个子阶段,全程无人工干预。这也是为什么作者强调"宽度"而非"难度":一个问题可以认知难度不高,但因为步骤多、上下文复杂,同样对模型的持续推理能力和错误恢复能力提出严苛要求。
两个核心指标:运行时长与"人介入时的正确率"
作者提炼出评估Agent能力的两个关键维度:模型能在无输入下运行多久,以及人再次介入时任务已经正确的概率有多高。
他还分享了一个反常识的做法——不再watch(盯着)Agent工作,也不再在prompt里提及具体文件名。他做了两个观众投票,结果让他一度"失望"又一度"欣慰"。他鼓励开发者"推高对Agent的信任边界",只在第一次输出严重错误时才介入观察,因为观察的真正价值在于"学习它为什么出错"。
他引用了同行Jamin的观点:做通宵自主运行不是为了产出大量代码,而是为了触发一堆失败案例,从而重构代码库和系统。一个精辟的类比是:"如果你把一位从没接触过你代码库的资深开发者放进来,到下班时他还贡献不了代码,那是你代码库的问题,不是Agent的问题。"
用数学证明"指数级"提升
面对有人质疑"指数级"提法夸张,作者拿出了自己的真实日志数据。
从3月到现在,他的prompt运行时长中位数从53秒增长到2分20秒,翻了一倍多;P95从不到7分钟涨到超过16分20秒。而在Fable和Sonnet发布的6月节点,最长5%的请求时长从12分钟跃升到22分钟,几乎月度翻倍。
他用一段简单的数学揭示了为何"下限的小幅改善"会带来"运行时长的指数级增长":假设某模型在10分钟窗口内有5%的失败率(即95%成功率),运行30分钟就是0.95的三次方;跑一小时失败率飙到73%,两小时约50%,四小时只剩30%成功率。
关键在于——如果把每10分钟的失败率从5%降到3%,四小时的失败率就从70%骏降到50%。"这2%的改善,在四小时尺度上被放大成了20%的差异。"这正是他强调"下限影响呈指数级放大"的数学依据。
聊天区有观众附和称自己的运行时长"从5-15分钟提升到1-4小时"。作者甚至提到自己有过连续运行两天无干预的案例。
这一数学逻辑本质上是可靠性工程中的串联系统模型。若将一次长时间Agent运行拆分为若干个独立时间窗口,每个窗口的成功率为 p,则 n 个窗口全部成功的概率为 pⁿ。这与工业系统中计算"平均无故障时间"(MTTF)的思路一脉相承:单个组件的微小可靠性提升,在多组件串联后会产生非线性的整体收益。对软件Agent而言,每一次工具调用、每一次上下文切换都是一个潜在的失败节点,因此"下限"(即单步最低成功率)才是决定长程任务完成率的瓶颈变量,而非模型在某个困难子任务上的峰值表现。这也解释了为什么在短任务中感知不到模型差异的开发者,一旦将任务窗口拉长到数小时,差距就会以指数形式放大并变得无法忽视。
为什么顶尖开发者反而看不到差别
视频结尾,作者提出了一个耐人寻味的观察:为什么像Cramer、David K(xstate作者)这样极具才华的工程师反而感受不到新模型的优势?
他的解释是——这些技术领袖大多已经离开了日常编码,把精力放在"编码之前的准备"和"编码之后的验证"上。他们当年正是靠强化这两端才从优秀贡献者成长为优秀领导者,因此更难放手。"他们在用模型对抗一件他们自己早已不做的事——写中间那段代码,而模型几个月前就能做好了。他们没错,但一旦让模型往前后两端多走一步,就会立刻看到边界近得多。"
换句话说,他们的prompt还停留在"二月的写法",本质上是没有正确地为自己的时间定价。
作者的建议清晰而务实:如果你的任务不是那种极窄、极短的类型,就该努力让单个prompt用满模型能力的窗口,通过改造代码库或规避模型薄弱环节来"抹平粗糙地带",从而让Agent运行得更久、更少需要指导。他提到团队成员Maria花了三四天研究traces、打磨skills,如今"一个prompt就能让PR直接落地"。
核心结论:评价模型不要看它的峰值能力,而要看它最差时的表现。当你把任务变得更"宽"而非更"难",前沿模型抬高的"下限"会带来指数级的实际收益。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。