别再用Claude和ChatGPT了?Hermes自托管AI代理方案解析

企业分散使用Claude和ChatGPT导致上下文割裂,应改用分层代理、GitHub第二大脑与VPS自托管架构。
文章介绍了AI顾问Gui Costa的观点:企业若仍让员工各自使用Claude或ChatGPT,会因账户分散导致上下文缺失、工具连接碎片化、权限与安全治理缺位。他提出的Hermes方案保留现有模型作为界面,在其背后建立公司级代理体系:顶层编排者代理掌握全局,部门代理按需连接CRM、销售工具并隔离权限;用GitHub私有仓库构建存储公司上下文的“第二大脑”,实现输出具体化与模型解耦;代理运行在VPS的Docker容器中,按规模选择规格。代理可嵌入Slack等工具供团队共享调用。作者也提醒自托管带来运维、安全与治理的隐性成本,架构骨架之外细节需企业自行补齐。
一位名为Gui Costa的AI系统实施顾问在YouTube视频中提出一个观点:如果公司仍在用Claude或ChatGPT处理业务任务,可能正错过AI-first公司已经获得的成果。他的核心主张是——问题不在于模型本身,而在于公司使用AI的方式过于分散,缺乏治理与统一上下文。
当前企业使用AI的典型困境
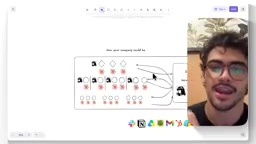
Gui Costa用一张组织架构图描述了多数公司的现状:董事、经理、员工各自在个人电脑上使用自己的Claude或ChatGPT账户。即便公司统一付费,每个人仍有独立的项目、工具连接和技能配置,信息被割裂在各个账户中。
这种分散模式带来一连串问题。首先,AI无法获得完整的公司或项目上下文,回答趋于泛化。其次,工具连接支离破碎——Google Drive、Slides、网站SEO、SEMrush等工具无法在统一视图中协同。项目协作也难以实现,每个人在自己的项目里工作,无法共享同一账户下的上下文。
更关键的是治理与安全缺口。所有人访问相同信息,没有权限分级;员工将密码和敏感数据输入AI的过程不可见;管理者也无法确认一份文案究竟由AI生成还是人工撰写。Gui Costa强调,公司规模越大,这些问题越严重。
Hermes方案的核心:代理、第二大脑与VPS
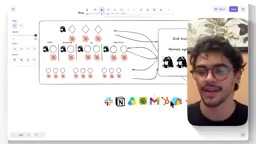
Gui Costa提出的替代架构并不复杂:保留Claude和ChatGPT作为交互界面,但在其背后建立一套公司级的代理(Agent)体系。每个代理拥有特定技能、上下文和工具访问权限,像员工一样为全公司服务。
编排者代理与部门代理
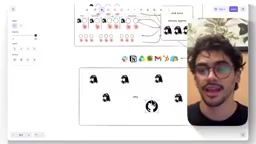
在他推荐的架构中,最上层是一个面向董事会的“编排者”(Orchestrator)代理,掌握公司全貌、可访问所有文档,并能看到其他代理和员工用AI产出的内容。下一层则按部门划分——销售代理连接CRM、HubSpot、Pipedrive、Clay、Instantly、Apollo等GTM工具;运营代理连接HubSpot但不接触销售专用工具;每个代理只拥有完成本职所需的最小权限和上下文。
这种设计的关键在于权限隔离:销售团队不需要访问员工薪资数据,运营团队也不需要看到销售侧的全部细节。代理通过API或MCP与公司工具连接,会议转录工具(如Granola、tl;dv)同样接入代理,而非散落在每个人手里。
MCP(Model Context Protocol)是Anthropic于2024年底推出的一种开放协议,用于标准化AI模型与外部数据源、工具之间的连接方式。可以把它理解为AI世界的“USB接口”:无论后端是本地文件、数据库、CRM还是第三方SaaS,只要实现MCP服务端,模型就能以统一方式发现并调用这些能力。文中代理“通过API或MCP与公司工具连接”,意味着代理不必为每个工具单独开发集成逻辑,而是复用MCP生态中已有的连接器,降低了接入与替换成本。MCP本身与模型无关,Claude、GPT等均可作为客户端使用,这也是作者强调模型解耦的技术基础之一。
第二大脑:用GitHub承载公司上下文
Gui Costa反复强调“第二大脑”的概念——一个存储公司全部上下文的知识库,涵盖客户、部门、员工等信息。没有第二大脑,代理就只是通用聊天机器人;有了它,AI的输出才能从泛化走向具体。
他的实际做法是用GitHub私有仓库承载第二大脑。理由是GitHub免费、对代理友好、便于治理。不同仓库对应不同权限:公司级大脑仅编排者代理可访问,销售代理有自己的独立仓库,备份代理则负责将编排者的产出同步回主仓库。这一设计也带来抗脆弱性——如果未来Claude或ChatGPT涨价、降智或停服,公司上下文仍安全存放在GitHub中,可随时切换模型继续对话。
“第二大脑”(Second Brain)源自个人知识管理领域的概念,指将分散的信息外部化、结构化存储,以减轻记忆负担并支持检索与推理。在企业AI语境下,它指一个集中存放公司事实、流程、客户资料与决策记录的知识库,作为代理的检索增强(RAG)来源。代理每次回答前先从第二大脑中检索相关上下文,再结合模型能力生成结果,从而避免“泛化回答”。其质量取决于内容的组织方式——结构清晰、粒度适中、持续更新,否则检索到的只是噪声。文中的GitHub仓库方案本质上是用版本控制来管理这份知识资产。
VPS:代理的运行底座
代理需要一台始终在线的云端计算机。Gui Costa推荐使用VPS,并在其中通过Docker运行多个代理。他给出的资源估算较为具体:每个代理通常需要2至2.5GB内存;KVM 1规格可跑1至2个代理,KVM 2可跑3至4个,KVM 4可跑8个,KVM 8面向代理数量多、任务密集的公司。小公司建议KVM 2,中型公司建议KVM 4或KVM 8。
在托管商选择上,他提到自己与客户使用Hostinger,并说明安装流程为选择服务器位置、Ubuntu系统、设置root密码、启用Docker Manager与恶意软件扫描。需要说明的是,这是视频作者的个人推荐,不同托管商在价格与规格上存在差异,读者应按实际需求评估。
Docker是一种容器化技术,将应用及其依赖打包成轻量级、可移植的容器,在同一台服务器上相互隔离地运行。文中“通过Docker运行多个代理”,意味着每个代理拥有独立的运行环境与资源配额,一个代理崩溃或存在安全漏洞时不易波及其他代理,同时便于版本回滚与批量部署。对于自托管AI代理而言,容器的隔离性也是权限边界的一部分:不同代理可挂载不同仓库、持有不同密钥。代价是需要额外学习容器编排、镜像更新与日志管理,这正是文中提醒中小企业评估的隐性运维成本。
为什么选择Hermes而非在Claude内建代理
Gui Costa承认,Claude、ChatGPT、Grok目前都能创建代理。但他主张使用Hermes或OpenClaude这类方案,核心理由是模型独立性:代理的智能层不应被单一LLM绑定。如果代理和第二大脑都建在Claude内部,一旦Claude在价格或能力上发生变化,公司将处于被动。通过Hermes将代理层与模型层解耦,切换成本大幅降低。
这一观点有其合理性,但也需客观看待:自托管方案意味着公司需要自行承担运维、安全加固和故障排查责任,对缺乏技术团队的中小企业而言,隐性成本不可忽视。视频对此并未展开讨论。
在Slack等沟通工具中直接调用代理
部署完成后,公司成员不必打开Claude或ChatGPT,而是可以在Slack、WhatsApp、Telegram、Microsoft Teams或Google Chat中直接与代理对话。Gui Costa展示了自己公司的Slack频道:按SEO、销售等职能划分频道,各团队只能访问对应频道,代理则在频道内响应。他还演示了一个广告投放代理,能够在Slack中创建、暂停和继续广告活动,全程对团队可见。
这种把AI嵌入现有工作流的思路,比要求员工切换到一个新聊天窗口更贴近实际协作场景。代理不再是个人工具,而是团队共享的“同事”。
实践前的冷静评估
Gui Costa的方案提供了一个清晰的企业级AI架构思路:代理分层、权限隔离、上下文集中、模型解耦。对于已在使用Claude或ChatGPT但苦于结果泛化的团队,这套框架值得参考。
不过在落地前,有几个问题需要自行回答:公司是否具备维护VPS和Docker的基本能力;第二大脑的权限设计是否经得起审计;代理接入CRM和邮箱后的数据边界如何划定;以及当代理数量增长时,谁来负责提示词与技能的版本管理。视频给出了架构骨架,但治理细节仍需结合公司实际补齐。
工具选择从来不是终点。Hermes或类似方案的价值,在于迫使公司认真思考AI时代的组织上下文与权限结构——这或许比换一个工具更重要。
背景补充
自托管AI代理的常见安全风险值得单独说明:一是提示词注入,外部文档或网页中可能藏有恶意指令,诱导代理泄露上下文或执行越权操作;二是密钥管理,代理连接CRM、邮箱需持有凭证,若以明文写在容器配置中,一旦仓库或服务器泄露即全面失守;三是审计缺失,代理自主执行暂停广告、发送邮件等动作时,若无日志记录则难以追责。缓解手段包括为每个代理分配最小权限令牌、对工具调用设置人工确认环节、将操作日志写入只追加的存储,以及定期轮换凭证。这些措施在架构设计阶段就应纳入,而非事后补救。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。