billion-context:上下文压缩插件,省5倍token撑起数月级会话

开源插件billion-context通过上下文压缩技术,让100K窗口实现等效超长会话并节省5倍token开销。
billion-context是一个用TypeScript编写的开源上下文压缩插件,针对大模型对话中上下文窗口被历史信息填满的普遍痛点,以"小窗口、省token、长会话"为核心卖点切入上下文管理领域。其技术思路介于RAG检索增强与滑动窗口丢弃之间:通过压缩冗余历史信息而非删除或外挂数据库,理论上可在100K上下文窗口内实现等效的超长记忆,同时将token消耗降至原来的五分之一。项目在GitHub上已获735 Stars,单周新增246颗,增长势头明显。但"5倍省token"和"数十亿token单会话"等宣传数字目前缺乏可复现的基准测试支撑,激进压缩在高保真度场景下的信息损失风险也需审慎评估,建议开发者先以自身场景小范围验证后再决定是否采用。
当上下文窗口成为瓶颈
长时间与大模型对话的人都会遇到同一个麻烦:上下文窗口被填满。无论是代码助手还是长篇对话场景,随着交互轮数增加,历史信息不断堆积,模型要么开始遗忘早期内容,要么因为token预算耗尽而被迫截断。开源项目 billion-context 正是针对这一痛点而来——它以一个上下文压缩插件的身份,试图在有限的窗口里塞进更多有效信息。
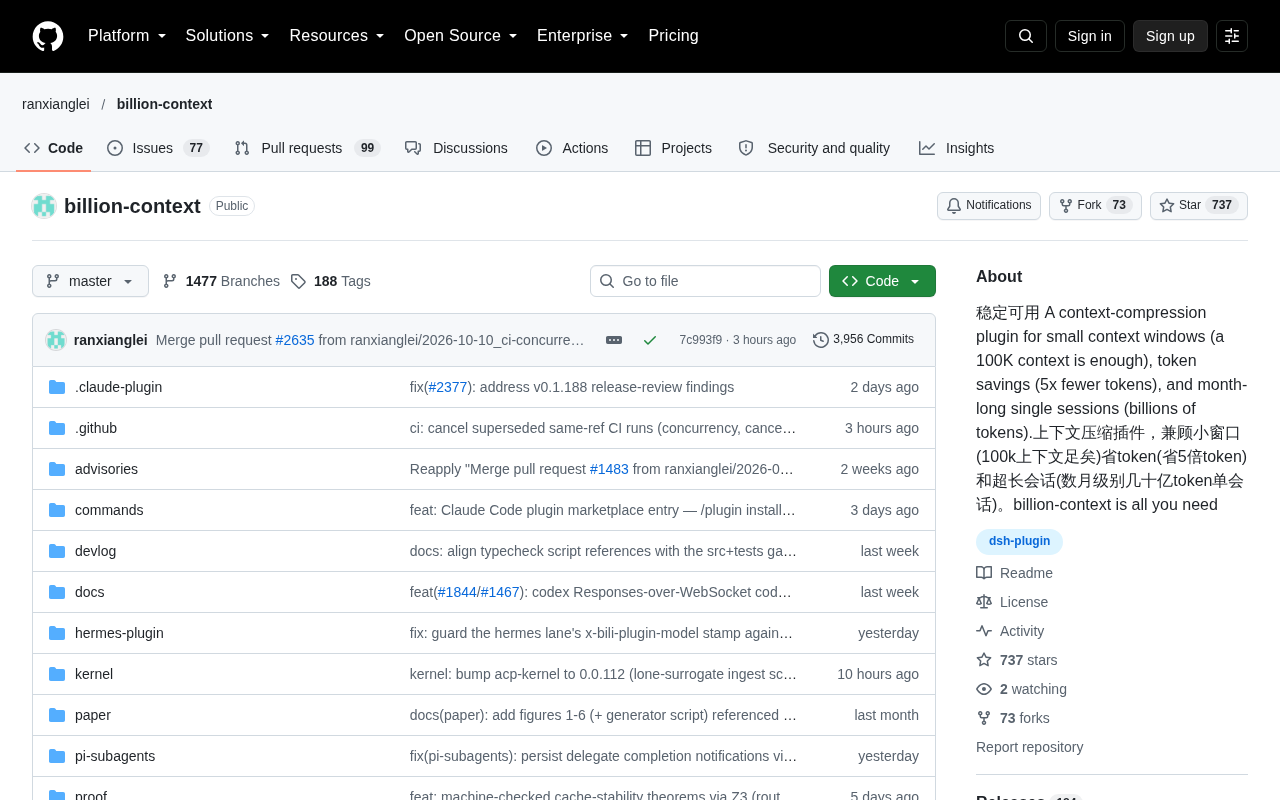
该项目由开发者 ranxianglei 维护,使用 TypeScript 编写,目前在 GitHub 上已获得 735 Stars、73 Forks,且单周新增 246 Stars,增长势头相当明显。项目口号颇为自信:"billion-context is all you need",直接化用了那篇著名论文的句式。
核心卖点:三个数字
billion-context 把自己的价值浓缩成了三组数据,理解它们基本就理解了这个工具的定位。
100K 上下文足矣
项目强调"小窗口即可",宣称 100K 的上下文窗口就足够应对实际需求。这背后的逻辑是:与其一味追求模型本身支持的超大窗口(动辄百万token),不如通过压缩技术让较小的窗口承载等效的信息量。对于那些受限于模型能力或成本预算、无法随意使用超长上下文的用户来说,这是一个务实的切入点。
省 5 倍 token
压缩带来的最直接收益是token节省,官方给出的数字是"5x fewer tokens",即在同等任务下token消耗可降至原来的五分之一。对高频调用API的开发者而言,token就是真金白银,5倍的节省意味着调用成本显著下降,这也是该工具最具吸引力的实用价值。
Token是大语言模型处理文本的基本计量单位,粗略来说英文约每0.75个单词对应一个token,中文约每1-2个汉字对应一个token。主流商业API(如OpenAI、Anthropic)按输入与输出的token总量收费,长对话中历史消息的输入token往往占据大头。以GPT-4o为例,输入token价格约为每百万token 2.5美元,一个包含50轮对话、每轮平均500 token历史的会话,仅上下文部分每次调用就消耗约25,000 token。若压缩率达到5倍,同等历史仅需5,000 token,规模化调用后的费用差距相当可观。不过"5倍"这一数字高度依赖原始对话的冗余程度——对话越啰嗦、重复越多,压缩收益越大;对话本身已高度精炼时,压缩空间则相当有限。
数月级单会话
最激进的宣传点是支持"数月级别、几十亿token的单一会话"。通过持续压缩历史上下文,理论上可以让一个会话长期保持活跃而不丢失关键记忆。这对需要维持长期上下文的应用场景——比如长期项目协作、持续性的智能体任务——是极具想象空间的能力。
压缩思路的意义
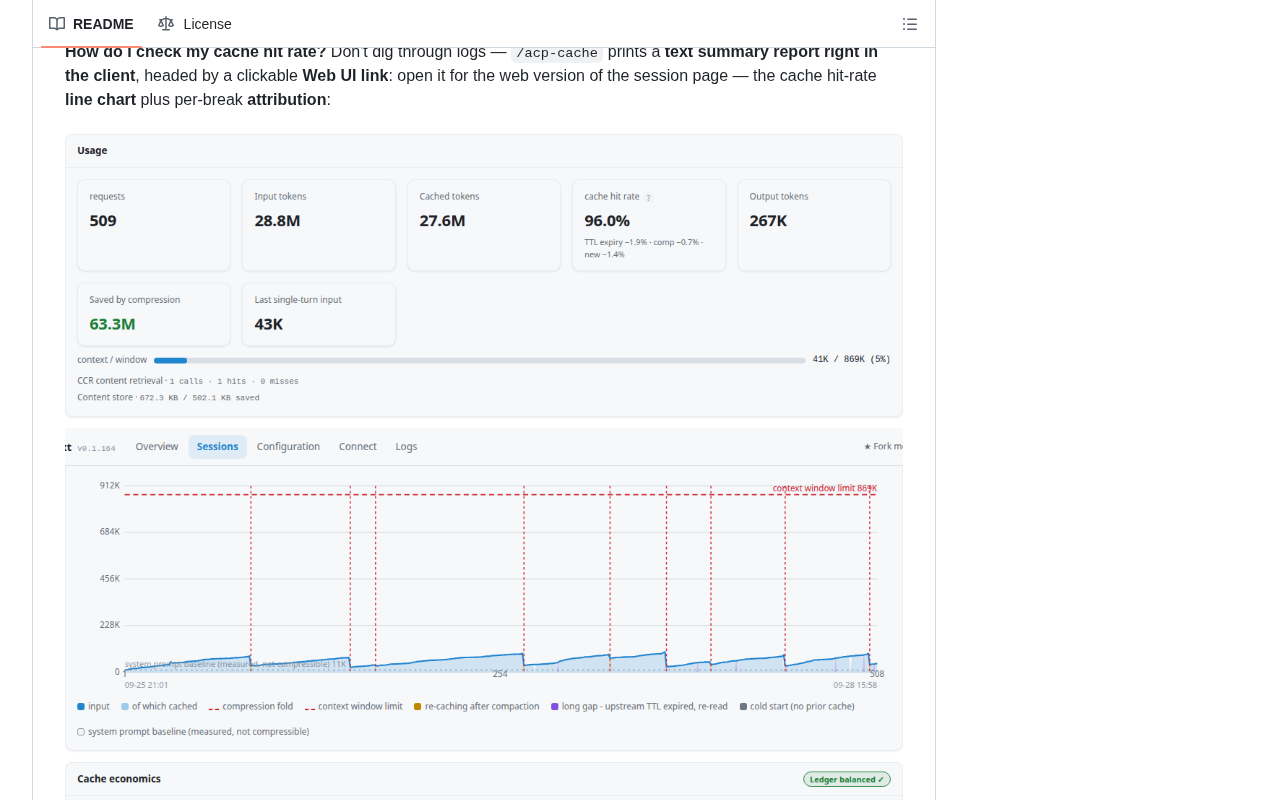
上下文压缩本质上是在信息密度与完整性之间做权衡。模型窗口再大也有上限,而真正影响效果的往往不是"记住多少",而是"记住的是否关键"。billion-context 的方向,是把冗余、过时的历史信息压缩掉,保留对当前任务真正有用的部分,从而在不扩大物理窗口的前提下延长有效记忆。
这一思路与业界近期的几种做法呼应:有的方案靠外挂向量数据库做检索增强(RAG),有的靠滑动窗口丢弃旧信息,而压缩插件走的是中间路线——既不完全丢弃,也不无限堆积,而是把信息折叠得更紧凑。对于集成到现有工作流的开发者来说,插件形式意味着较低的接入成本,这也是它能快速积累关注的原因之一。
RAG(检索增强生成)通过将历史信息向量化存入外部数据库,在需要时按语义相似度检索召回,优点是理论上可存储无限历史,缺点是检索结果依赖查询质量,容易遗漏隐性相关内容。滑动窗口则更为粗暴,直接丢弃超出窗口的最旧内容,实现简单但会造成不可逆的信息丢失。上下文压缩走第三条路:将多轮对话中的冗余表述、重复确认、过时中间步骤等内容"折叠"为更精炼的表示,类似对会议记录做摘要提炼而非删除原始页面。这一做法的技术挑战在于压缩算法本身——如何判断哪些信息"冗余"、哪些"关键",本质上仍是一个语义理解问题,通常需要借助另一个LLM调用来完成摘要或蒸馏,这也意味着压缩本身并非零成本,实际节省的token量需扣除压缩过程自身的消耗。
需要理性看待的部分
必须指出,项目目前提供的信息更多停留在宣传层面,"5倍省token"和"几十亿token单会话"这类数字缺少公开的、可复现的基准测试细节佐证。压缩不可避免地伴随信息损失,压缩率越高,关键信息被误删的风险也越大。在复杂推理、精确引用等对上下文保真度要求高的场景下,激进压缩是否会影响最终输出质量,仍有待实际验证。
此外,TypeScript 实现意味着它天然适配 Node.js 和前端生态,但对 Python 为主的 AI 工程栈可能需要额外的集成工作。使用前建议结合自身的实际任务,先在小范围验证压缩效果与质量损失的平衡点,再决定是否大规模采用。
小结
billion-context 抓住了一个真实且普遍的痛点,用"小窗口、省token、长会话"三个清晰卖点切入上下文管理这一热门领域,并在短时间内获得了社区的积极反馈。它代表了一种值得关注的工程方向:不是把窗口做得更大,而是把信息用得更省。对于被token成本和会话长度困扰的开发者,这是一个值得纳入观察清单的开源工具,但在落地前仍需用自己的场景做一次实打实的检验。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。