BitLens:可视化神经网络量化分析利器

BitLens 用单次校准实现逐层量化敏感度分析,并一键导出多框架量化配置。
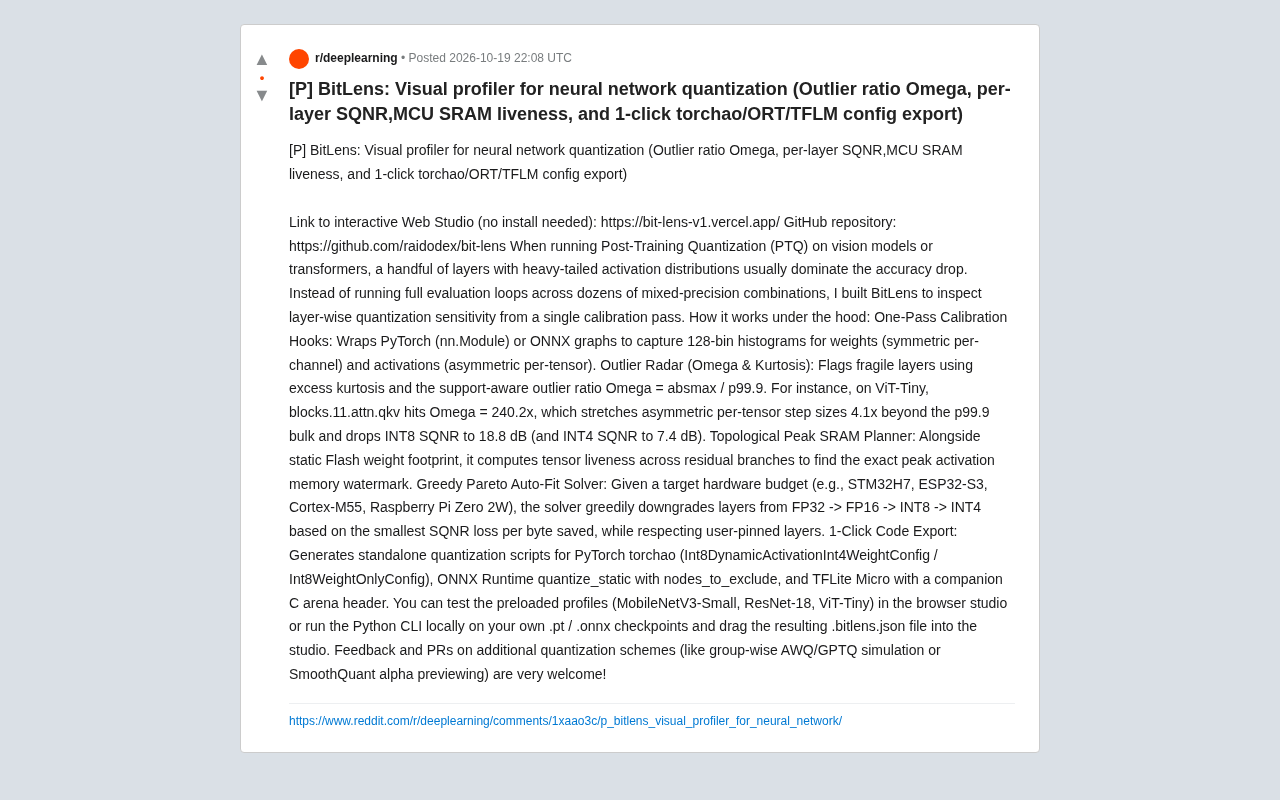
BitLens 是 Reddit 社区开源的一个量化调试工具,旨在解决训练后量化中精度骤降却难以定位问题层的痛点。它通过钩子包裹 PyTorch 或 ONNX 计算图,单次校准即采集权重与激活的 128-bin 直方图,并计算离群比 Omega 与超额峰度来识别重尾激活导致的脆弱层,同时给出逐层 SQNR 诊断。工具还包含拓扑峰值 SRAM 规划器和贪心 Pareto 求解器,可在目标硬件预算下自动生成混合精度方案并支持锁定层。分析结果可一键导出为 torchao、ONNX Runtime 和 TFLite Micro 的量化脚本或配置。BitLens 定位为量化前的快速筛查与配置生成器,适用于 PTQ 场景,但不能替代端到端精度验证。
量化是边缘AI部署绕不开的一环,但真正让工程师头疼的,往往不是量化本身,而是量化之后精度为何骤降。传统做法是跑遍几十种混合精度组合做完整评估,耗时且难以定位问题层。Reddit社区近期出现的一个开源项目BitLens,试图用一次校准就完成逐层量化敏感度分析,并直接导出主流框架的量化配置。
量化调试的痛点:问题层藏得太深
跑训练后量化(PTQ)时,视觉模型或Transformer里通常只有少数几层因激活分布呈重尾而主导精度损失。这些脆弱层在整体评估中并不显眼,但一旦量化就会显著拉低SQNR。以往要么靠经验猜,要么用网格搜索逐一试错,计算成本高且难以复现。BitLens的作者把这一过程压缩为单次校准:通过钩子包裹PyTorch的nn.Module或ONNX计算图,为权重(对称逐通道)和激活(非对称逐张量)各采集128-bin直方图,作为后续分析的统计基础。
SQNR(Signal-to-Quantization-Noise Ratio,信号量化噪声比) 是衡量量化精度的核心指标,定义为原始信号功率与量化误差功率之比,单位通常为分贝(dB)。SQNR 越高,表示量化引入的噪声越小、精度损失越低。对于均匀量化,理论上 SQNR ≈ 6.02 × 比特数 + 1.76 dB,因此 INT8 的理论上限约为 49.9 dB,INT4 约为 25.8 dB。实际模型中由于激活分布的重尾特性,部分层的 SQNR 会远低于理论值,例如文中 ViT-Tiny 的 qkv 层 INT8 SQNR 仅 18.8 dB,说明该层量化噪声已接近甚至超过信号本身,是精度骤降的元凶。BitLens 用 SQNR 作为逐层敏感度排序的依据,正是因为它能直接反映量化对信息保真度的影响。
核心机制:离群点雷达与SQNR诊断
BitLens的关键指标是离群比Omega(Ω=absmax/p99.9)与超额峰度。Omega越大,说明极端值相对主体分布越突出,非对称逐张量量化的步长会被拉得越大。作者给出的典型例子是ViT-Tiny:blocks.11.attn.qkv层的Ω达到240.2倍,使非对称逐张量步长超出p99.9主体4.1倍,INT8 SQNR掉到18.8 dB,INT4更是只剩7.4 dB。这类数据把“哪一层在拖后腿”变成了可量化、可排序的指标,而不只是模糊的精度下降感受。
超额峰度(excess kurtosis) 是衡量分布尾部厚重程度的统计量,定义为四阶标准矩减去 3(正态分布的超额峰度为 0)。超额峰度越大,说明分布中的极端值越多、尾部越重,这正是量化中“离群点”问题的统计学根源。在神经网络激活中,重尾分布意味着少数极大值会拉大量化步长,导致主体分布被粗粒度量化,精度损失严重。BitLens 同时使用 Omega(离群比)和超额峰度两个指标:Omega 直接量化极端值相对主体(p99.9)的突出程度,超额峰度则从分布形状上提供互补视角。两者结合能更稳健地识别出那些“看起来正常但尾部危险”的层。
内存规划与自动拟合求解器
除了精度维度,BitLens还处理部署端的现实约束。拓扑峰值SRAM规划器沿残差分支计算张量活跃期,找出精确的峰值激活内存水位,再叠加静态Flash权重占用。在此之上,一个贪心Pareto自动拟合求解器根据目标硬件预算(如STM32H7、ESP32-S3、Cortex-M55、Raspberry Pi Zero 2W)逐层将精度从FP32降到FP16、INT8、INT4,每次选择“每节省一字节所损失SQNR最小”的降级方案,同时允许用户锁定特定层不被改动。这实际上把混合精度搜索从盲目枚举变成了带约束的贪心优化。
Pareto 最优(帕累托最优) 在多目标优化中指不存在另一个方案能在不损害至少一个目标的前提下改进任一目标的状态。BitLens 的贪心求解器在精度(SQNR)和内存占用之间寻找平衡:每降低一档精度,SQNR 会损失、内存会节省,求解器选择“每节省一字节所损失 SQNR 最小”的降级方案,实际上是在逐步逼近 Pareto 前沿。所谓“贪心”是指每一步都做局部最优选择,不保证全局最优,但计算成本远低于穷举所有混合精度组合。用户可通过锁定层来约束搜索空间,使求解器在剩余层上重新计算 Pareto 方案,从而在硬件预算内获得近似最优的逐层精度分配。
一键导出三大框架配置
分析结果最终要落地到代码。BitLens支持为PyTorch torchao生成独立量化脚本(Int8DynamicActivationInt4WeightConfig、Int8WeightOnlyConfig),为ONNX Runtime生成quantize_static并附带nodes_to_exclude,为TFLite Micro生成配套的C arena头文件。这种一键导出省去了手工映射配置的环节,也降低了跨框架迁移时的出错概率。
torchao 是 PyTorch 官方推出的量化与低精度计算库,提供 Int8DynamicActivationInt4WeightConfig(激活动态 INT8、权重 INT4)和 Int8WeightOnlyConfig(仅权重量化 INT8)等配置,可直接作用于 nn.Module 并生成量化后的模型。ONNX Runtime 的 quantize_static 是静态训练后量化工具,需要校准数据来确定激活范围,并支持 nodes_to_exclude 参数跳过敏感层。TFLite Micro 面向微控制器,其量化模型以 C 数组形式嵌入固件,BitLens 生成对应的 arena 头文件可直接集成到 MCU 工程。这三个导出目标覆盖了从云端到边缘再到 MCU 的主流部署路径,但各框架对量化粒度(逐张量/逐通道)、对称性的支持存在差异,BitLens 的导出逻辑需做相应映射,用户仍应核对导出脚本是否符合目标框架的算子约束。
上手方式与社区反馈方向
用户可以直接在浏览器Studio中测试预置的MobileNetV3-Small、ResNet-18、ViT-Tiny配置,无需安装;也可在本地用Python CLI处理自己的.pt或.onnx检查点,再把生成的.bitlens.json拖回Studio可视化。作者明确欢迎针对group-wise AWQ/GPTQ模拟、SmoothQuant alpha预览等量化方案的PR。从社区讨论看,这类“单次校准+可视化+配置导出”的工具定位,切中了量化工程师在调试效率上的真实缺口,但新增量化方案的支持深度将决定它能否从诊断工具走向完整工作流。
适用边界与建议
BitLens目前聚焦PTQ场景,依赖校准数据的代表性;Omega与峰度指标能高效标出脆弱层,但不能替代端到端精度验证。建议把它作为量化前的快速筛查与配置生成器,先用求解器得到候选混合精度方案,再在小验证集上确认。对于内存受限的MCU部署,峰值SRAM规划给出的水位线值得与静态分析工具交叉核对。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。