BitRun v0.2 实测:1-bit LLM 终端驾驶舱与毫瓦级功耗遥测

BitRun v0.2 发布 Cockpit 双面板终端,把 CPU 功耗遥测嵌入本地 1-bit 推理,实测 8B 模型可在笔记本 CPU 上运行。
BitRun v0.2.0-beta 针对早期 alpha 的数千条开发者反馈推出更新,核心是 BitRun Cockpit——一个左侧流式对话、右侧实时遥测的双面板终端界面,直接展示 tokens/s、首 token 延迟、CPU 封装功率与每 token 焦耳数。基于 BitNet b1.58 的三值权重方案,8B 的 bonsai-8b 模型仅占约 2.08 GB 内存,无需 GPU、无需云 API 即可在 CPU 运行。作者从底层重建了推理引擎,解决了 GGUF Type 42 张量冲突、2-bit 内核步幅内存损坏等问题,并集成 ARM NEON 加速。真机数据显示:M4 Pro 上 bonsai-8b 达 21 tok/s、每 token 0.886 焦耳;x86 平台因缺少专用 AVX2/AVX-512 内核,同模型仅 4 tok/s,成为下一步优化的明确方向。
微软研究院的 BitNet b1.58 论文提出用三值权重 {-1, 0, +1} 从零训练语言模型,推理时彻底消除浮点矩阵乘法,改用整数加法完成张量运算。论文给出的承诺是能耗降低 70% 到 80%,同时在普通笔记本 CPU 上跑出极高速度。
但真正在本地跑模型的人都知道现实体验:电池百分比肉眼可见地往下掉,终端吐出一堆没有格式的文本,而你完全不知道 CPU 此刻到底吃了多少瓦。作者 IshekKhal 发布的 BitRun 初始 alpha 收到了数千名开发者的反馈——想要真实的电力数据(活跃瓦特数与每 token 焦耳数)、想要超过 20 亿参数的模型、想要一个像指挥中心而不是终端滚屏的交互界面。
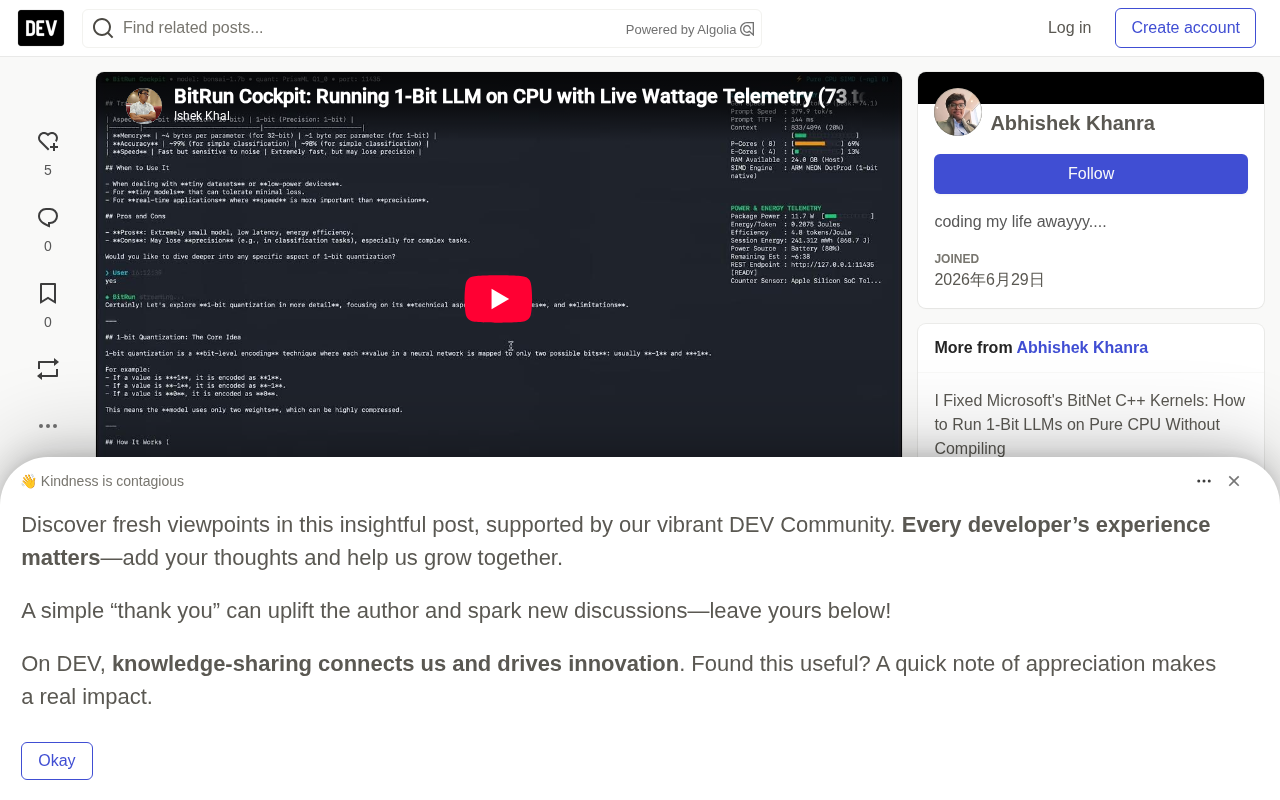
v0.2.0-beta 是对这些反馈的正面回应。
BitRun Cockpit:终端里的实时指挥中心
这次更新的核心是 BitRun Cockpit。运行 bitrun cockpit bonsai-1.7b 会启动一个专为低功耗推理设计的双面板终端界面。
左面板是交互式对话,基于本地服务器推送事件(SSE)实现逐字符 token 流式输出,支持独立滚动——你可以在不打断生成的情况下回看长对话的早期内容。右面板是实时遥测仪表盘,监测的硬件指标包括:
- 生成速度与提示处理速度(tokens/秒)
- 首 token 延迟(毫秒)
- CPU 性能核与能效核的负载百分比
- CPU 封装瞬时功率(瓦特)
- 每 token 累计能耗(焦耳)
- 电池放电速率估算
所有后台运行日志自动写入 ~/.bitrun/engine.log,终端界面保持干净,不会出现画面撕裂。对于一个主打能效的工具来说,把功耗数据直接摆在用户眼前,比任何跑分都更有说服力。
服务器推送事件(SSE) 是一种基于 HTTP 的单向流式传输技术,服务器可以在不关闭连接的情况下持续向客户端推送文本数据。与 WebSocket 的双向通信不同,SSE 更轻量,天然适合 LLM 逐 token 输出的场景:服务端每生成一个 token 就推送一个事件,客户端即时渲染。SSE 使用 text/event-stream 内容类型,浏览器和终端客户端均可解析,且支持自动重连。在 BitRun Cockpit 中,正是靠 SSE 实现了对话面板的逐字符流式显示,而不需要为每段响应反复发起请求。
1-bit 计算能否撑起 80 亿参数?
社区最关心的问题之一是:1-bit 计算在规模扩大后是否会失效。
v0.2 的答案是:BitRun 可以完全在 CPU 内存中运行 PrismML 的 80 亿参数模型 bonsai-8b,占用约 2.08 GB 内存。不需要独立 GPU,不需要云端 API,零编译。
原理在于,1.58-bit 模型用整数加法替代浮点矩阵乘法,内存占用相比 16-bit 基线下降约 80%,使得完整规模的推理模型可以舒适地待在普通笔记本上。
三值权重与 1.58-bit 的由来:每个权重只能取 {-1, 0, +1} 三个离散值,用二进制表示恰好需要 log₂(3) ≈ 1.58 位,这就是“1.58-bit”命名的来源。与传统的 2-bit 量化不同,三值权重使矩阵乘法退化为“有符号的整数累加”——乘以 +1 就是加,乘以 -1 就是减,乘以 0 就是跳过,浮点乘法单元完全闲置。这种形式同时带来两个收益:内存占用大幅压缩,以及运算在整数 ALU 上即可完成,功耗远低于 FP32/FP16 矩阵乘。代价是表达能力受限,因此 BitNet 系列强调需要“从零训练”而非后训练量化,才能让模型真正适应三值约束。
推理引擎的重建
为了让 8B 模型稳定运行,作者从底层重建了推理运行时,解决了四个层面的工程问题。
与旧子模块解耦
不再在微软已冻结的研究子模块上打补丁,而是将原生引擎重新基于现代上游 llama.cpp 架构。这条独立的引擎分支让团队完全掌控 SIMD 优化与张量布局。
修复 8B 张量偏移崩溃
早期加载 8B 三值检查点时会因 GGUF Type 42 张量冲突而崩溃。作者在读取器中实现了动态旧类型重映射,使 80 亿参数权重能够无内存故障地加载。
矩阵内存边界与步幅安全
在打包 2-bit 内核中,步幅不匹配曾导致超过 32 个上下文 token 后出现内存损坏。修复方式是在整个张量图中统一行步幅计算(.blck_size = 4,.type_size = sizeof(int8_t)),保证多轮对话的稳定性。
步幅(stride) 是张量在内存中沿某一维度前进一行时所需跨越的字节数。低比特量化常把多个权重打包进一个字节(如 4 个 2-bit 值塞入 int8),于是逻辑行宽与物理字节行宽不再一一对应。如果读取器和内核计算步幅的方式不一致——例如内核按打包前的元素数走、读取器按打包后的字节数走——指针就会越界读到相邻张量的数据,表现为少量 token 后突然输出乱码或崩溃。BitRun 通过统一 .blck_size = 4 与 .type_size = sizeof(int8_t) 的行步幅计算,消除了打包内核的歧义,这是低比特推理引擎里非常典型的一类“数据对不上”的 Bug。
架构专属 SIMD 加速
在 Apple Silicon 上集成 ARM NEON 点积内核与平方 ReLU 激活,同时为 Windows 和 Linux PC 提供 AVX2 回退方案。
SIMD(单指令多数据) 允许一条 CPU 指令同时处理多个数据元素,是 CPU 推理性能的核心来源。/ 在 ARM 平台,对应的是 NEON 指令集,其 vdotq_s32 等点积指令能在一次操作中完成 16 个 int8 的乘加;而在 x86 平台上,AVX2 处理 256 位宽的数据,AVX-512 扩展到 512 位。BitNet 的点积本质是“加权求和”,与 SIMD 的点积内核天然契合,因此是否有专用内核几乎决定了性能上限。BitRun 在 Apple Silicon 上启用了 ARM NEON 点积内核,而 x86 上 8B 模型仍走 arch-fallback.h 的通用可移植循环,这正是 x86 大模型性能骤降的根本原因。
真机数据:三种硬件平台的功耗与速度
以下所有数据均在物理硬件上记录,GPU 卸载完全禁用。
Apple Silicon(MacBook Pro,M4 Pro CPU,12 核,24 GB 内存)
| 模型 | 参数 | 格式 | 磁盘大小 | 生成速度 | 活跃功率 | 每 token 能耗 |
|---|---|---|---|---|---|---|
| bonsai-1.7b | 1.7B | i2_s 三值 | ~237 MB | 72.8 tok/s | 11.7 W | 0.316 J |
| falcon3-1b | 1.0B | i2_s 打包 | ~1.30 GB | 73.2 tok/s | 11.7 W | 0.345 J |
| bitnet-2b | 2.4B | i2_s 三值 | ~1.13 GB | 31.6 tok/s | 11.7 W | 0.484 J |
| bonsai-8b | 8.0B | i2_s 三值 | ~2.08 GB | 21.0 tok/s | 11.7 W | 0.886 J |
| bitnet-70m | 70M | Q8_0 | ~79 MB | 1,619.8 tok/s | 11.7 W | 0.043 J |
M4 Pro 上最值得注意的数据是 8B 模型:2 GB 出头的磁盘占用,21 tok/s,每 token 不到 1 焦耳。在一台笔记本上能效比相当出色。
Windows 10 原生(Intel Core i5-12600K,MSVC AVX2,32 GB 内存)
| 模型 | 参数 | 格式 | 磁盘大小 | 生成速度 | 活跃功率 | 每 token 能耗 |
|---|---|---|---|---|---|---|
| bonsai-1.7b | 1.7B | i2_s 三值 | ~237 MB | 85.6 tok/s | 22.6 W | 0.264 J |
| falcon3-1b | 1.0B | i2_s 打包 | ~1.30 GB | 11.1 tok/s | 22.6 W | 2.036 J |
| bitnet-2b | 2.4B | i2_s 三值 | ~1.13 GB | 6.7 tok/s | 22.6 W | 3.373 J |
| bonsai-8b | 8.0B | i2_s 三值 | ~2.08 GB | 4.0 tok/s | 22.6 W | 5.650 J |
| bitnet-70m | 70M | Q8_0 | ~79 MB | 597.8 tok/s | 22.6 W | 0.038 J |
x86 平台的表呈现出明显的分化:小而简单的模型速度尚可(bonsai-1.7b 达到 85.6 tok/s,甚至超过 M4 Pro),但打包格式和更大参数量的模型性能急剧下滑——bonsai-8b 只有 4.0 tok/s。
Linux WSL2(Intel Core i5-12600K,GCC AVX2,2 vCPU)
| 模型 | 参数 | 格式 | 磁盘大小 | 生成速度 | 活跃功率 | 每 token 能耗 |
|---|---|---|---|---|---|---|
| bonsai-1.7b | 1.7B | i2_s 三值 | ~237 MB | 16.8 tok/s | 8.5 W | 0.505 J |
| falcon3-1b | 1.0B | i2_s 打包 | ~1.30 GB | 6.7 tok/s | 8.5 W | 1.261 J |
| bitnet-2b | 2.4B | i2_s 三值 | ~1.13 GB | 4.4 tok/s | 8.5 W | 1.938 J |
| bonsai-8b | 8.0B | i2_s 三值 | ~2.08 GB | 0.5 tok/s | 8.5 W | 16.058 J |
| bitnet-70m | 70M | Q8_0 | ~79 MB | 134.1 tok/s | 8.5 W | 0.063 J |
WSL2 受限于虚拟 CPU 数量,性能数据参考价值有限,但 8B 模型 0.5 tok/s 的速度基本不具备实际可用性。
作者对架构吞吐差异的解释是:Apple Silicon 受益于 arch/arm/quants.c 中专门的 ARM NEON 点积内联函数;而在 x86_64 上,bonsai-8b 和打包格式目前走的是 arch-fallback.h 中的通用可移植循环,以保证在较老 CPU 上的稳定性,专属 AVX2/AVX-512 内核尚未加入。
这组数据实际上回答了一个关键问题:1-bit LLM 在 ARM 平台上已经具备实用性能,但在 x86 上要跑大模型,还需要等待专用 SIMD 内核的补齐。
零编译上手
预编译的独立二进制文件已提供 macOS(Apple Silicon)、Windows(x86_64)和 Linux 版本,不需要 CMake、Python 虚拟环境或 Docker。
macOS / Linux 安装:
curl -fsSL https://raw.githubusercontent.com/IshekKhal/bitrun/main/install.sh | sh
Windows PowerShell 安装:
irm https://raw.githubusercontent.com/IshekKhal/bitrun/main/install.ps1 | iex
启动 Cockpit:
bitrun cockpit bonsai-1.7b
在 localhost:8080 上运行 OpenAI 兼容 REST 服务:
bitrun serve bonsai-1.7b
可以直接将 Cursor、Continue.dev 或 Open WebUI 指向本地端点,无需云依赖。
开源与获取
所有代码和预编译发布二进制文件在 MIT 许可证下开源。项目地址为 github.com/IshekKhal/bitrun,v0.2.0-beta 的发布资产可在仓库的 Releases 页面获取。
BitRun Cockpit 展示了一个务实的方向:把功耗遥测直接嵌入推理终端,让开发者对自己的电力开销一目了然。对于需要在离线环境或电池供电场景下跑模型的人来说,这比单纯的跑分更有参考价值。而 x86 大模型性能的短板,也清晰地标出了下一步优化的方向。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。