BLOKS:用草图块预条件破解核方法的内存瓶颈

BLOKS通过块Jacobi与草图结合的新型预条件器,突破核岭回归在大规模数据上的内存—精度权衡瓶颈。
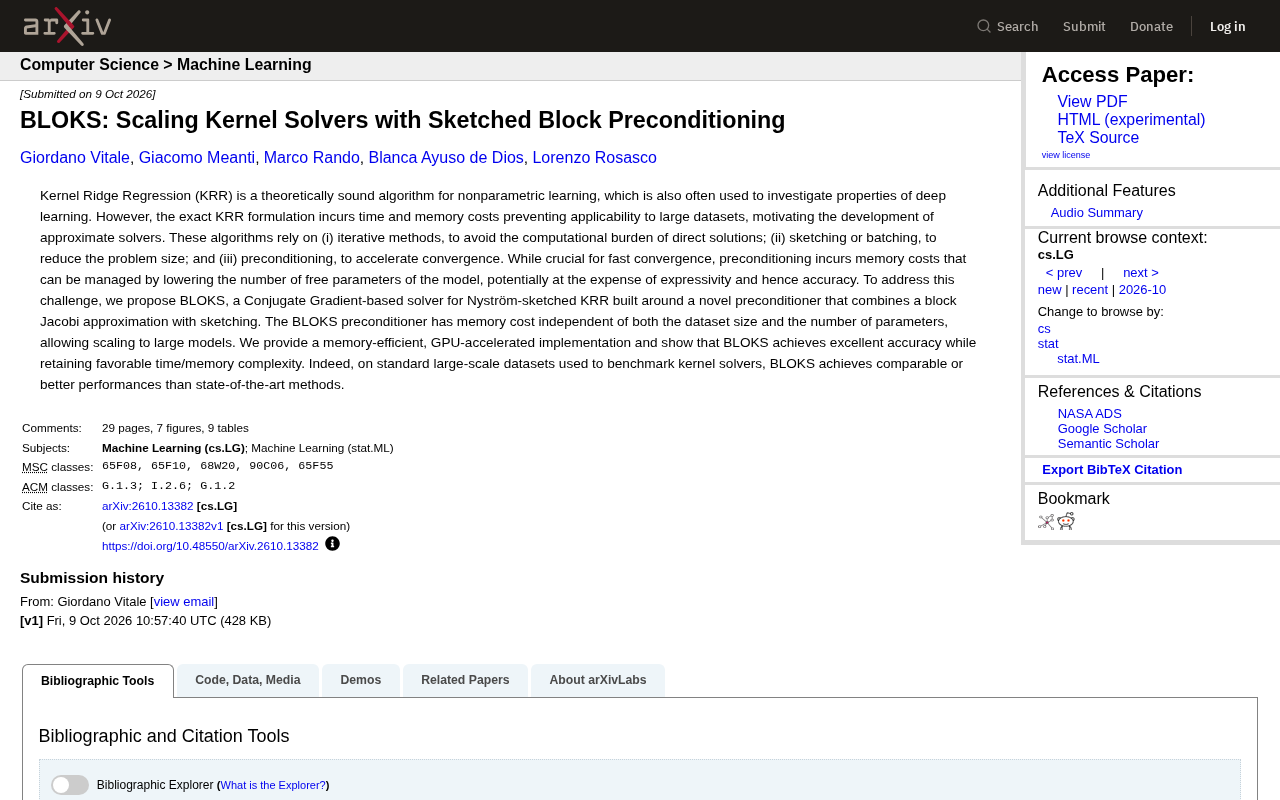
核岭回归(KRR)理论优雅但难以扩展,精确求解的时间与内存开销随数据规模急剧增长。现有近似方法依赖迭代法、草图降维和预条件加速三大支柱,但预条件器带来的高内存占用迫使研究者减少模型参数,进而牺牲精度,形成难以调和的权衡。BLOKS 通过将块 Jacobi 近似与草图技术结合,构造出一种内存开销同时独立于数据规模和参数数量的新型预条件器,从结构上解开了这一死结。配合内存高效的 GPU 加速实现,BLOKS 在标准大规模基准数据集上达到或优于当前最先进方法,在精度、速度与内存三个维度上实现了良好平衡,为核方法在大数据场景中的实际应用扫清了重要障碍。
核方法的规模困境
核岭回归(Kernel Ridge Regression,KRR)是非参数学习中一个理论基础扎实的算法,常被用来研究深度学习的内在性质。它的数学形式优雅、可解释性强,但代价是精确求解时在时间和内存上的开销呈急剧增长,这使其难以直接应用到大规模数据集上。
正是这个矛盾催生了一系列近似求解器的研究:如何在保留 KRR 理论优势的同时,让它能在真实世界的大数据场景中跑得动?这正是最新研究 BLOKS 所瞄准的核心问题。
近似求解器的三大支柱
要让 KRR 可扩展,现有方法通常依赖三条路径的组合:
- 迭代法(iterative methods):避免直接求解带来的沉重计算负担,用逐步逼近替代一次性精确解;
- 草图或分批(sketching / batching):通过降维或分块来缩小问题规模;
- 预条件(preconditioning):加速迭代过程的收敛。
其中预条件是收敛速度的关键环节,但它本身也是个麻烦制造者——预条件矩阵往往需要占用大量内存。常见的应对办法是减少模型的自由参数数量来控制内存,可这又会牺牲模型的表达能力,进而拖累最终精度。
一个难以调和的权衡
换句话说,研究者长期面临这样一个两难:想要快速收敛就得用预条件,用了预条件就得吃内存,为了省内存又得砍参数,砍了参数精度就下降。BLOKS 的价值,恰恰在于试图跳出这个循环。
Nyström 草图化是核方法中最常用的降维技术之一。其基本思想是:从 $n$ 个训练样本中随机选取 $m \ll n$ 个"锚点"(landmark points),用这些锚点生成的低秩矩阵来近似完整的 $n \times n$ 核矩阵。这样一来,存储和计算的主要瓶颈从 $O(n^2)$ 降至 $O(nm)$,使得核方法在大数据上变得可行。Nyström 近似的质量取决于锚点数量 $m$:$m$ 越大,近似越精确,但内存和计算开销也随之增加。BLOKS 正是在 Nyström 框架下工作的,预条件器的设计需要在不破坏这一低秩结构的前提下实现内存解耦。
BLOKS 的核心思路
BLOKS 是一个基于共轭梯度(Conjugate Gradient)的求解器,面向 Nyström 草图化的 KRR。它的创新集中在一个新型预条件器上:将块 Jacobi 近似(block Jacobi approximation)与草图技术结合起来。
这个设计的关键特性是——预条件器的内存开销同时独立于数据集规模和参数数量。这意味着无论数据有多大、模型有多少参数,预条件部分的内存占用都不会随之膨胀。对于希望扩展到大模型的场景,这是一个结构性的突破,直接解开了前面提到的内存—精度权衡死结。
为什么块 Jacobi 加草图是关键
块 Jacobi 近似本质上是对完整预条件矩阵的一种分块简化,保留了对收敛至关重要的局部信息;而草图技术进一步压缩了需要处理的维度。两者结合后,既维持了预条件应有的加速效果,又把内存成本控制在了一个与问题规模解耦的水平。这种解耦正是其可扩展性的来源。
共轭梯度法(Conjugate Gradient,CG)是求解对称正定线性方程组 $Ax = b$ 的经典迭代算法。对于核岭回归而言,精确求解需要对 $n \times n$ 的核矩阵直接求逆,时间复杂度为 $O(n^3)$;而 CG 通过逐步构造互相"共轭"的搜索方向来迭代逼近解,每一步只需做一次矩阵-向量乘法。收敛所需的迭代次数与矩阵的条件数密切相关——条件数越大,收敛越慢。预条件器的作用正在于此:它对原方程做等价变换,使变换后矩阵的条件数大幅减小,从而让 CG 用更少的迭代轮次达到同等精度。
块 Jacobi 预条件是经典 Jacobi 迭代的推广:Jacobi 方法用原矩阵的对角元素构造预条件器,而块 Jacobi 则将矩阵划分为若干对角块,分别对每个小块求逆来构成预条件器。这样做保留了块内的局部耦合信息,比纯对角预条件更能捕捉矩阵的结构,通常能带来更快的收敛。代价是每个对角块本身也可能很大,存储和求逆开销不可忽视。BLOKS 的创新在于:对每个对角块再次施加草图压缩,将块的有效尺寸限制在一个固定上限,从而使整个预条件器的内存占用与数据规模 $n$ 和参数数量 $m$ 都解耦,只取决于预先设定的块大小超参数。
工程实现与性能表现
论文作者提供了一个内存高效、GPU 加速的实现。这一点在实践层面同样重要——很多理论上优雅的算法因为缺乏高效实现而难以落地,BLOKS 在算法设计之外补齐了工程维度。
在用于基准测试核求解器的标准大规模数据集上,BLOKS 取得了与当前最先进方法相当甚至更好的表现,同时保持了有利的时间与内存复杂度。也就是说,它不是以牺牲速度或内存为代价换取精度,而是在三个维度上同时拿到了不错的平衡。
对研究与应用的意义
对于把核方法当作深度学习分析工具的研究者而言,BLOKS 让大规模实验变得更可行;对于实际建模任务来说,它降低了把 KRR 用于大数据集的门槛。核方法长期因为可扩展性问题被挤出大规模应用的主流,这类工作正在逐步缩小它与现代深度学习方法在工程可用性上的差距。
小结
BLOKS 的贡献可以归结为一句话:用一个内存开销与规模解耦的新型预条件器,把核岭回归的可扩展性推进了一步。它既没有回避核方法固有的计算挑战,也没有通过简单砍参数来掩盖问题,而是从预条件这一关键环节入手,提供了一个兼顾精度、速度与内存的解决方案。
需要说明的是,本文基于论文摘要撰写,具体的实验数据、对比基线和超参数细节仍需参考原始论文全文。
相关推荐

AI Agent的本质:模型、工具与循环三要素
AI Agent通常由三个核心部分组成:决策模型、可调用的工具、以及执行循环。本文拆解Agent的基本构成,并探讨设计Agent时如何定义权限边界与停止条件,避免失控。

Claude Pro与Max对比:每月200美元的Max值不值?
Claude Pro与Max套餐深度对比:Max每月200美元不增加任何Pro无法触及的模型,只卖容量。5X/20X是Pro会话额度的倍数,从100到200美元容量变4倍。本文拆解两个限制罐子、Fable 5.1计费、API积分条件,并给出80美元升级分界线与按场景选购建议。

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。