Browser Use教程:AI浏览器自动化Agent安装配置与实战指南

Browser Use:开源AI浏览器自动化智能体,用自然语言控制浏览器完成重复任务
Browser Use 是一个开源的 AI 浏览器自动化智能体,基于 Playwright 和大语言模型,允许用户通过自然语言指令控制浏览器完成各种重复性操作,无需编写代码。它支持主流大模型,提供 Web UI 和代码集成两种方式,通过 DOM 解析理解网页结构,并可通过 CDP 复用浏览器登录态。当前局限包括不支持断言和移动端自动化。
什么是 Browser Use
Browser Use 是一个开源的 AI 网页自动化智能体(Agent),允许用户通过自然语言指令控制浏览器,自动完成各种重复性在线任务,全程无需编写代码。
官方将其定义为「AI 浏览器智能体」,核心理念很直接:凡是涉及浏览器的重复性操作,都可以交给智能体替你完成。项目完全开源,托管在 GitHub 上,文档齐全,社区活跃。
从技术架构来看,Browser Use 把智能体、浏览器控制、DOM 结构解析和工具封装整合到一个项目中。底层通过 Playwright 驱动浏览器操作,借助大语言模型(LLM)理解用户意图并逐步生成执行动作。Playwright 是由微软开发的开源浏览器自动化框架,支持 Chromium、Firefox 和 WebKit 三大浏览器引擎。与早期的 Selenium 相比,Playwright 原生支持异步操作、自动等待元素加载、网络拦截等现代特性,且运行速度更快、稳定性更高。Browser Use 选择 Playwright 作为底层驱动,正是看中了它对现代 Web 应用的全面支持能力,包括处理 Shadow DOM、iframe 嵌套、单页应用(SPA)路由切换等复杂场景。
环境搭建与安装
基础依赖安装
Browser Use 要求 Python 3.11 版本,安装只需两步:
# 安装 Browser Use
pip install browser-use

# 安装 Playwright 及浏览器驱动
playwright install
项目还提供了独立的 Web UI 版本,基于 Node.js 开发。你可以将仓库 clone 到本地,创建 Python 3.11 虚拟环境并安装依赖后启动。如果不想手动配置,也可以用 Docker Compose 一键部署:
docker compose up
启动成功后,Web UI 默认运行在 7788 端口。
大模型配置
在 .env 配置文件中填写大模型的 API Key、Base URL 和模型名称即可。Browser Use 兼容几乎所有主流大模型:
- OpenAI:GPT-4、GPT-4o 等
- DeepSeek广告:V3、R1 等
- 阿里千问:Qwen 2.5、Qwen 3 等
- 本地模型:通过 Ollama 运行的任意模型
本地模型虽然免费,但推理速度偏慢。正式使用时建议选择在线模型,体验会好很多。
Web UI 使用演示
界面配置说明
Browser Use 的 Web UI 界面分为三大配置区域:
- 智能体配置:系统提示词、扩展提示词、MCP 工具接入。其中 MCP(Model Context Protocol,模型上下文协议)是 Anthropic 于 2024 年底推出的开放标准,旨在为大语言模型提供统一的外部工具和数据源接入方式。它类似于 AI 领域的「USB 接口」——任何遵循 MCP 协议的服务都可以被 AI 智能体即插即用地调用。Browser Use 支持 MCP 工具接入,意味着用户可以将数据库查询、文件操作、API 调用等外部能力无缝集成到浏览器自动化流程中,大幅扩展智能体的能力边界。
- 大模型配置:模型选择、Temperature、Base URL、API Key
- 浏览器配置:浏览器路径、窗口尺寸、无头模式、CDP 远程调试等
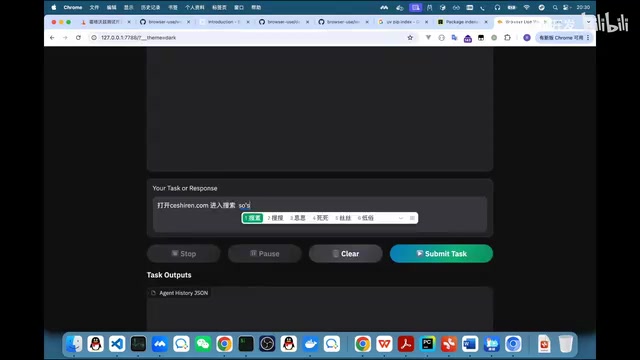
实际操作示例
配置完成后,在任务输入框中用自然语言描述需求,点击提交就行。几个典型场景:
- 简单任务:「打开百度」——智能体自动启动浏览器并导航到百度首页
- 多步任务:「打开百度,搜索霍格沃兹测试开发学社,点击搜索结果中的第一条链接」——智能体依次完成每个步骤
- 跨站操作:「打开B站,搜索霍格沃兹」——智能体能自动识别 bilibili.com 并完成搜索
使用 GPT-4o 等强模型时,执行速度明显优于本地小模型。每一步操作都会在界面上显示截图和日志,方便追踪执行过程。
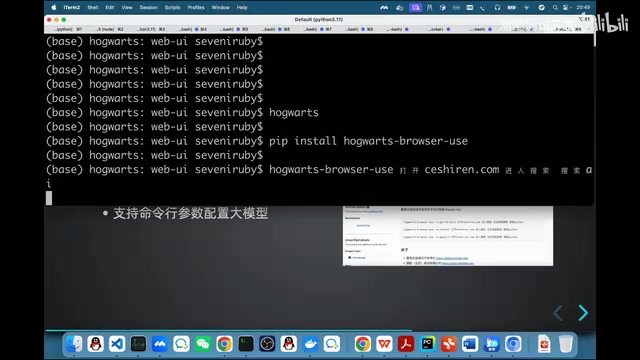
提升准确率的技巧:当智能体执行不够精确时,把任务拆分成更细的步骤效果会好很多。比如,不要只写「打开百度搜索XX」,而是明确拆成:「第一步打开百度,第二步在搜索框输入XX,第三步点击'百度一下'按钮,第四步打开搜索结果中的第一条」。这种做法本质上是在降低大模型单次推理的决策复杂度——每一步只需要理解一个明确的操作意图,而不是从一句模糊的指令中推断出完整的操作序列。
代码集成方式
异步写法(官方推荐)
import asyncio
from browser_use import Agent
from langchain_openai import ChatOpenAI

async def main():
    agent = Agent(
        task="打开测试人.com",
        llm=ChatOpenAI(model="gpt-4o")
    )
    await agent.run()

asyncio.run(main())
官方已全面采用异步(async/await)方式,通过 asyncio.run() 即可在同步环境中调用。代码结构很简洁:创建 Agent 实例时传入任务描述和大模型配置,调用 run() 方法就能启动执行。
Python 的 asyncio 是标准库中的异步 I/O 框架,采用协程(coroutine)和事件循环(event loop)模型。与传统的多线程方案不同,asyncio 在单线程内通过协作式调度实现并发——当一个协程等待网络响应或浏览器操作完成时,事件循环会切换到其他就绪的协程继续执行。Browser Use 全面采用 async/await 语法,是因为浏览器自动化涉及大量 I/O 等待(页面加载、网络请求、元素渲染),异步模型能显著提升执行效率,同时也与 Playwright 的异步 API 天然契合。
浏览器复用与登录态保持
这是实际项目中最常见的需求。Browser Use 支持通过 CDP(Chrome DevTools Protocol)或 WebSocket 连接到已有的浏览器实例:
- 启动浏览器时开启远程调试端口
- 在配置中填入本地浏览器的调试地址
- 智能体在该浏览器窗口中执行操作,直接复用已有的登录状态和 Cookie
CDP(Chrome DevTools Protocol)是 Chrome 浏览器内置的远程调试协议,它通过 WebSocket 连接暴露浏览器的内部能力,包括页面导航、DOM 操作、网络监控、JavaScript 执行等。开发者工具(DevTools)本身就是通过 CDP 与浏览器通信的。当你以 --remote-debugging-port=9222 参数启动 Chrome 时,任何支持 CDP 的客户端都可以连接并控制该浏览器实例。Browser Use 利用这一机制连接到用户已打开的浏览器,从而直接复用其中的 Cookie、Session 和登录状态,避免了每次都需要重新登录的麻烦。
需要注意的是,这个过程涉及用户资料目录(Profile)的复制和配置,实际操作中坑比较多,需要耐心调试。
智能体工作原理
核心架构解析
理解 Browser Use 的工作原理,对排查问题和优化效果至关重要:
整个智能体的执行流程是一个持续循环:
- 接收任务:用户提供自然语言指令
- 大模型推理:LLM 根据任务描述和当前页面上下文,决定下一步操作
- 工具调用:通过 Function Calling 调用浏览器控制工具(点击、输入、导航等)
- 观测结果:获取操作后的页面状态(DOM 结构或截图)
- 循环决策:将新的上下文反馈给大模型,继续推理直到任务完成
其中,Function Calling(函数调用)是这一架构的关键枢纽。这是 OpenAI 在 2023 年引入的一项能力,允许大语言模型在对话过程中结构化地调用预定义的外部函数。模型不会直接执行代码,而是输出一个包含函数名和参数的 JSON 结构,由应用层负责实际执行并将结果返回给模型。这一机制是 AI Agent 的核心基础设施——它让大模型从「只能生成文本」进化为「能够操控工具」。在 Browser Use 中,浏览器的每个操作(点击、输入、滚动、导航)都被封装为一个函数,模型通过 Function Calling 来选择和调用这些函数。
这种「感知-决策-行动」的循环模式,在 AI 领域被称为 ReAct(Reasoning and Acting)范式,是当前主流 Agent 框架的通用架构。
视觉模式 vs DOM 模式
Browser Use 提供两种页面理解方式:
- DOM 模式(推荐):直接解析网页 HTML 结构,速度快、Token 消耗低,能识别隐藏的下拉选项等元素
- 视觉模式:通过截图让大模型「看」页面,成本高且速度慢,但对某些动态渲染页面更有效
DOM(Document Object Model,文档对象模型)是浏览器将 HTML 文档解析后生成的树状数据结构,每个 HTML 标签对应树中的一个节点。Browser Use 的 DOM 模式会提取页面的 DOM 树,过滤掉样式、脚本等无关信息,只保留可交互元素(按钮、输入框、链接等)及其属性,然后将这些结构化信息作为上下文传递给大模型。相比视觉模式需要将整张截图编码为 Token,DOM 模式传递的是精简的文本信息,因此 Token 消耗大幅降低。这也是为什么 DOM 模式能识别隐藏的下拉选项——这些元素虽然在视觉上不可见,但在 DOM 树中是存在的。
对于下拉框、单选框等常见 UI 元素,DOM 模式通常一步就能完成选择;视觉模式则可能需要两步——先点击展开,再选择选项。
Token 消耗优化技巧
不少用户反映 Token 消耗过快,根本原因往往是没有对页面结构做压缩。几个实用的优化方向:
- 压缩网页 DOM 结构,只保留与任务相关的关键元素
- 定期清理历史步骤的上下文,避免信息累积
- 给大模型提供最小化的页面信息
优化到位的话,Token 消耗可以降低到原来的十分之一。要理解为什么 Token 消耗如此关键:在智能体的每一轮循环中,当前页面的 DOM 结构和历史操作记录都会作为上下文发送给大模型。一个复杂网页的完整 DOM 可能包含数千个节点,如果不做裁剪,单次请求就可能消耗数万 Token。而智能体完成一个多步任务通常需要 5-15 轮循环,Token 成本会迅速累积。因此,DOM 结构的智能裁剪和上下文窗口管理是 Browser Use 性能优化的核心课题。
进阶工具推荐:Magentic-One
除了 Browser Use,微软开源的 Magentic-One(M-Agent1) 也值得关注。它基于微软 AutoGen 框架构建,提供了类似 Manus 的完整智能体系统,主要特点包括:
- 内置 VNC 实时查看浏览器操作画面
- 支持协同规划和任务执行
- 可接入 MCP 服务扩展能力边界
AutoGen 是微软研究院开源的多智能体对话框架,核心思想是让多个 AI 智能体通过对话协作来完成复杂任务。与单一智能体不同,AutoGen 支持定义不同角色的智能体(如规划者、执行者、审查者),它们各司其职并通过消息传递协调工作。Magentic-One 正是基于 AutoGen 构建的,它内部包含多个专业化智能体:一个负责整体规划和任务分解,一个负责浏览器操作,一个负责文件处理,还有一个负责代码执行。这种多智能体架构在处理复杂、多步骤任务时比单一智能体更加稳定和灵活。
安装相对复杂,需要通过 Docker 构建并配置 OpenAI API 等环境变量。虽然功能更强大,但底层原理与 Browser Use 一致,建议先熟练掌握 Browser Use 再进阶使用。
实际应用场景与局限
适用场景
- 手工测试自动化:将 Jira 中的手工测试用例直接交给智能体执行
- 重复性网页操作:数据录入、信息查询、批量操作
- 回归测试:对已有功能进行自动化回归验证
当前局限
- 断言支持不足:Browser Use 默认不支持测试断言,需要额外开发。在自动化测试领域,断言(Assertion)是验证实际结果是否符合预期的核心机制。传统测试框架(如 pytest、JUnit)内置了丰富的断言方法,而 Browser Use 作为一个通用的浏览器自动化工具,其设计目标是「完成操作」而非「验证结果」。如果要将其用于测试场景,需要在代码层面自行封装断言逻辑,或者在提示词中要求智能体对页面内容进行检查并报告结果。
- App 自动化缺失:仅支持 Web 端,移动端需要借助其他方案(如腾讯的 AppAgent)
- 复杂交互不稳定:动态生成的 UI 元素、复杂的多步操作可能需要精心编写提示词才能稳定执行
总结
Browser Use 是目前最容易上手、功能最完善的开源浏览器自动化智能体工具。它将大模型的语言理解能力与 Playwright 浏览器自动化完美结合,让非技术人员也能通过自然语言完成复杂的网页操作。
要真正用好这类 AI 浏览器自动化工具,关键在于理解底层原理:大模型如何解析网页结构、提示词如何引导操作、Function Calling 如何调度工具。掌握这些基础知识后,无论是优化执行效果还是排查疑难问题,都能做到游刃有余。
核心要点
- Browser Use 是开源的 AI 浏览器自动化智能体,支持通过自然语言控制浏览器完成重复性任务,无需编写代码
- 支持几乎所有主流大模型(OpenAI、DeepSeek、千问、Ollama本地模型),提供 Web UI 和代码集成两种使用方式
- 智能体通过 DOM 结构解析(而非视觉)理解网页,Token 消耗可通过压缩页面结构优化至原来的十分之一
- 通过 CDP/WebSocket 远程调试可复用本地浏览器的登录状态,但配置过程较为复杂
- 当前局限包括不支持断言、不支持 App 自动化,复杂交互场景需要精心编写提示词引导
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。