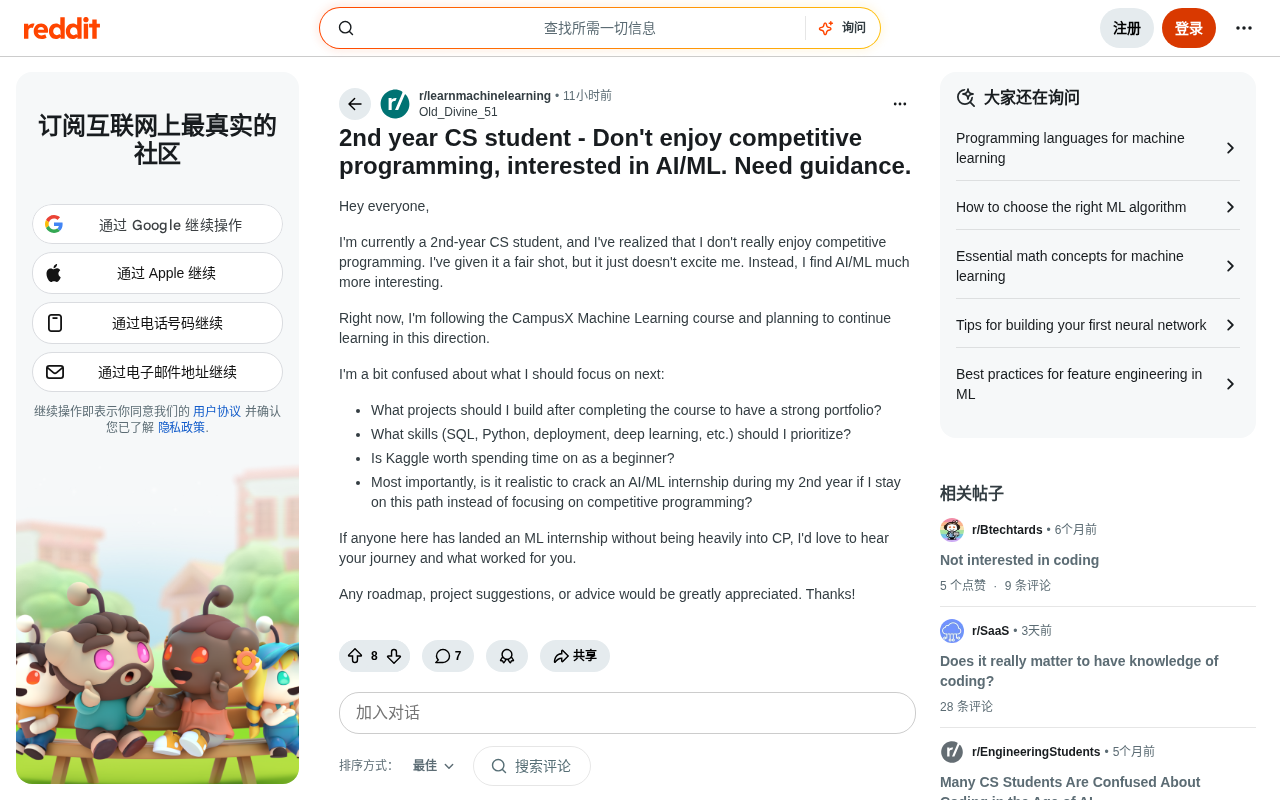
不刷竞赛题,CS学生如何转型AI/ML并拿到实习?

竞赛编程不是进入AI/ML的唯一路
在CS学习社区里,一个问题被反复提起:「我尝试过竞技编程(CP),但发现自己根本不喜欢,反而对AI/ML充满热情——这条路还走得通吗?」
这类困惑非常普遍。长期以来,竞技编程被视为通往大厂的「标准路径」,LeetCode和Codeforces排名几乎成了技术能力的代名词。但事实是,AI/ML所需的技能栈与竞技编程的重合度相当有限。
竞技编程(Competitive Programming)起源于20世纪70年代的ACM国际大学生程序设计竞赛(ICPC),核心考察图论、动态规划、数据结构等算法在时间/空间限制下的极限优化能力。这种训练体系催生了LeetCode、Codeforces等平台,并被Google、Meta等大厂引入招聘流程。然而AI/ML岗位的能力需求截然不同:统计学直觉、数据感知、模型泛化能力才是核心,而非在30分钟内手写红黑树。
值得注意的是,竞技编程与AI/ML在认知模式上也存在根本差异。CP训练的是在严格约束条件下寻找最优算法解的能力,答案是确定性的,评判标准是通过/不通过;而AI/ML的核心挑战是在不确定性中做出最优决策——数据是噪声的、标签是不完整的、模型的"正确"标准是模糊的。这种思维方式的转换,对从CP背景转型的人来说反而需要额外适应。CP训练的是算法思维和快速解题能力,而AI/ML更看重数据处理、统计建模、工程落地和领域理解。两者是不同的能力体系,走AI/ML这条路,完全不需要先在竞技编程上证明自己。
技能优先级:把时间花在刀刃上
想转型AI/ML,与其焦虑「要不要刷题」,不如把精力集中在真正相关的技能上。以下是一个更务实的优先级排序。
1. Python与数据处理:地基中的地基
Python是AI/ML的绝对主力语言,但仅会写语法远远不够。真正的核心是数据处理三件套:NumPy、Pandas、Matplotlib/Seaborn。
NumPy、Pandas和Matplotlib/Seaborn构成Python数据科学生态的基础层。NumPy提供高性能多维数组运算,底层由C语言实现,比纯Python循环快数十至数百倍;Pandas在其上构建了DataFrame抽象,使结构化数据的操作接近SQL的表达力;Matplotlib则是整个Python可视化生态的根基,Seaborn在其上提供统计图表的高层封装。这三者的设计哲学深刻影响了后来的TensorFlow、PyTorch等框架的API设计。
从历史渊源来看,NumPy脱胎于2005年Travis Oliphant对更早期的Numeric和Numarray库的整合,Pandas则由AQR资本管理公司的Wes McKinney于2008年为解决金融数据分析痛点而开发——这意味着这些工具从诞生起就是为「解决真实业务问题」而生,而非学术玩具。理解它们的设计动机,有助于更直觉地掌握其API逻辑。在实际的机器学习项目中,60%~80%的时间花在数据清洗、特征工程和探索性数据分析(EDA)上,模型训练反而只是最后一小步。能熟练操作数据,是入门AI/ML最值得优先投入的能力。
2. SQL:被低估的必备技能
很多初学者会跳过SQL,认为它「不够AI」。但在工业界,数据几乎都存储在关系型数据库中,能否高效地提取、聚合、清洗数据,直接影响工作效率。
SQL(Structured Query Language)诞生于1974年IBM的System R项目,其核心设计理念是让非程序员也能用接近自然语言的方式操作数据。半个世纪后,它依然是数据工程领域最通用的语言——PostgreSQL、MySQL、BigQuery、Snowflake、Redshift等主流数据仓库全部以SQL为接口。更值得关注的是,现代AI/ML工作流中的特征工程(Feature Engineering)大量依赖SQL完成,许多公司的特征存储(Feature Store)底层就是SQL数据库。掌握窗口函数(Window Functions)、CTE(公用表表达式)和聚合逻辑,是从数据中提取ML所需特征的关键能力。SQL不需要花太多时间精通,但它是数据岗位和ML岗位的通用语言——不会SQL,会让你在很多实际工作中寸步难行。
3. 机器学习基础→深度学习:按顺序来
先把经典机器学习(线性回归、逻辑回归、决策树、随机森林、SVM、聚类等)的原理和实践搞清楚,再进入深度学习。深度学习虽然热门,但如果连偏差-方差权衡、过拟合防控、评估指标选择都没搞明白,直接上神经网络很容易变成「调包侠」——知道怎么用,不知道为什么用,遇到问题就束手无策。
偏差-方差权衡(Bias-Variance Tradeoff)是统计学习理论的核心概念,由1992年Geman等人的研究系统化阐述。它描述了模型预测误差的两个来源:偏差(模型假设过于简单导致的系统性偏离)和方差(模型对训练数据噪声过度敏感导致的不稳定性)。二者此消彼长:过于简单的模型欠拟合(高偏差),过于复杂的模型过拟合(高方差)。
这一框架在深度学习时代并未过时,而是以新的形式复现。例如,Dropout正则化通过随机丢弃神经元降低方差;BatchNorm则在稳定训练的同时隐式起到正则化作用;而大型语言模型(LLM)时代出现的「双下降」(Double Descent)现象更是对经典偏差-方差曲线的有趣挑战——当模型参数超过训练样本数量时,测试误差反而再次下降,这一现象促使研究者重新审视过拟合的定义边界。理解这一框架是从「调包侠」进化为真正ML工程师的关键分水岭,它解释了正则化、交叉验证、集成学习等几乎所有核心技术的动机。
4. 模型部署:让你与众不同的关键
这是大多数学生最容易忽略的环节。会训练模型的人很多,但能把模型部署成可用API或Web应用的人相对少。掌握基础的 Flask/FastAPI、Docker,以及Streamlit/Gradio 等工具,能让你的项目从「在本地跑通了」变成「别人真的能用」。
Flask诞生于2010年,是Python轻量级Web框架的代表;FastAPI则于2018年推出,基于Python类型注解自动生成OpenAPI文档,在异步性能上有显著优势,已成为ML API部署的新宠。Docker容器化技术解决了「在我机器上能跑」的经典问题,通过将运行环境打包为镜像实现一致性部署。Streamlit(2019)和Gradio(2019)专为数据科学家设计,允许用纯Python构建交互式Web界面,大幅降低了ML演示应用的开发门槛,Hugging Face Spaces平台即以Gradio为核心展示生态。
从更宏观的视角来看,MLOps(机器学习运维)作为一个独立工程方向的兴起,正是因为「训练好的模型无法可靠落地」这一行业痛点。模型漂移(Model Drift)、数据管道稳定性、A/B测试框架、监控报警——这些部署层面的挑战,是当前AI/ML工程师薪酬溢价的重要来源。即便只是掌握基础部署工具,也是向这一高价值方向迈出的第一步。在实习面试中,这是非常直观的竞争优势。
项目作品集:比任何证书都有说服力
课程学完后,最常见的错误是继续「再学一门课」,陷入教程地狱(Tutorial Hell)。「教程地狱」是编程学习社区中广泛认可的现象:学习者持续跟随教程完成项目,却始终无法独立解决问题。其心理根源在于「熟悉感错觉」——跟随教程时的流畅感会被大脑误认为是真正的掌握,但这种流畅感实则来自教程提供的外部脚手架,一旦移除便无从下手。
认知科学研究表明,主动检索(Active Recall)和间隔练习远比被动跟随更有效。具体到编程学习,「费曼技巧」在此尤为适用:尝试向他人解释你刚学的概念,或者不看教程重新实现一遍,暴露出的困惑点往往正是真正的知识盲区。更激进的方式是「最小可行项目法」——在学完某个概念后立即用它解决一个自己感兴趣的微小问题,哪怕结果粗糙,这种主动建构的过程会带来远比跟随教程更深的记忆痕迹。让你真正脱颖而出的,是能独立完成的端到端项目,而不是课程结业证书。
建议按「从模仿到原创」的路径推进:
- 入门项目:房价预测、泰坦尼克生存预测等经典数据集,重点是走完完整流程——数据清洗→特征工程→建模→评估→复盘。
- 进阶项目:选择一个你真正感兴趣的领域(体育数据、音乐、游戏等),自己爬取或收集数据,从头完成一个有实际意义的分析或预测项目。
- 加分项目:做一个带部署的项目,比如图像分类Web应用或情感分析API,部署上线后附上GitHub链接和演示地址。
一个有清晰README、解决真实问题、已上线可访问的项目,胜过十个躺在硬盘里的Jupyter Notebook。
Kaggle:当工具用,别当竞技场
Kaggle由Anthony Goldbloom于2010年创立,2017年被Google收购,目前拥有超过1500万注册用户,是全球最大的数据科学竞赛平台。对初学者来说,Kaggle值得使用,但不要沉迷排名。它的真正价值在于:
- 提供大量高质量公开数据集,是练手的绝佳资源;
- Notebooks板块有海量优质开源分析,是学习他人解题思路的宝库;
- Playground级别的比赛适合练习完整建模流程,门槛友好。
需要注意的是,Kaggle顶级方案往往依赖大量模型集成(ensemble)和精细调参——顶级方案通常堆叠数十个模型进行集成(Stacking/Blending),为提升小数点后三位的准确率耗费大量GPU资源,这与工业界「够用就好、重视可维护性」的工程哲学存在明显落差。
这一落差有其结构性原因:Kaggle竞赛的评判标准是单一指标的极致优化,而工业界的ML系统需要同时满足延迟约束(Latency SLA)、可解释性要求(尤其在金融、医疗等受监管行业)、训练与推理成本控制,以及上线后的持续监控与迭代。一个在Kaggle上排名前1%的方案,可能因为推理速度慢10倍而在工业界完全不可用。此外,Kaggle数据集通常经过精心清洗,而真实工业数据往往充满缺失值、格式错误和业务逻辑异常。作为初学者,把Kaggle当作学习工具而非排名竞争平台,收益才是最大的。
大二拿AI/ML实习,现实吗?
回到核心问题:不刷竞技编程,大二能拿到AI/ML实习吗?
答案是:现实,但需要策略。 坦诚地说,纯AI/ML研究类实习对大二学生门槛偏高,不少岗位倾向于有研究经历或更成熟技能的高年级学生。但机会并非没有,关键是找对切入方式:
- 降维切入:先争取数据分析(Data Analyst)、数据工程或偏应用的软件开发实习,这些岗位对AI/ML背景同样友好,且能积累真实的行业经验。
- 用项目敲门:缺少工作经验时,GitHub作品集和项目就是你最有力的简历。一份展示端到端能力的作品集,比任何证书都管用。
- 主动出击:关注早期创业公司、学校研究实验室、开源社区——这些地方对年级和学历的要求更灵活,更看重你能否实际做出东西。
- 参与科研:如果学校有教授在做ML相关研究,主动申请担任研究助理。这是积累经验、获得推荐信的高效途径,也是简历上的有力背书。
值得补充的是,开源社区参与是一条常被忽视但极具含金量的路径。向知名ML开源项目(如scikit-learn、Hugging Face Transformers、PyTorch Lightning)提交Pull Request,哪怕只是修复文档或小型bug,都会在简历上留下有据可查的技术贡献记录,且这些贡献在GitHub上永久公开可验证——比「参与过某某课程」的陈述更有说服力。
选择适合自己的赛道
不喜欢竞技编程,完全不代表不适合做技术。CP只是众多能力体系中的一种,AI/ML这条路同样能走得很远。
核心原则只有几条:别陷入教程地狱,尽早动手做项目,重视工程落地,用作品说话。
与其反复纠结「该不该刷题」,不如现在就打开电脑,找一个感兴趣的数据集,完成第一个端到端的机器学习项目。方向对了,剩下的只是时间问题。
核心要点
- AI/ML与竞技编程是不同的能力体系,不擅长CP不影响走AI/ML方向
- 技能优先级:Python数据处理三件套 → SQL → 经典ML → 深度学习 → 模型部署
- 理解偏差-方差权衡等基础理论,是避免成为「调包侠」的关键
- 部署能力(Flask/FastAPI、Docker、Streamlit/Gradio)是被严重低估的竞争优势
- 独立完成的端到端项目 > 课程证书;已上线的项目 > 本地Notebook
- Kaggle是学习工具,不是排名竞技场;顶级方案与工业界工程哲学存在结构性落差
- 大二拿AI/ML实习可行,策略是:降维切入数据类岗位 + 项目作品集敲门 + 参与科研或开源社区
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
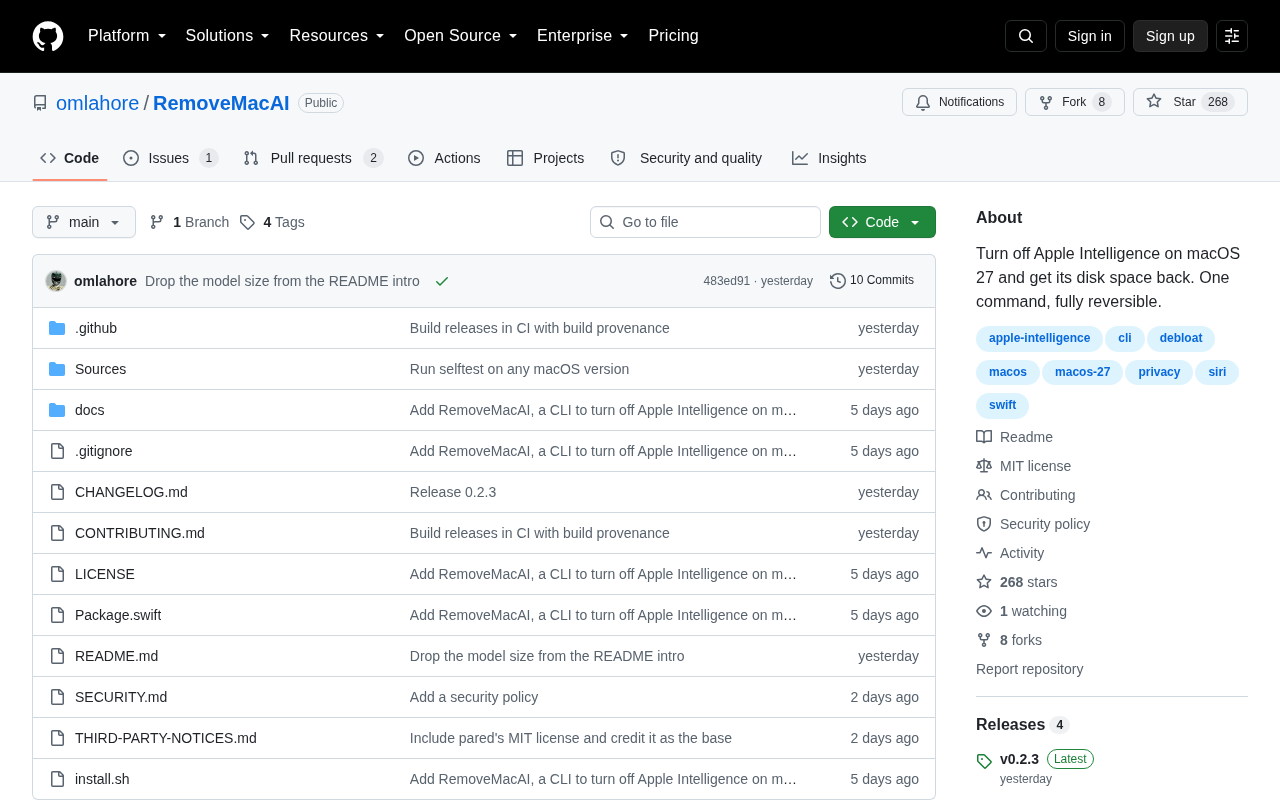
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。