部分监控新突破:E2D.PMSide实现高效上下文学习

E2D.PMSide 首次在一般函数逼近下实现上下文部分监控的计算高效求解,并在 LLM 路由任务中验证了其有效性。
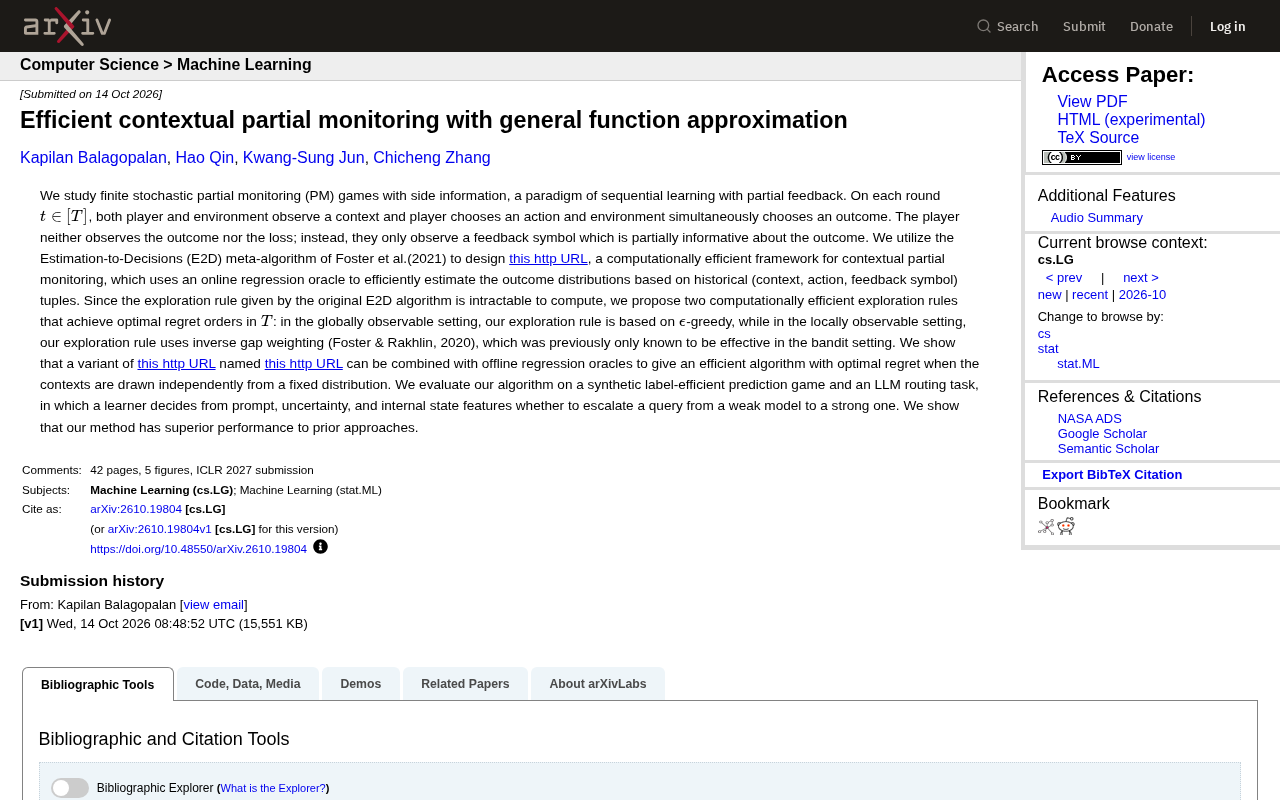
部分监控是序列决策中反馈极其受限的范式,加入上下文后计算复杂度更会急剧上升。近期研究提出 E2D.PMSide 框架,基于 Estimation-to-Decisions 元算法,通过在线回归预言机估计结果分布,避免了对分布空间的显式枚举。针对原始 E2D 探索规则不可计算的问题,该工作为全局可观测设定设计了 ε-greedy,为局部可观测设定设计了 inverse gap weighting,均达到最优遗憾阶。其离线变体 OE2D.PMSide 还可结合离线回归预言机,在上下文独立同分布时保持最优遗憾。在合成游戏和 LLM 路由两个任务上,该方法均优于先前方案,为部分监控从理论走向应用提供了重要拼图。
部分监控(Partial Monitoring, PM)是序列决策学习中一个颇具挑战性的范式:学习者每轮做出选择,但只能收到关于结果的有限反馈——既观察不到真实损失,也不知道环境实际选择了什么结果。当上下文信息加入后,问题的复杂度进一步上升。近期一项研究提出了 E2D.PMSide 框架,首次在一般函数逼近下实现了上下文部分监控的计算高效求解。
为什么部分监控长期难以落地
在经典的在线学习设定中,多臂老虎机(bandit)已经足够棘手——你只能观察到所选动作的奖励。而部分监控更甚一步:反馈信号可能来自一个与结果空间不同的符号集合,且需要多轮信息才能推断出哪些动作是好的。
PM 的标准模型假设一个有限的游戏结构,学习者需要通过精心设计的探索策略来"解码"反馈符号与真实结果之间的映射关系。过去的工作大多停留在表格化设定(有限状态和动作空间),一旦引入上下文特征或大规模动作空间,计算复杂度便会爆炸。
这项研究的切入点正是这个痛点:能否用一般函数逼近来估计结果分布,同时保持计算可行性?
部分监控的反馈结构可以分为三类经典设定,理解它们对把握全文至关重要。第一类是全局可观测(global observability):反馈符号虽然与真实结果不同,但通过若干轮观察后,任意两个动作的优劣可以被一致地区分出来,学习者只需在全局层面比较即可。第二类是局部可观测(local observability):单轮反馈不足以判断动作好坏,但通过某个固定动作的多轮重复观察可以逐步推断结果分布,需要更精细的探索设计。第三类是不可观测(non-observable):无论怎样探索都无法区分某些动作,此时只能追求次优的遗憾界。这三类设定的划分决定了算法能采用何种探索规则,也解释了为什么全局和局部设定需要分别设计 ε-greedy 与 IGW。
E2D.PMSide:用回归预言机替代暴力搜索
研究团队基于 Foster 等人提出的 Estimation-to-Decisions(E2D)元算法,设计了 E2D.PMSide。核心思路并不复杂:通过一个在线回归预言机(online regression oracle),基于历史 (context, action, feedback symbol) 三元组来估计结果分布,从而避免对每个可能的结果分布进行显式枚举。
但这里有一个关键障碍——原始 E2D 算法的探索规则在计算上不可行。E2D 要求在每个决策点求解一个涉及信息增益的优化问题,在一般函数逼近下,这个优化问题本身就是一个难题。
研究者的解决方案是为两种可观测性设定分别设计高效探索规则:
- 全局可观测设定:采用 ε-greedy 策略,以极低计算代价实现最优遗憾界
- 局部可观测设定:采用 inverse gap weighting(IGW),这一策略此前被认为仅在 bandit 场景下有效,该工作将其成功推广到部分监控
这意味着,原本需要复杂优化才能近似的探索行为,现在可以用简单规则替代,且不损失遗憾阶。
**在线回归预言机(online regression oracle)**是 E2D 框架的计算核心。它的输入是一系列 (context, action, feedback symbol) 三元组,输出是对结果分布的估计。与传统方法枚举所有可能分布不同,预言机只需求解一个回归问题——例如最小化预测分布与观测反馈之间的平方误差或对数损失。这种“预言机”是一种抽象接口:只要存在高效的回归算法(如线性回归、神经网络训练、梯度下降),E2D 就能把它当作黑盒调用,从而把复杂的分布估计问题转化为成熟的监督学习问题。这正是该工作能在一般函数逼近下保持计算高效的关键。
信息增益(information gain) 与 ε-greedy、IGW 的关系需要进一步说明。E2D 原始探索规则要求每轮选择能最大化“关于最优动作的信息增益”的动作,这等价于求解一个涉及互信息或熵的优化问题,在一般函数逼近下通常是非凸且计算昂贵的。ε-greedy 用随机探索替代精确的信息增益最大化,计算上只需常数时间;IGW 则根据当前估计的动作间隙(gap)分配选择概率,间隙越小探索越多,同样避免了显式优化。两者的共同点是:用简单的概率规则近似原本需要复杂优化才能实现的探索行为,同时通过遗憾分析证明这种近似不会损失遗憾阶。
离线预言机与独立上下文设定
除了在线场景,研究还考察了上下文独立同分布(i.i.d.)抽取的情形。在此设定下,E2D.PMSide 的一个变体 OE2D.PMSide 可以结合离线回归预言机,依然保持最优遗憾。
这一结果的意义在于:离线数据在实际应用中远比在线交互容易获取。如果你手头有大量历史交互日志(哪怕反馈不完整),OE2D.PMSide 提供了一条从离线数据到在线决策的高效通路。
当然,独立同分布上下文是一个较强的假设。在真实场景中,上下文往往存在时序相关性或分布漂移,这是该框架尚未覆盖的边界。
从合成游戏到大模型路由的验证
论文在两个任务上进行了实验。第一个是合成的标签高效预测游戏(label-efficient prediction game),用于验证理论保证是否在实际中成立。
第二个任务更贴近工程实践:LLM 路由。学习器需要根据 prompt 特征、不确定性信号和内部状态,决定是否将一个查询从弱模型升级到强模型。这是一个典型的"部分监控"问题——你只能看到最终回答的反馈,而无法直接知道弱模型是否本来就能处理好。
实验结果显示,E2D.PMSide 在这两个任务上均优于先前方法。对于 LLM 路由这个场景而言,这意味着可以用更低的推理成本达到相近的回答质量——在模型规模持续膨胀的当下,这类效率优化具有直接的工程价值。
LLM 路由(LLM routing) 是指面对一个用户查询时,系统在多个不同规模或能力的模型之间做选择,以在成本与质量之间取得平衡。典型设置包含一个弱模型(如 7B 参数)和一个强模型(如 70B 参数):弱模型推理成本低但可能答错,强模型质量高但成本昂贵。路由器的任务是仅根据 prompt 特征、不确定性信号和内部状态决定是否将查询“升级”到强模型。由于只能观察到最终回答的反馈,而无法直接知道弱模型是否本来就能处理好,这本质上是一个部分监控问题。E2D.PMSide 在此场景下的优势在于:它不需要枚举所有可能的路由策略或结果分布,而是通过回归预言机估计弱模型成功概率,从而以更低推理成本达到相近回答质量。
效率与泛化的权衡仍在
这项工作最值得关注的是它打破了"部分监控只能用表格方法"的隐性假设。通过 E2D 框架加高效探索规则,一般函数逼近终于进入了 PM 的可行工具箱。
但也有一些需要观察的地方。ε-greedy 和 IGW 虽然计算高效,但它们在最坏情况下的表现是否与信息论下界完全匹配,论文给出的遗憾阶结果需要更多后续工作来验证其在实际问题中的紧致性。此外,实验规模相对有限,LLM 路由任务的具体实验配置和基线选择也需要在更广泛条件下复现。
总体而言,E2D.PMSide 为部分监控从理论走向应用提供了一块重要的拼图。对于从事在线学习、推荐系统或 LLM 推理优化的研究者与工程师来说,这是一个值得跟踪的方向。
相关推荐

Claude Code+Codex多智能体系统实测:缓存率98%背后的真问题
开发者公布Claude Code+Codex多智能体系统7天实测:缓存率98%、输入输出比354:1,作者却卡在组织调度与输出比例,并追问行业基准与成本度量方法。

Cursor SDK 新功能:实时操控运行中的 AI 代理
Cursor SDK 新增 run.steer() 功能,允许开发者在 AI 代理运行中实时注入消息,调整执行方向。子代理遇 steer 时自动转入后台继续任务,为 AI 编程工作流带来更灵活的运行时干预能力。

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。