不确定性估计优化硅藻分类专家标注

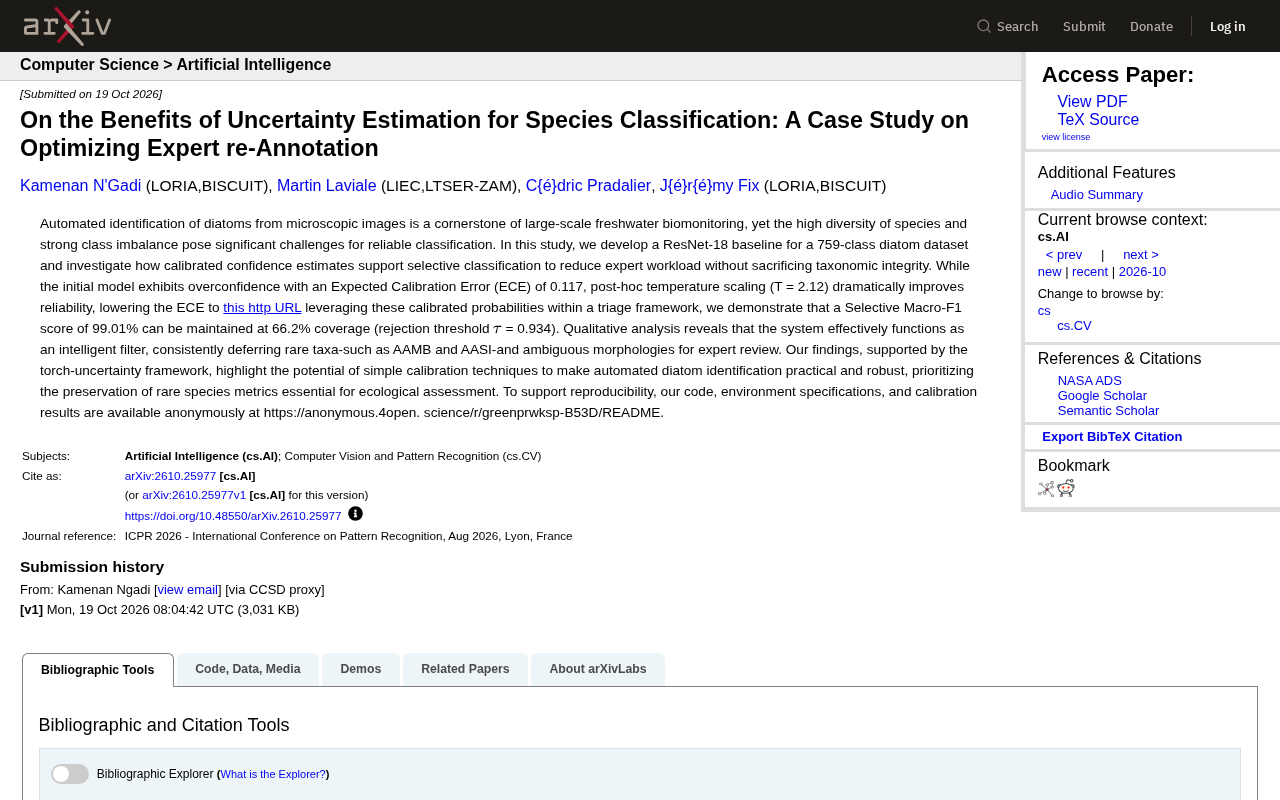
温度缩放校准使759类硅藻分类ECE从0.117降至0.055,选择性分类在66.2%覆盖率下保持99.01%宏F1。
该研究针对759类硅藻显微图像分类中的类别不均衡与模型过度自信问题,以ResNet-18为基线,发现其期望校准误差(ECE)高达0.117。通过后验温度缩放(T=2.12)校准后,ECE降至0.055,置信度更贴近真实准确率。研究进一步将校准概率用于选择性分类:当置信度低于τ=0.934时样本被拒绝并转交专家。在66.2%的覆盖率下,选择性宏F1仍达99.01%,且系统能有效识别并推迟稀有分类单元与形态模糊样本。该工作证明简单校准技术可显著提升自动硅藻识别的实用性与可靠性,在降低专家复核负荷的同时优先保障稀有物种的评估指标。
在淡水生态监测中,硅藻的自动识别是规模化生物评估的基石。然而,硅藻种类繁多且类别分布极不均衡,给可靠分类带来巨大挑战。一项最新研究以759类硅藻数据集为对象,构建ResNet-18基线模型,并探索如何通过校准的置信度估计实现选择性分类,从而在不牺牲分类完整性的前提下减少专家复核工作量。
硅藻分类的挑战与基线模型
硅藻是水质监测的重要指示生物,但人工鉴定耗时费力。研究团队构建了包含759个类别的硅藻显微图像数据集,并采用ResNet-18作为基线分类器。初始模型表现出过度自信的问题:期望校准误差(ECE)为0.117,意味着模型预测概率与实际准确率存在明显偏差。这种过度自信在安全攸关的生态评估中尤为危险,可能导致稀有物种被错误分类而未被察觉。
期望校准误差(ECE) 是衡量模型置信度与真实准确率之间偏差的常用指标。其计算方式为:将预测概率划分为若干等宽区间(如0-0.1、0.1-0.2……),对每个区间计算"平均置信度"与"实际准确率"之差的绝对值,再按样本比例加权求和。ECE为0时表示完美校准,数值越大说明模型越"过度自信"或"过度不自信"。在本文中,ECE=0.117意味着模型给出的概率平均偏离真实准确率约11.7个百分点,这在进行风险敏感的选择性分类时会导致阈值设定失准。
温度缩放校准提升可靠性
针对过度自信问题,研究采用后验温度缩放(post-hoc temperature scaling)进行校准,最优温度参数T=2.12。校准后,ECE显著降至0.055,模型输出的置信度更贴近真实准确率。这一改进无需重新训练模型,仅通过单参数调整即可大幅提升可靠性,体现了简单校准技术的实用价值。校准后的概率为后续选择性分类奠定了基础。
后验温度缩放是一种无需重新训练的参数化校准方法。其核心是在模型输出的logits向量上除以一个标量温度参数T,再经softmax得到校准后的概率:( p_i = \frac{\exp(z_i/T)}{\sum_j \exp(z_j/T)} )。T>1会"软化"概率分布,降低过度自信;T<1则增强置信度。最优T通常在验证集上通过最小化负对数似然(NLL)或ECE来搜索。由于只引入一个参数且不改变模型结构,温度缩放计算成本极低,是深度学习中部署校准的常用首选方案,但前提是模型已经训练收敛。
选择性分类:智能过滤与专家分流
研究将校准概率应用于分诊框架:当模型置信度低于阈值τ=0.934时,样本被拒绝并转交专家复核。在66.2%的覆盖率下,选择性宏F1分数仍保持99.01%。定性分析显示,系统能有效识别并推迟稀有分类单元(如AAMB和AASI)以及形态模糊的样本,充当智能过滤器。这种机制优先保障了稀有物种的评估指标,这对生态评估至关重要——稀有物种的漏检可能掩盖生态退化信号。
选择性分类(也称拒识学习或分诊框架)允许模型在置信度不足时拒绝预测,将样本转交人工或二级系统处理。其核心评估指标是"覆盖率-精度"权衡曲线:覆盖率指被自动接受的样本比例,精度指这些样本上的分类正确率。选择性宏F1则是在多类场景下,对被接受样本计算宏平均F1。与固定阈值方案不同,覆盖率可调,使用者能根据专家复核预算灵活设定τ。本文中τ=0.934对应66.2%覆盖率,意味着约三分之一样本被分流给专家,而自动接受部分的宏F1仍达99.01%,体现了高精度与可操作性的平衡。
对生态监测的实践意义
该研究证明,简单的校准技术能使自动硅藻识别更加实用和稳健。通过不确定性估计驱动的选择性分类,专家只需复核模型不确定的样本,大幅降低工作负荷。代码、环境配置和校准结果已在匿名仓库公开,支持可复现研究。尽管研究基于特定数据集,但其方法论可推广至其他生物分类任务,为大规模生物监测提供了可借鉴的范式。
更多技术细节可参考原论文及开源框架torch-uncertainty。
torch-uncertainty 是一个基于PyTorch的开源不确定性估计与校准工具库,提供温度缩放、蒙特卡洛 dropout、深度集成、分位数回归等方法的统一接口。它支持分类、回归与语义分割任务,并内置ECE、NLL、Brier score等校准评估指标。本文使用该框架完成温度缩放与选择性分类实验,使得校准流程标准化且易于复现。对于希望将不确定性估计引入生物监测流水线的团队,此类框架可降低工程门槛,避免从零实现校准算法。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。