B站开源Index-Translate翻译模型:家用电脑本地部署全教程
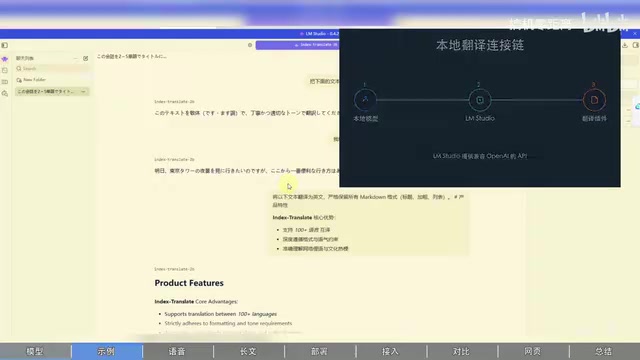
Bilibili开源Index-Translate翻译模型,2B版本仅需2GB显存,可本地部署并接入沉浸式翻译实现离线翻译工作流。
Index-Translate 是 Bilibili 开源的翻译专用大模型系列,覆盖 150 种语言,提供 2B、9B、35B 三档规模,核心优势在于指令遵循能力,可响应语气控制、格式保留、JSON 结构化输出等实际需求。2B 模型显存占用约 2GB,通过 LM Studio 加载 GGUF 格式即可在家用电脑上运行,本地推理速度约 37 token/秒。配合沉浸式翻译插件,只需将接口地址指向 LM Studio 启动的本地 OpenAI 兼容服务(默认端口 1234),即可搭建完全离线的网页翻译工作流。BBC 长文实测中,模型对括号注释、专业术语和排版细节的处理表现稳健,整体质量达到日常可用水准。
Index-Translate 是什么
Bilibili 开源的 Index-Translate 系列是一组专注于文本翻译的大模型,覆盖 150 种语言,在泛化小语种翻译的同时,重点强化了指令遵循与贴近实际场景的翻译能力。相比纯粹比拼 BLEU 分数的传统翻译模型,它更强调「听懂你想怎么翻」——比如要求输出特定语气、保留格式、生成结构化内容等。
该系列提供了 2B、9B、35B 三种参数规模。其中 2B 版本是本次教程的主角,因为它的显存占用仅约 2GB 左右,几乎每台家用电脑都能真实跑起来。在同级别对比中,官方给出的数据显示,即便是最低配的 2B 模型,在字幕翻译等任务上的表现也领先于部分主流闭源模型的轻量版本。
围绕主力翻译模型,官方还延伸出三个衍生版本:Index-Echo(端到端语音输入与语音转文本)、Index-Humana(带语气的语音翻译)以及支持长度控制的 Native-Log 模型。本次测试聚焦于主力的 Index-Translator。
官方 Demo 实测:指令遵循与格式保留
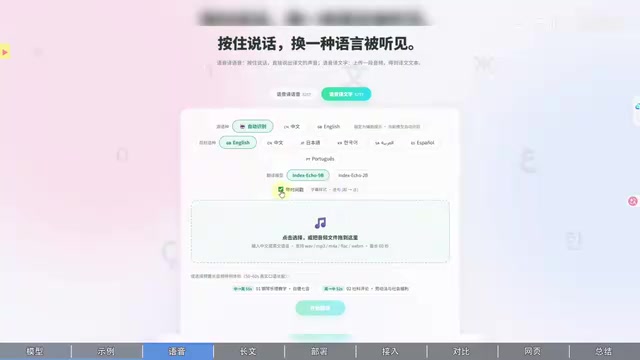
官方提供了一个所有人都能直接访问的在线 Demo,涵盖文本翻译、语音翻译、音节控制和长文本翻译四大功能。文本翻译部分可自由切换 2B、9B、35B 模型。
在指令遵循的几个示例中,模型表现出几个实用特性:
- 语气控制:可以要求将文本翻译成日语并使用敬体,模型会严格遵循。
- Markdown 保留:翻译时完整保留原文的 Markdown 格式,输出结构不被破坏。
- JSON 结构化输出:针对后台开发需求,可直接输出指定的 JSON 字段,便于集成。
本地跑 2B 模型时,这些能力与云端服务基本一致。实测一段 Markdown 文本翻译为英文,输出与云端完全相同且格式完整保留,速度达到 53.2 token/秒,整段耗时仅约 0.44 秒。对一个 2B 规模的模型来说,这个速度相当可观。
语音能力同样可圈可点。中译英的语音翻译不仅能准确转写,还会尝试保留说话人的语气。此外,模型支持拖入 MP4/MP3 等音视频文件(最长一分钟)自动识别字幕,并带时间戳输出,可以当作一个本地字幕识别工具使用。
本地部署:用 LM Studio 跑起来
想在家用电脑上使用,核心工具是 LM Studio。安装完成后,在搜索框中输入 index-tr 即可找到主力模型 index-translator-2B-GGUF。
这里有个关键点:务必选择 GGUF 格式,因为它针对 LM Studio 这类后端做了适配。如果电脑配置较好,也可以选 9B 版本,并根据显存情况挑选不同量化参数——参数越大能力越强,但显存要求也越高。对大多数用户而言,2B 已经够用。
模型下载并加载后,可以先在 LM Studio 里做一次测试翻译,确认能正常运行。实测本地 2B 模型翻译速度约 37 token/秒,流畅可用。
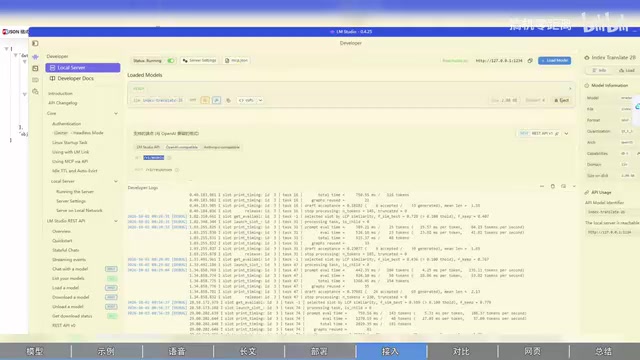
LM Studio 会在本地启动一个标准的 OpenAI 格式后台服务,这意味着可以无缝接入任何支持自定义 OpenAI 接口的翻译插件。在 LM Studio 的控制台中进入 Settings,默认端口为 1234,请求地址为 /v1/models。请求成功后即可看到当前加载的模型名称,记下来备用。
GGUF 是由 llama.cpp 项目引入的一种模型文件格式,全称 GPT-Generated Unified Format。它将模型权重、分词器配置和元信息打包进单个文件,并原生支持多种量化精度(如 Q4_K_M、Q8_0 等),能在 CPU 或混合 CPU/GPU 环境下高效推理。量化的核心思路是将模型权重从 32 位或 16 位浮点数压缩为 4 位或 8 位整数,大幅降低显存和内存占用,代价是轻微的精度损失。以 2B 模型为例,Q4 量化后体积约为 1-2GB,而原始 FP16 权重则需要约 4GB。LM Studio 的底层推理引擎就是基于 llama.cpp,因此对 GGUF 格式有完整的原生支持,这也是为什么优先选择 GGUF 而非 safetensors 或 PyTorch 格式的直接原因。
接入沉浸式翻译
配置好本地服务后,打开沉浸式翻译的设置页,进入「翻译服务」,选择「添加自定义服务」。
关键配置如下:
- 接口地址:填写 LM Studio 提供的标准 OpenAI 接口,端口为
1234。 - 模型名称:选择自定义模型,填入 LM Studio 中实际加载的模型名(如
translator-2b),不能随意乱写。 - API Key:本地服务可以随便填写。
配置完成后点击「测试」验证可用性。此时在 LM Studio 后台能看到请求日志,确认请求成功即可返回保存。
沉浸式翻译是一款广泛使用的浏览器翻译插件,其核心设计是「双语对照」——在原文段落下方插入译文,而非替换原文,方便对照阅读。它支持将翻译请求发送到任意兼容 OpenAI Chat Completions API 的后端,因此可以无缝接入 LM Studio 启动的本地服务。这里的关键在于 LM Studio 暴露的接口完全遵循 OpenAI /v1/chat/completions 格式规范,沉浸式翻译无需做任何协议适配,只需将请求地址从 OpenAI 官方服务器替换为本地 localhost:1234 即可。整个链路实现了完全离线运行:网页内容不离开本机,翻译请求在本地完成,既保护了隐私,也消除了 API 调用费用。
实战效果:BBC 长文翻译
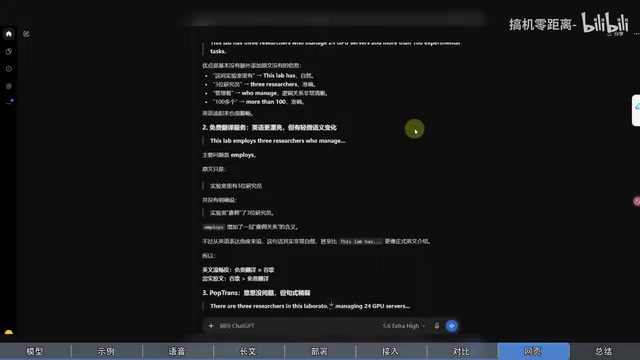
在沉浸式翻译的「在线服务对比」中,作者将 Index-2B 与谷歌翻译、以及一个免费 AI 翻译服务做了横向对比,并让 ChatGPT 评分。结果颇有意思:ChatGPT 给谷歌翻译打了最高分,而 Index-Translator 与免费服务同为四星。不过作者指出,这里调用的谷歌翻译可能只是普通机翻接口,评分结果有一定偶然性,整体来看三者星级都在可用范围内。
真正体现实力的是 BBC 长篇英文文章的翻译。首次加载模型需要稍等片刻,翻译完成后语句通顺、逻辑清晰。更值得关注的是它对细节的处理:
- 原文中括号内的补充说明(如「当地时间」等注释)被完整保留,没有被粗暴删除或合并。
- 专业术语(如 EL AL、Accra 等机构名、地名)保持原文不翻译,维持了原汁原味。
- 对「拥有 9 年驾驶经验」这类补充信息,模型会单独用括号标记,排版清晰。
从实际体验看,2B 模型在本地跑长文翻译,速度和质量都达到了日常可用的水准。
小结
Index-Translate 的最大价值在于「人人可本地部署」。2B 模型仅需约 2GB 显存,配合 LM Studio 和沉浸式翻译,就能在家用电脑上搭建一套完全本地化、无需联网的翻译工作流。它在指令遵循、格式保留、术语处理等实际场景能力上表现突出,加上开源免费和语音、字幕等衍生能力,对于注重隐私、追求可定制翻译的用户来说是一个很有吸引力的选择。
相关推荐
永生经济学:当时间不再稀缺,价值将如何重构?
SFIA 深度探讨永生经济学:当时间不再稀缺,生物永生、数字意识上传、冷冻复活如何重写劳动、财富与价值规则?从专利强制许可到意识复制的劳动力崩塌,再到意义成为新稀缺品,一场关于永生社会的硬核思想实验。
Claude存储架构大变动:本地与云端的界限正在重划
Anthropic正在调整Claude的数据存储架构。10月6日起Pro/Max新会话将仅支持云端存储,Claude Code保留本地选项,企业版存储位置仍由管理员决定。本文梳理本地与云端的最新界限及对不同用户的影响。
共同主导AI安全训练营:法律与治理从业者的实践启示
一位AI安全训练营的共同主导者分享面向法律与治理从业者的培训经验,探讨跨学科教学的挑战、概念翻译的必要性,以及AI治理人才能力建设对行业的深远意义。