Cache-to-Cache:让大模型跳过文本直接"心灵对话"
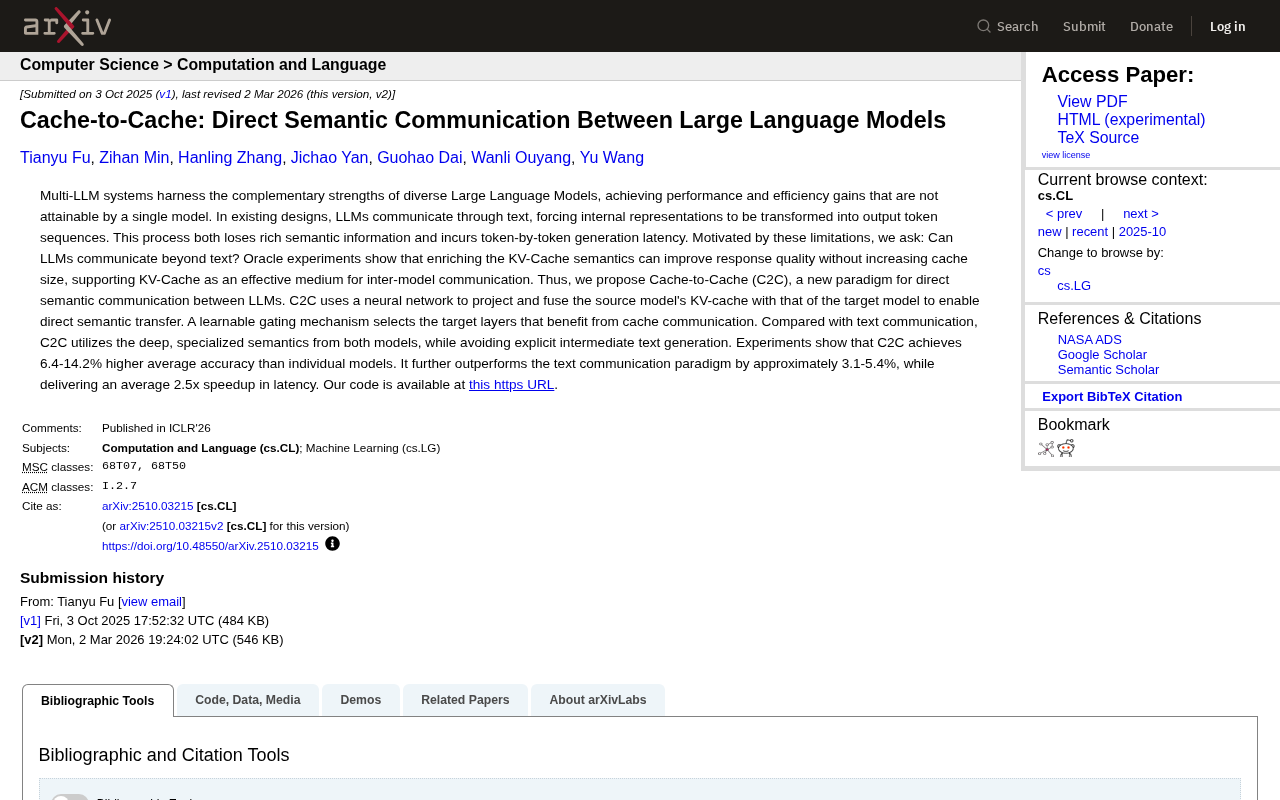
C2C研究提出让LLM绕过文本、直接传递KV Cache来降低多智能体协作中的语义损耗与计算浪费。
Cache-to-Cache(C2C)是一项针对多智能体系统通信瓶颈的新研究。传统方案中,模型间协作依赖自然语言文本作为中间媒介,这导致两重隐性成本:高维语义表征被压缩为离散token时的信息损耗,以及下游模型对已被理解内容重复执行Prefill计算的冗余开销。C2C的核心思路是直接在KV Cache层面建立跨模型的语义映射,让目标模型"接手"源模型已完成的语义理解,从而同时提升信息保真度并降低延迟。主要挑战在于不同模型的表征空间存在架构与维度差异,需要可靠的对齐机制。该方案以牺牲文本可读性与可审计性为代价,代表了多模型通信协议从"文本即标准"向更底层语义传递演进的一个重要探索方向。
当LLM之间不再用文字交流
在多智能体(Multi-Agent)系统里,大语言模型之间的协作长期依赖一种朴素的方式:把一个模型的输出转成自然语言文本,再作为提示词喂给下一个模型。这套流程直观、可读,却隐藏着两个被长期忽视的代价——信息损耗与延迟膨胀。
Cache-to-Cache(简称C2C)这项研究提出了一个颇具颠覆性的思路:让模型之间绕开文本这一中间层,直接在 KV Cache(键值缓存)层面进行语义传递。换句话说,模型不再需要把内心的"想法"翻译成人类语言,而是把承载语义的内部表征直接交给对方。
这项工作在 Hacker News 上获得了 42 分和一定讨论热度,反映出社区对多模型协作底层通信机制的关注正在升温。
文本通信的隐性成本
理解 C2C 的价值,先要看清现有方案的问题所在。
当模型 A 生成一段文本传给模型 B 时,模型 A 内部丰富的高维语义表征被压缩成了离散的 token 序列。这个"压缩-解压"的过程本身就是有损的:许多细粒度的语义信息、不确定性分布、上下文关联在转成文本时被抹平。模型 B 拿到文本后,又要重新做一遍完整的编码,把文字还原成自己的内部表征。
这里存在两重浪费。其一是语义带宽的浪费——自然语言的表达能力远不及模型内部连续向量空间的信息密度。其二是计算的浪费——B 需要对 A 已经"理解"过的内容重新进行 prefill 阶段的前向计算,等于把同样的理解工作又做了一遍。
在需要频繁往返的 Agent 协作场景中,这些成本会被逐轮放大,最终既拖慢了响应速度,也在信息传递链条中不断累积失真。
Prefill 阶段是大语言模型推理过程的第一步:模型对输入的所有 token 并行进行一次完整的前向计算,生成每一层的 KV Cache,为后续的逐 token 生成(Decode 阶段)做好准备。Prefill 的计算量与输入长度呈近似线性到平方关系,是推理延迟的主要来源之一。在多智能体流水线中,若模型 A 输出一段较长的分析文本,模型 B 接收后必须对这段文本重新执行完整的 Prefill,哪怕其语义本质上已被模型 A"消化"过。这种重复计算在上下文窗口较长或 Agent 调用链较深时,会造成显著的延迟累积,也是 C2C 着力优化的瓶颈所在。
Cache-to-Cache 的核心思路
C2C 的关键洞察在于:KV Cache 本身就是模型对已处理内容的语义"记忆"。既然如此,为什么不直接把这份记忆传递给另一个模型?
在 Transformer 架构中,KV Cache 存储了注意力机制中每个 token 对应的键(Key)和值(Value)向量,它是模型处理上下文后沉淀下来的中间状态。C2C 的做法是建立一种映射机制,将源模型的 KV Cache 转换、对齐到目标模型可以直接使用的形式,从而让目标模型"接手"源模型已经完成的语义理解。
这样做带来两个直接好处:
- 保留更完整的语义:绕过文本这个有损信道,连续表征之间的传递能承载更丰富的信息。
- 节省重复计算:目标模型无需对已被理解的内容重新做 prefill,可以显著降低延迟。
难点在于不同模型的表征空间并不天然对齐——架构、维度、训练数据都可能不同。C2C 需要解决的核心技术问题,正是如何在异构模型之间建立有效的缓存语义桥梁。
KV Cache 是 Transformer 架构中一项关键的推理加速技术。在自注意力机制中,每个 token 在每一层都会生成对应的 Key 向量和 Value 向量。当模型逐 token 生成输出时,若不缓存这些向量,则每生成一个新 token 都需要重新计算所有历史 token 的 K/V 表示,计算量随序列长度平方增长。KV Cache 的做法是将已计算过的 K/V 向量存储下来,后续 token 直接复用,从而将生成阶段的计算复杂度从 O(n²) 降至 O(n)。正因如此,KV Cache 并非临时的"草稿",而是模型对输入上下文语义理解的完整留存——它天然携带了模型"读过"某段内容后的全部中间状态,这正是 C2C 将其作为跨模型传递媒介的理论依据。
这意味着什么
如果 C2C 这类方法能够走向成熟,它对多智能体系统的意义可能是结构性的。
当前主流的 Agent 框架(无论是任务分解、工具调用还是多角色辩论)几乎都建立在"文本即协议"的假设之上。文本的好处是通用、可审计、易调试,但代价就是前面提到的损耗与延迟。C2C 提供了另一条路径:在对性能和保真度要求极高的场景中,用直接的语义通信替代文本往返。
当然,这条路也伴随明显的权衡。缓存级通信牺牲了文本的可读性与可解释性——人类无法直接"看懂"传递的内容,调试与安全审计的难度会上升。此外,跨模型的表征对齐是否稳健、是否适用于差异巨大的异构模型,都还需要更多验证。
从更长远的视角看,C2C 代表了一种值得关注的趋势:随着多模型协作成为常态,模型之间的"通信协议"本身正在成为一个独立的研究方向。文本或许只是模型间交流的第一代语言,而非最终形态。
小结
Cache-to-Cache 把大模型协作的关注点,从"说什么"转向了"怎么传"。它挑战了文本作为模型间唯一通信媒介的默认假设,试图用直接的 KV Cache 语义传递来换取更高的信息保真度和更低的延迟。这一方向能否规模化落地仍有待观察,但它提出的问题——模型之间到底应该如何高效沟通——本身就足够重要。
相关推荐
深入LLM推理:从KV Cache到PD分离的Serving全景解析
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
认知行为疗法 vs 精神分析:谁赢得了心理治疗之争
认知行为疗法(CBT)如何战胜精神分析成为心理治疗主流?历史学家Andrew Scull揭示了从二战、联邦经费到循证医学的深层原因,并客观评估CBT在轻度与重度精神障碍上的真实疗效。