仓库塞不进上下文窗口?先量token再设计

先给 agent 造一把 token 尺子和电表,再谈怎么把塞不下的仓库装进去。
这篇文章记录了 agent 项目第三天的工作:不写新功能,而是先建立度量。核心约束是仓库永远比上下文窗口大,而磁盘上的字符数与模型计费的 token 数之间没有可查的换算常数。作者主张用两个大小不同的样本调用服务端、取 `usage.prompt_tokens` 的斜率来校准比例,从而消除聊天模板的固定开销,并拒绝民间常数和别家 tokenizer。同时用一个 `Meter` 类分开记录输入与输出 token,单价走环境变量。面对超长仓库,作者在整仓发送、提前索引、agent 自主选读三条路中明确选择第三条,认为“选择什么重要”本身就是产品。
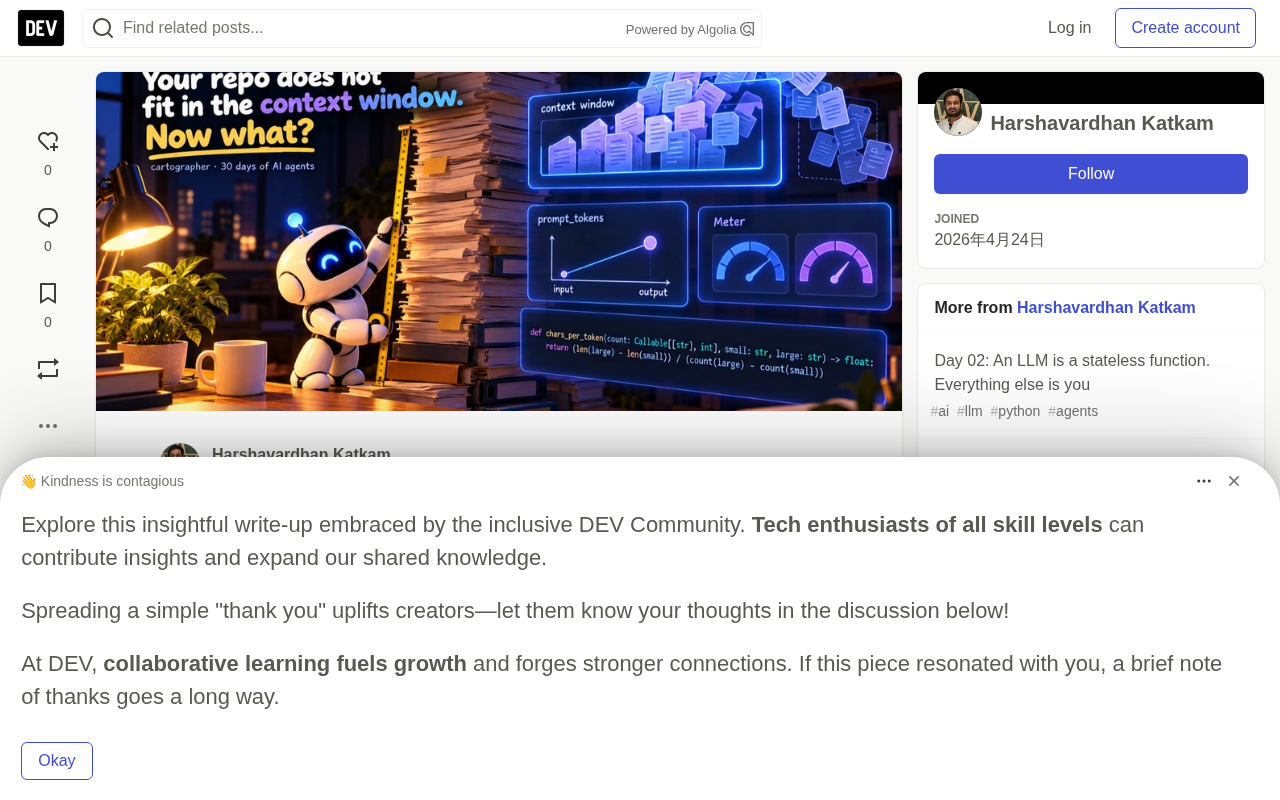
两天的开发之后,作者给 cartographer 这个 AI agent 加了一段"把整个仓库拼成一个字符串"的代码。写完顺手打了个 len()——然后他发现了问题:他不知道这段文本对应多少 token,也不知道跑一次要花多少钱。
于是第三天的任务是:不写新功能,先做一把尺子和一个电表。这个决定背后是一个所有 agent 开发者迟早要面对的约束——仓库永远比上下文窗口大。
仓库按字符算,模型按 token 收费
磁盘上的仓库大小是字符数,模型读写的单位是 token。两者之间的换算比例并不是能查到的常数。
作者给出了一个仓库遍历函数 source_files(),遍历根目录下所有文件,只保留扩展名在 SOURCE_SUFFIXES(Python、文档、配置)里的文件,并排除路径中包含 SKIP_DIRECTORIES 的文件。measure() 返回文件数和总字符数,读取时忽略非法文本。
值得强调的是跳过目录这一层逻辑。如果不过滤 .venv 和 node_modules,你测的不是项目本身,而是它的依赖——那是一个大得多、却对代码规模毫无参考价值的数字。测量人写的代码,而不是所有装在一起的东西。
Token 是大语言模型处理文本的基本单位。模型并不直接读字符,而是先用一个叫 tokenizer 的组件把文本切成词表中的片段:常见英文单词往往是一个 token,长标识符、罕见词、标点、换行和缩进则可能被拆成多个。因此同一段源码在不同模型上的 token 数会不同,因为每个模型家族训练时使用的词表和切分规则都不一样。这就是为什么字符数与 token 数之间不存在通用换算比例——它是模型相关的,还随语言和代码风格漂移。上下文窗口、速率限制、计费都以 token 计量,这也是为什么“我的仓库有多大”这个直觉问题,必须翻译成“调用这个模型时要花多少 token”才有工程意义。
两种错误的估算方式
字符数不是账单,所以需要一个比例。常见的两条路都是错的:
characters // 4——这是一个民间常数,既不对应具体模型,也不适合源代码。源代码的缩进、标点、长下划线标识符,都会让它和自然语言的 tokenization 结果相差很大。- 用一个别的厂商的 tokenizer 库来精确计算——这条看起来更严谨,实际上更糟。你的模型用的是自己的一套词表,用另一个家族的分词器算出来的"精确数字",是针对一个你的请求里根本没人使用的词表。精度不等于准确度,偏差还是系统性的,而且从外部无法察觉。
作者的判断很直接:宁可不精确,也不要一个错误的精确。
词表(vocabulary) 是 tokenizer 把一个字符串映射成整数 ID 的对照表,通常由 BPE(字节对编码)之类的算法在大量语料上统计训练得到。不同厂商、不同代际的模型拥有各自独立的词表,所以“用 A 家的 tokenizer 精确计算 B 家模型的 token 数”在逻辑上是不成立的:算出的数字针对的是一个你的请求里根本不会被使用的词表。这种误差不是随机噪声,而是稳定偏向某一方向,而且从调用方角度看不可观测。要拿到权威数字,只能依赖服务端返回的 usage.prompt_tokens,那是模型实际分词后统计出来的结果。
两个样本 + 一次相减 = 真实比例
真正权威的计数器是从服务端拿的:每次响应里的 usage.prompt_tokens 就是服务器实际数出来的输入 token 数,几乎零成本。
作者的 prompt_tokens() 函数发一个 max_tokens=1 的请求,只为了拿这个字段——因为在测量输入,而不是生成答案。
但不要只发一个样本就去除。prompt_tokens 计的是渲染后的完整请求,包含聊天模板那层固定开销。样本很短时,固定开销占比很大,一旦除进去就永久污染了比例。
正确做法是发两个大小差异明显的样本,取斜率:
def chars_per_token(count, small, large):
    return (len(large) - len(small)) / (count(large) - count(small))
常数项在相减中被消掉。两次请求、两个输出 token,就能得到针对你正在调用的那个模型测出来的比例。换模型就失效——这正是它应该是一个函数而不是配置文件中常数的原因。
配套的离线测试也很关键:给一个已知固定开销为 11 token、真实比例为 4 的假计数器,断言结果恰好是 4.0。如果相减逻辑写错,这个断言会失败。
输入和输出要分开记账
电表存在的另一半原因,是输入和输出 token 不可互换。作者的 Meter 类分别累计 prompt_tokens 和 completion_tokens,并提供按百万 token 单价换算的 dollars 属性。
三个细节值得注意:
- 单价全部来自环境变量,默认值为 0。不把任何价格字面量写进源码——公布的价格会变,而版本控制里的一个过期数字比没有数字更糟。
- 免费模型上 dollars 诚实地为 0,但 token 计数依然真实。因为真正先耗尽的从来是 token,而不是钱:窗口会先满,速率限制会先到。
- 分开记账还能告诉你该拉哪根杠杆。对话历史每轮都会重新发送,输入不断增长;而输出通常只是一段话。两边的优化手段完全不同。
record() 由 post() 在每次响应时调用,保证没有任何请求能绕开电表。测试文件 test_budget.py 离线锁定了三件事:比例校准、跳过列表、计价逻辑。
让仓库塞得下:三条路
| 整仓发送 | 提前全部索引 | Agent 自己选读什么 | |
|---|---|---|---|
| 成本 | 每次调用都付整仓 | 一次 embedding(把每个文件转成可搜索的数字),之后查询便宜 | 只为打开过的文件付费 |
| 何时失效 | 仓库超出窗口——很快 | 下一次提交后索引就过期 | Agent 选错了 |
| 适用场景 | 一个问题、一个小仓库 | 稳定代码、大量重复查询 | 大仓库、开放式问题 |
作者明确选择了第三列,而且不是勉强接受。从全部内容生成的地图不是地图,那就是疆域本身。选择什么重要,才是真正的产品;约束只是逼着设计对这件事诚实。
这与当前 AI 编程工具的主流思路一致——据多位开发者在公开讨论中反复提到,检索、选择、裁剪上下文的能力,正在从"配套功能"变成产品竞争力本身。作者也把 pin 住 commit SHA 的测量结果放在了 docs/measurements.md 里,而不是写死在这篇文章中:对着一个会移动的分支做测量不算测量,对着博客文章冻结数字更是选错了地方。
Embedding(嵌入向量) 是把一段文本映射成高维向量,使语义相近的文本在向量空间里距离更近。基于 embedding 的检索流程通常是:预先为每个文件或代码块生成向量并存入索引,查询时把问题也转成向量,取最相近的若干块塞进上下文。它的价值在于把“全仓塞入”变成“按相关性取一小块”,从而把单次调用成本压到常数级别。代价是索引需要随代码变化重建,且召回质量取决于切分与向量质量。理解这一点有助于看清表中第二列的失效模式:索引一旦过期,检索结果就会悄悄偏离真实代码,而调用方往往察觉不到。
给 agent 开发者的五条建议
- 先测量再设计。几秒钟的
len()就能告诉你,你脑子里的架构到底合不合法。 - 对着你实际调用的模型校准。两个样本、一次相减,别用民间常数,也别用别家分词器。
- 价格不要进源码。用环境变量,默认为 0。
- 每次运行都打印电表,包括免费额度的运行。形成习惯本身就是目的。
- 把"选择"当成功能。一旦承认 agent 必须自己决定读什么,工具就从便利变成了产品。
第三天的产出没有新功能,但项目从此有了度量单位。对于一个注定要撞上上下文窗口的项目来说,这可能是最划算的一天。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。