藏语NLP研究全景:低资源语言的发展范式

首项系统性文献计量调查梳理了藏语NLP二十年发展,揭示其自底向上全流程演进路径及开放性不足等核心短板。
这项覆盖2004至2026年共140篇论文的文献计量调查,系统描绘了藏语NLP的发展全貌。调查发现84%的论文集中在2018年之后,与深度学习兴起高度同步;研究路径呈现从语料库和分词等基础工作出发、逐层向语音识别、下游应用和大语言模型延伸的"自底向上"特征。中国研究者主导了87%的论文并覆盖全部25个研究领域,海外研究则集中于古典藏语。调查同时指出,仅29%的论文公开了数据、代码或模型,方言覆盖和负责任NLP实践亦存在明显缺口,并呼吁推行开放科学与社区参与。作者认为这一发展模式可为全球其他低资源语言提供参考范式。
藏语是分布在青藏高原及周边地区约七百万人使用的语言,但在自然语言处理(NLP)领域长期处于资源匮乏、研究不足的状态。一项据称是首个经过同行评审的系统性文献计量调查,对藏语NLP的发展轨迹进行了全面梳理,为理解这一冷门但重要的研究方向提供了难得的全局视角。
研究规模与增长态势
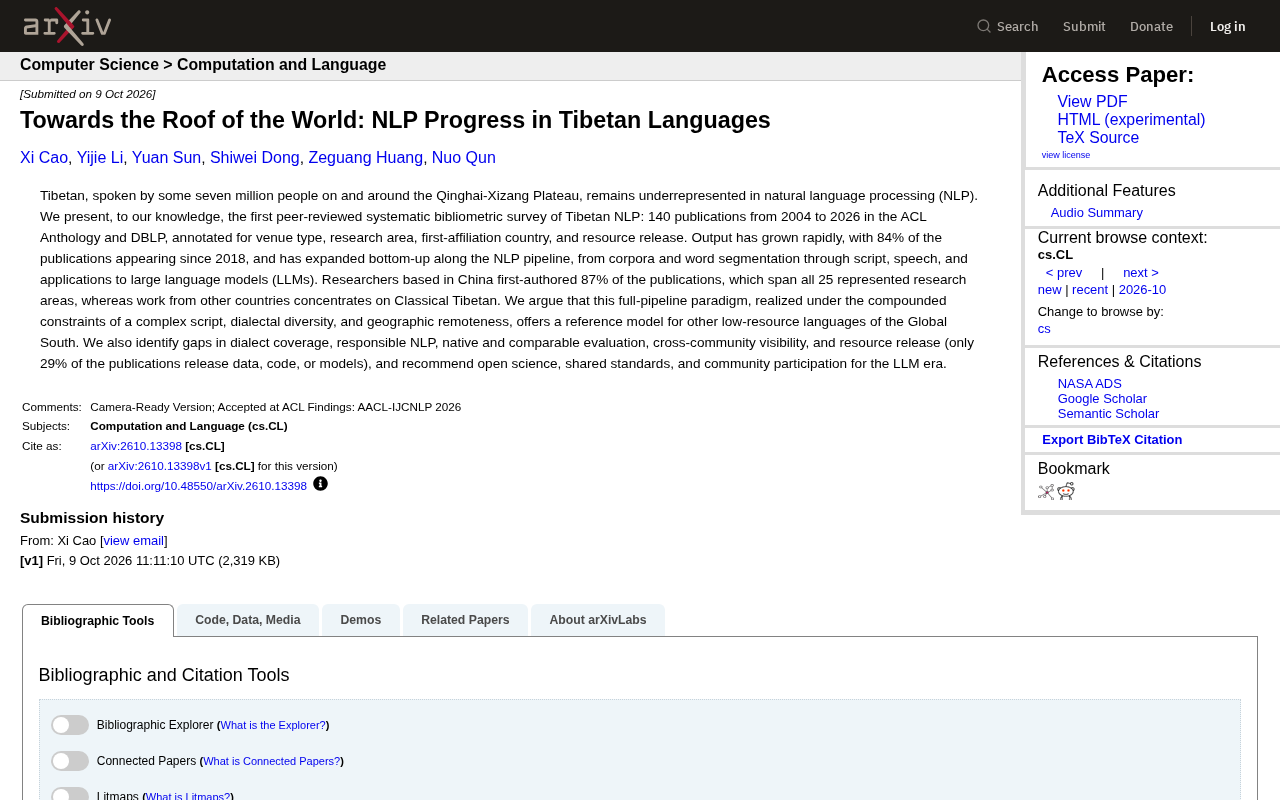
这项调查覆盖了ACL Anthology和DBLP数据库中从2004年至2026年的140篇出版物,并对每篇文献按会议/期刊类型、研究领域、第一作者所属国家以及资源发布情况进行了标注。
数据揭示出一个明显的加速趋势:有84%的论文发表于2018年之后。这意味着藏语NLP在近年来才真正进入快速扩张期,与深度学习和预训练模型的兴起节奏高度吻合。从总量上看,140篇的体量在NLP主流语言面前仍然偏少,但其增长曲线表明这一领域正在从边缘走向活跃。
ACL Anthology是计算语言学协会(ACL)维护的开放获取文献库,收录了NLP与计算语言学领域几乎所有主要会议和期刊的论文,是该领域公认的权威文献来源;DBLP则是覆盖更广的计算机科学文献数据库。文献计量学(Bibliometrics)方法通过统计分析论文数量、引用关系、作者分布等量化指标,系统描述某一研究领域的发展轨迹与知识结构,是梳理新兴或小众研究方向时常用的方法论工具。相较于叙述性综述,文献计量调查更能客观呈现领域全貌,但也受制于数据库收录范围——未被两大数据库收录的本地语言期刊或会议论文可能被遗漏,这对以中文为主要发表语言的藏语NLP研究而言是一个潜在的系统性偏差。
自底向上的全流程演进
调查的一个核心观察是,藏语NLP的发展呈现出一种"自底向上"沿NLP流水线逐步扩展的特征。研究起点集中在语料库建设和分词这类基础性工作,随后逐步延伸到文字处理、语音识别,再到各类下游应用,最终抵达大语言模型(LLM)阶段。
这种从底层基础设施逐步向上构建的路径,与资源丰富语言"先有数据、再做模型"的发展模式形成对照。对于藏语这样面临复杂文字系统、方言多样性和地理偏远三重约束的语言而言,先夯实语料、分词等地基,再逐层叠加能力,是一条务实且可复制的路线。
NLP流水线(NLP pipeline)是指将自然语言处理任务按依赖关系从底层到上层依次排列的处理链条。底层任务包括文本预处理、分词(将连续文本切分为词语单元)、词性标注等基础性工作,这些任务的质量直接影响所有上层任务的性能。藏语分词尤为复杂:藏文传统书写中词与词之间使用"藏文音节点"(Tseg)分隔音节而非词语,词边界的界定本身就是一个研究难题。语料库建设则是一切数据驱动方法的前提,对于藏语而言,采集、清洗和标注足够规模的文本数据面临文字输入法标准不统一、多种转写系统并存(如Wylie转写、藏拼等)以及方言文本稀缺等多重挑战。正是这些底层困难,决定了藏语NLP必须自底向上推进的现实逻辑。
研究力量的地理集中
从作者归属看,中国研究者担任第一作者的论文占到87%,且这些工作覆盖了调查识别出的全部25个研究领域。相比之下,其他国家的相关研究则主要集中在古典藏语(Classical Tibetan)方向。
这一分布反映出藏语NLP研究高度本地化的特点。本土研究团队更接近语言使用场景、数据来源和实际应用需求,因此能够在从基础资源到前沿模型的各个环节全面布局;而海外研究则更多从文献学、历史语言学的角度切入古典文本。两种取向共同构成了藏语NLP的研究生态,但也暗示着跨社区协作与可见度方面存在提升空间。
作为低资源语言的参考范式
调查作者提出,这种在多重约束下实现的"全流水线"研究范式,可以为全球南方(Global South)的其他低资源语言提供参考模型。
这一论点颇具启发性。许多低资源语言同样面临文字复杂、方言众多、地理分散的困境,往往不知从何入手。藏语NLP自底向上、逐层推进的经验表明,即便在条件受限的情况下,通过优先建设语料库和基础工具,仍可以逐步构建起支撑现代NLP甚至大模型的完整能力链条。这对资源匮乏语言社区具有现实的借鉴意义。
现存短板与未来建议
调查也坦诚指出了若干明显缺口。方言覆盖不足、负责任的NLP实践(responsible NLP)缺位、原生及可比评测体系欠缺、跨社区可见度低,以及资源开放程度有限,都是制约领域进一步发展的问题。
其中资源发布的数据尤为值得关注:仅有29%的论文公开了数据、代码或模型。这意味着超过七成的研究成果难以被复现和复用,严重削弱了领域内的积累效应。针对这些问题,作者建议在大模型时代推行开放科学、建立共享标准,并鼓励语言社区的实质性参与。
对于关注语言多样性和AI公平性的研究者来说,这份调查不仅是一份藏语NLP的发展地图,也是一面镜子——它提醒我们,让更多语言被技术公平对待,既需要持续的基础投入,也需要开放协作的研究文化。
负责任的NLP(Responsible NLP)是近年NLP研究伦理讨论中的核心议题,涵盖数据采集的知情同意、模型输出的公平性、语言社区成员的实质参与(而非仅将其作为数据来源)以及研究成果对社区的潜在影响评估等维度。对于少数民族语言而言,这一议题尤为敏感:若研究由外部主导、成果无法惠及语言使用者,甚至可能强化某种方言标准而边缘化其他变体,则技术进步本身可能带来新的不平等。可比评测体系(comparable benchmarks)的缺失意味着不同研究团队的模型难以在统一标准下进行横向比较,阻碍了领域内的良性竞争与进步。仅29%的论文公开资源这一数字,既反映了学术激励机制对开放共享的支持不足,也折射出部分研究者对数据敏感性的顾虑——两者都需要社区层面的政策与规范来系统性应对。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。