Cayu:构建长周期领域智能体的开源Python框架
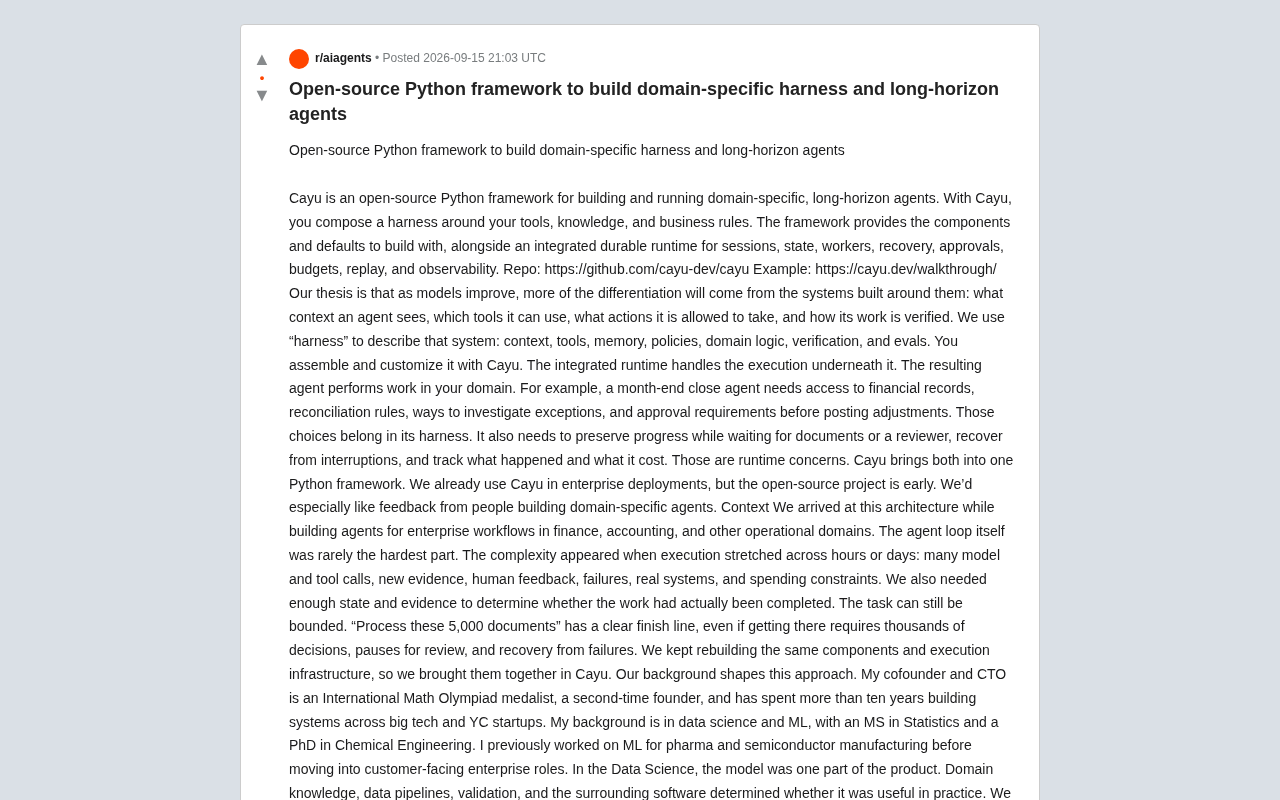
Cayu是一个开源Python框架,主张AI Agent的差异化源于围绕模型构建的harness与持久化运行时,而非模型本身。
Cayu是面向领域专用、长周期智能体的开源Python框架,其核心论点是:随着大模型能力趋向同质化,智能体的真正差异来自"围绕模型构建的系统"——即上下文、工具、策略、验证等构成的harness,以及处理会话、状态、恢复、审批和预算的持久化运行时。框架用月末结账智能体为例,清晰区分了harness(领域逻辑)与runtime(执行基础设施)两类关注点。团队在金融、会计等领域的实践中发现,长周期任务真正的难点不在于智能体循环本身,而在于跨越数小时乃至数天的执行过程中对失败恢复、人类反馈和成本约束的处理。项目目前处于开源早期阶段,计划发布τ-bench基准测试成绩以量化验证其架构主张。
当大模型能力持续逼近同质化,AI Agent的差异化究竟来自哪里?开源Python框架 Cayu 给出了一个明确回答:不是模型本身,而是围绕模型构建的整套系统——它称之为 "harness"(框架/外壳)。
什么是 Cayu
Cayu 是一个面向 领域专用(domain-specific)、长周期(long-horizon)智能体 的开源 Python 框架。它的核心思路是:让开发者围绕自己的工具、知识和业务规则来"组装"一个 harness,而框架则提供构建所需的组件、默认配置,以及一个集成的持久化运行时(durable runtime)。
这个运行时负责处理会话(sessions)、状态(state)、工作进程(workers)、恢复(recovery)、审批(approvals)、预算(budgets)、回放(replay)和可观测性(observability)等一系列执行层面的问题。项目已在 GitHub 开源(cayu-dev/cayu),并提供了在线演示(cayu.dev/walkthrough)。
核心论点:差异化来自模型周围的系统
Cayu 团队提出了一个鲜明的观点:随着模型能力不断提升,智能体的差异化将越来越多地来自"围绕模型构建的系统",而非模型本身。具体来说,这些差异体现在四个维度:
- 智能体能看到什么上下文(context)
- 它可以使用哪些工具(tools)
- 它被允许执行什么操作(actions)
- 它的工作如何被验证(verification)
团队用 "harness" 来统称这套系统,包含上下文、工具、记忆、策略、领域逻辑、验证和评估(evals)。开发者用 Cayu 来组装和定制这套 harness,而集成运行时则在底层负责执行。
这一思路对熟悉传统机器学习工程的人并不陌生。Cayu 联合创始人的背景横跨数据科学与统计学(拥有统计学硕士与化学工程博士学位,曾从事制药与半导体制造领域的 ML 工作),其 CTO 则是国际数学奥林匹克奖牌得主、二次创业者。他们直言:在数据科学实践中,"模型只是产品的一部分,领域知识、数据管道、验证和周边软件才决定它在实际中是否有用"。如今在 Agent 领域,他们看到了相似的模式。
一个具体例子:月末结账智能体
为了说明 harness 与 runtime 的分工,Cayu 举了一个财务场景——月末结账(month-end close)智能体。
这样一个智能体需要:访问财务记录、掌握对账规则、拥有调查异常的手段,以及在过账调整前满足审批要求。这些选择属于 harness 的范畴——它们定义了智能体在特定领域中"知道什么、能做什么"。
另一边,这个智能体还需要在等待文档或审核人员时保存进度、从中断中恢复、追踪已发生的事情以及成本消耗。这些属于 runtime 的范畴。Cayu 的价值在于把这两类关注点都纳入同一个 Python 框架,避免开发者反复重建同样的组件和执行基础设施。
为什么长周期是真正的难点
Cayu 团队的架构来自于为金融、会计等运营领域构建企业级智能体的实践。他们发现一个反直觉的结论:智能体循环本身很少是最难的部分。
真正的复杂性出现在执行跨越数小时甚至数天时——大量的模型调用与工具调用、不断出现的新证据、人类反馈、各类失败、真实系统的接入,以及支出约束。更棘手的是,你需要足够的状态和证据来判断"工作是否真的已经完成"。
团队强调,这类任务仍然可以是有边界的。比如"处理这 5000 份文档"有清晰的终点线,即便到达终点需要成千上万次决策、多次暂停审核和失败恢复。正是因为反复重建这些组件和执行基础设施,团队才决定把它们整合进 Cayu。
"长周期"(long-horizon)任务与普通的单次问答或短流程自动化有本质区别。短周期任务通常在几秒到几分钟内完成,状态简单,失败可以直接重试;而长周期任务可能跨越数小时乃至数天,涉及成百上千次工具调用,期间需要持续维护上下文、响应外部事件(如人工审批、新数据到达),并在任意节点发生崩溃后都能精确恢复到断点。这对底层运行时提出了类似分布式事务的要求:幂等性(同一操作重复执行不产生副作用)、检查点(checkpoint)持久化、以及可回放的执行日志。传统的无状态 LLM 调用链无法原生支持这些特性,因此需要像 Cayu 这样的框架在执行层专门处理。
现状与下一步
Cayu 已被应用于企业级部署,但开源项目仍处于早期阶段。团队特别希望获得那些正在构建领域专用智能体的开发者的反馈。
下一步的计划是发布类似 Sierra 的 τ-bench(tau-bench)的基准测试分数,据称将在未来几周内完成。这一动作对于验证 Cayu "系统重于模型"的论点尤为关键——只有拿出可对比的评测数据,才能证明 harness + runtime 的组合确实能在真实工作流中带来可衡量的差异。
对于关注 AI Agent 落地的开发者而言,Cayu 提供了一个值得关注的架构范式:与其追逐更强的模型,不如把精力投入到上下文管理、工具编排、策略约束和结果验证这些"周边工程"上。这也呼应了当前行业越来越多的共识——Agent 的可靠性,往往决定于它的工程外壳而非底座模型。
τ-bench(tau-bench)是由 Sierra AI 发布的一套专门用于评估对话式 AI Agent 在真实业务场景中可靠性的基准测试。与 MMLU、HumanEval 等侧重知识或编码能力的基准不同,τ-bench 模拟零售、航空等行业的客服任务,要求 Agent 在多轮对话中准确执行数据库查询、遵守业务规则并正确处理边界情况,最终以任务完成率(pass rate)作为核心指标。因为该基准直接测量 Agent 在结构化工作流中的执行准确度而非单纯的语言质量,对于 Cayu 这类强调"系统工程决定可靠性"的框架来说,τ-bench 分数具有较强的说服力——高分意味着 harness + runtime 的组合确实能将模型能力转化为稳定的业务执行结果。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。