CCPS采样法:保留推理多样性,无需微调提升LLM表现
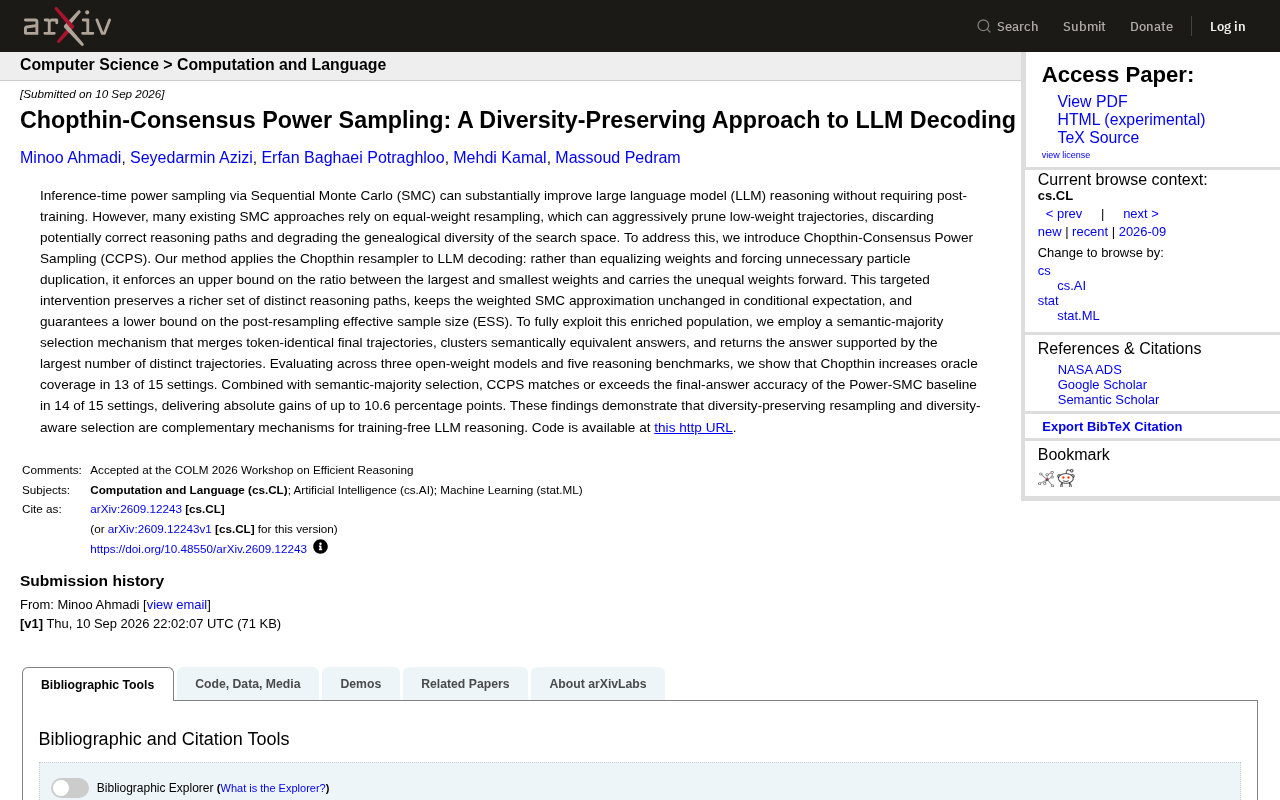
CCPS通过Chopthin重采样与语义多数选择,在无需训练的前提下显著提升LLM推理准确率。
这篇论文针对LLM推理时序列蒙特卡洛(SMC)方法中长期被忽视的缺陷展开研究:传统等权重重采样在拉平粒子权重的过程中,会激进地剪除低权重推理轨迹,导致搜索空间的谱系多样性急剧下降,进而错失潜在的正确答案路径。论文提出的CCPS方法从两个环节协同解决这一问题:一是引入Chopthin重采样器,通过对最大与最小权重之比设置上界而非强制拉平,保留更多不同的推理路径,同时在数学上保证有效样本量(ESS)的下界;二是设计语义多数选择机制,对最终候选答案先去重、再语义聚类,以独立推理路径的数量投票决定最终输出。实验在三个开放权重模型和五个推理基准上验证,CCPS在15个测试设置中的14个达到或超越了Power-SMC基线,最高绝对提升达10.6个百分点,且全程无需任何模型微调。
一个被忽视的问题:重采样如何扼杀正确答案
大语言模型在推理任务上的表现,很大程度上取决于推理时的采样策略。近年来,基于序列蒙特卡洛(Sequential Monte Carlo, SMC)的推理时功率采样(power sampling)成为热门方向——它能在不进行任何后训练的前提下,显著改善LLM的推理能力。
但这类方法有一个长期被忽视的缺陷。许多现有的SMC方案依赖等权重重采样(equal-weight resampling),即在采样过程中把所有保留下来的轨迹权重拉平。这种做法看似简洁,却会激进地剪除低权重轨迹。问题在于,一条当前权重较低的推理路径,未必就是错误的路径——它可能正是通向正确答案的关键分支。等权重重采样把这些潜在正确的推理路径直接丢弃,导致搜索空间的**谱系多样性(genealogical diversity)**急剧下降。
换句话说,模型在推理时可能过早地"押注"到少数几条高权重路径上,反而错失了本可以答对的机会。
CCPS的核心思路:不拉平,只设上限
arXiv上的这篇新论文提出了 Chopthin-Consensus Power Sampling(CCPS),试图从两个环节同时解决多样性丢失的问题。
Chopthin重采样器:让权重带着差异往前走
CCPS 的第一项创新是把 Chopthin 重采样器引入LLM解码过程。它与传统等权重重采样的关键区别在于处理权重的方式:
- 传统方法:把所有权重拉平(equalize),并强制复制粒子(particle duplication),这一过程本身就是信息损失的来源。
- Chopthin做法:不做拉平,而是对最大权重与最小权重之间的比值设定一个上界,同时把这些不相等的权重继续向前传递。
这个针对性的干预带来了三重好处:一是保留了更丰富的、彼此不同的推理路径;二是在条件期望上保持加权SMC近似不变,也就是说数学上没有引入偏差;三是保证了重采样后的**有效样本量(ESS, effective sample size)**有一个下界,避免了粒子退化。
简单理解,Chopthin 只"修剪"极端失衡的权重,而不是把整片森林砍成同样高度的树桩。
语义多数选择:让答案由最多路径投票产生
光是保留住多样的推理路径还不够,如何从这个更丰富的"路径群体"中挑出最终答案,同样重要。
CCPS 为此设计了一套语义多数选择机制(semantic-majority selection),流程分为三步:
- 合并 token 完全相同的最终轨迹——去掉字面上的重复;
- 对语义等价的答案进行聚类——把表达不同但意思一致的回答归为一类;
- 返回由最多不同轨迹支持的答案——即让"独立推理路径的数量"来投票决定最终结果。
这套机制与 Chopthin 重采样是互补关系:前者负责在生成阶段保住多样性,后者负责在选择阶段利用多样性。论文将其概括为"保留多样性的重采样"与"感知多样性的选择"两种机制的协同。
实验结果:15个设置中14个持平或超越基线
研究团队在三个开放权重模型和五个推理基准上进行了评估,结果相当扎实:
- 仅 Chopthin 重采样,就在 15个设置中的13个提升了 oracle coverage(即搜索空间中包含正确答案的比例);
- 结合语义多数选择后,完整的 CCPS 在 15个设置中的14个,最终答案准确率达到或超过 Power-SMC 基线;
- 最大的绝对提升达到 10.6个百分点。
这些数字说明,多样性并非仅仅是"锦上添花"的指标——它直接转化为了更高的答对率。oracle coverage 的普遍提升证明了正确路径确实被更好地保留了下来,而准确率的提升则说明语义多数选择成功地把这些路径转化为了正确的最终答案。
为什么这项工作值得关注
CCPS 最吸引人的地方在于它是**训练无关(training-free)**的。它不需要对模型做任何微调或后训练,纯粹在推理阶段介入,就能榨取出模型已有的推理能力。这对于算力受限、或无法接触模型权重进行训练的场景尤其有价值。
从方法论角度看,这篇论文提供了一个清晰的洞察:在LLM推理中,过度收敛是有代价的。等权重重采样为了计算上的整洁,牺牲了搜索空间的多样性,而多样性恰恰是找到正确答案的重要资源。CCPS 通过"设权重比值上界"这一相对温和的干预,在保持SMC理论保证的同时挽回了这部分损失。
对于关注LLM推理增强的研究者和工程师,这套方法提供了可直接复用的思路。论文代码已在 GitHub 开源(github.com/MinooAhmadii/chopthin-consensus-power-sampling),感兴趣者可以进一步查看实现细节。
小结
CCPS 把"多样性保留"作为提升LLM推理能力的核心杠杆,通过 Chopthin 重采样器在生成阶段避免激进剪枝,再用语义多数选择在决策阶段充分利用多样的推理路径。两者协同,在无需训练的前提下带来了可观的准确率提升。这提醒我们,推理时的采样策略仍有很大的优化空间,而"如何管理多样性"可能是其中被低估的关键变量。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。
先修复后强化:上下文增强知识图谱推理攻克多跳问答难题
arXiv 最新论文提出上下文增强知识图谱推理框架,通过"先修复后强化"策略提升大模型多跳问答能力。在胃轻瘫与糖尿病知识图谱上,基于 Qwen3-14B 验证 CG 监督优于纯 KG 监督,修复后单跳准确率达 100%。