测试通过≠代码正确:Cursor 教你四步审查 AI 代码

测试通过不等于代码正确,AI 编程必须坚持人工审查。
文章基于 Cursor 的官方警告指出,AI 生成的代码即使测试通过也可能存在逻辑隐患,因为测试覆盖率无法穷尽边界条件,且 AI 代码表面合理容易让人放松警惕。Cursor 建议开发者采取实时监控 diff、发现偏差立即停止并纠偏、任务完成后使用 Review/Find Issues 系统检查、以及最终自己逐行阅读 diff 的闭环流程。核心观点是:AI 工具越强大,人工审查的责任越重,测试通过只是起点,真正的质量保障来自持续、有意识的人工审查。
AI 编程工具越来越普及,一个危险的错觉也随之蔓延:只要测试通过,AI 生成的代码就没问题。Cursor 官方近日发出警告——测试通过并不等于代码正确。这条来自 YouTube 的短评视频,点出了 AI 辅助编程中最容易被忽视的环节:人工审查。
测试通过只是起点,不是终点
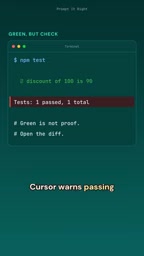
测试是验证代码行为是否符合预期的工具,但测试本身有局限。测试覆盖率再高,也无法穷尽所有边界条件;AI 生成的代码可能恰好满足现有测试用例,却在逻辑上埋下隐患。Cursor 的提醒很直接:测试通过只是基础门槛,不能作为代码正确的充分证明。
更深层的问题在于,AI 代理生成的代码往往看起来“合理”——命名规范、结构清晰——这种表面上的合理性反而让人放松警惕。开发者容易陷入“测试绿了就合并”的惯性,而忽略了逐行审视的必要性。
测试覆盖率是衡量测试用例执行代码比例的指标,通常以行覆盖率、分支覆盖率等形式呈现。然而,高覆盖率并不等同于高有效性:它只说明代码被“执行”过,却不保证所有逻辑路径和边界条件被“验证”过。例如,一个函数可能被测试调用,但测试断言并未覆盖其异常分支或极端输入。AI 生成的代码尤其容易利用这一盲区——它可能精确满足现有断言,却在未测试的路径上存在逻辑缺陷。因此,开发者需区分“覆盖率”与“测试强度”,不能将覆盖率数字视为质量证书。
实时监控:边生成边审查
Cursor 建议的第一道防线是在 AI 工作时观察 diff。这不是事后审查,而是实时监控。AI 代理在生成或修改代码时,diff 视图会同步展示每一处变更,开发者可以随时介入。
这种方法的价值在于及时性。等代理完成全部工作再回头审查,问题可能已经层层嵌套;而边生成边看 diff,能在错误刚出现时就发现它。据视频提示,不同版本的菜单布局可能有所差异,但核心操作逻辑一致:找到 diff 视图,保持关注。
Diff 视图是版本控制系统(如 Git)中用于展示文件变更的界面,通常以并排或行内对比的方式高亮新增、删除和修改的行。在 AI 编程工具中,diff 视图会动态更新,反映代理对代码库的每一步操作。它不仅是事后代码审查的工具,更可以成为实时监控的窗口——当代理在后台生成或修改文件时,diff 会同步呈现变更内容,让开发者随时掌握代理的“行为轨迹”。理解 diff 的阅读方法(如关注红色删除行、绿色新增行、上下文行)是有效实时审查的基础。
发现偏差,立即停止并纠偏
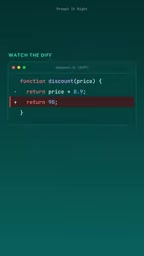
当你在 diff 中看到代理偏离预期——改错了文件、引入了不必要的依赖、或者逻辑方向跑偏——立即停止它并重新引导。这是 Cursor 强调的第二个关键动作。
这里有一个心态转变:AI 代理不是一次性的黑盒执行器,而是一个可以随时打断、纠正的协作者。很多开发者习惯让代理一口气跑完任务再看结果,但 Cursor 的建议恰恰相反:发现问题就停,把代理拉回正轨,比事后返工更高效。
停止和纠偏本身也依赖对 diff 的持续关注。如果你没有在看 diff,就很难及时发现“它在往错误的方向走”。所以第一个动作和第二个动作是连贯的:看 diff → 发现偏差 → 停止 → 纠偏。
任务完成后的逐行审查:Review 与 Find Issues
代理完成任务后,审查并未结束。Cursor 指出,可以点击 Review,再选择 Find Issues,让工具逐行检查编辑内容。这个功能相当于给 AI 生成的代码做一次系统性体检,把可能的问题标记出来。
不过 Cursor 也提醒,菜单项会随版本变化,具体位置可能不同。更重要的是,工具检查之后,开发者仍需自己阅读 diff。Find Issues 是辅助手段,不是替代品。最终判断代码是否正确、是否符合项目上下文,仍然依赖人的判断。
Find Issues 是 Cursor 内置的代码审查功能,它利用静态分析或 AI 模型对指定变更集进行扫描,标记出潜在的错误、风格问题或反模式。与传统的 linter 不同,Find Issues 更侧重于语义层面的检查,例如未处理的异常、逻辑不一致或安全漏洞。但需注意,这类工具依赖规则和模型训练数据,可能产生误报或漏报,尤其对于业务逻辑独特或上下文复杂的代码。因此,Find Issues 的输出应被视为“待核查的线索”,而非最终判决,开发者仍需结合项目背景进行人工确认。
为什么人工审查无法被替代
从这条 Cursor 的提示中可以提炼出一个核心观点:AI 编程工具越强大,人工审查的责任越重。测试、自动检查、Find Issues 都是工具层面的保障,但它们无法理解业务意图、无法判断代码在更大系统中的影响、也无法识别“测试通过但设计糟糕”的情况。
视频结尾抛出的问题值得每个使用 AI 编程的开发者思考:你的代码审查步骤是什么? 如果答案只是“看测试有没有过”,那可能需要重新设计工作流了。
一个可操作的审查闭环可以这样构建:生成时盯 diff,发现偏差立即停止纠偏,任务完成后用 Review/Find Issues 做系统检查,最后自己逐行读一遍 diff。四步下来,测试通过才真正有意义。
实践建议
- 不要等:代理工作时就关注 diff,而不是等它完成
- 敢于打断:发现方向不对,立刻停止并重新引导
- 用工具但不依赖工具:Review 和 Find Issues 是辅助,自己的眼睛才是最后一道关
- 把审查当成习惯:每次 AI 生成代码后,固定执行“看 diff → 查问题 → 读 diff”的流程
Cursor 的这条警告并不复杂,但它指向一个容易被忽视的事实:AI 代理的产出需要被监督。测试通过只是开始,真正的质量保障来自持续的、有意识的人工审查。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today