CertiSum:让MXFP4训练跨平台比特级一致
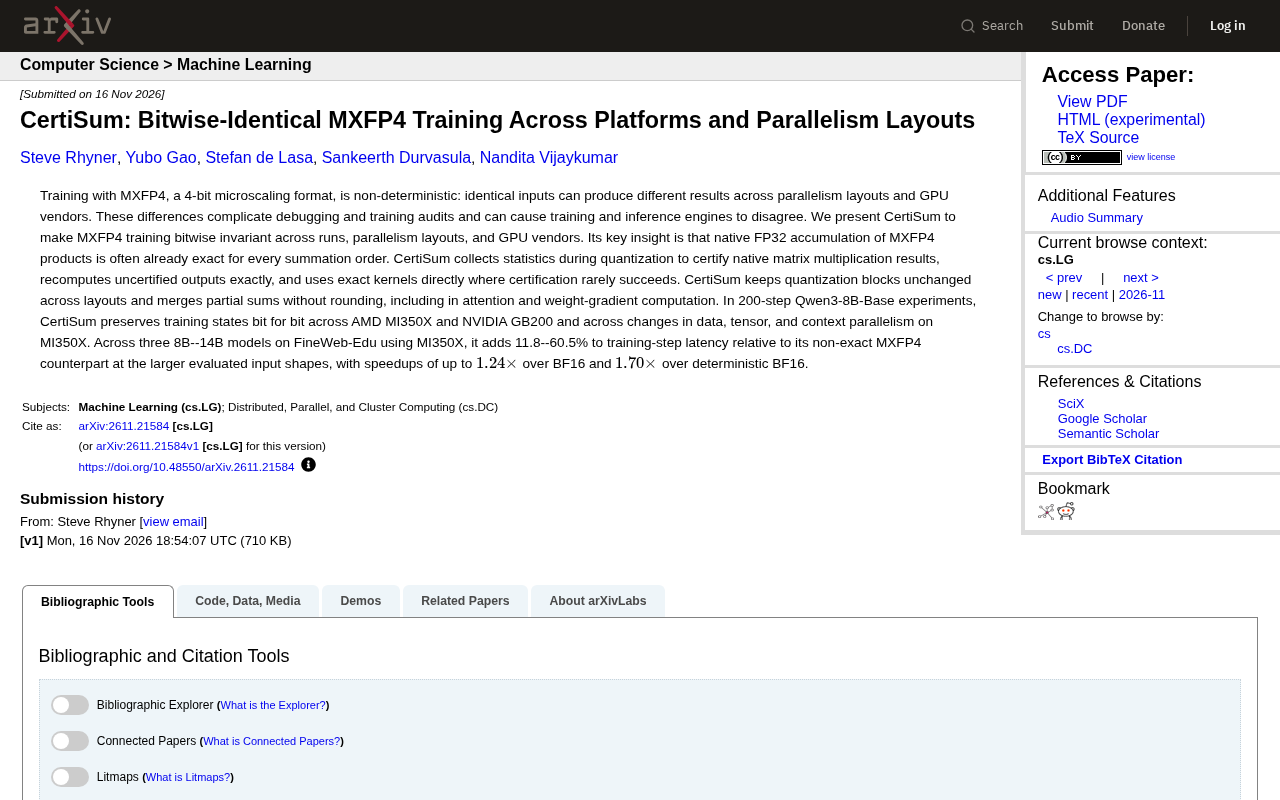
CertiSum 用统计认证加按需精确重算,让 MXFP4 训练跨硬件与并行布局比特级一致。
MXFP4 作为 4-bit 微缩放格式能显著降低显存与带宽压力,但因浮点累加不可结合,相同输入在不同并行布局或不同 GPU 厂商上会产生不同训练结果,影响调试、审计与训推一致性。CertiSum 的关键洞察是:MXFP4 乘积的原生 FP32 累加对多数求和顺序往往已是精确的。据此设计三层机制——量化阶段收集统计信息认证原生矩阵乘法是否精确,仅对未认证输出精确重算,认证极少成功时直接用精确 kernel;并在跨布局时保持量化块不变、合并部分和与注意力/权重梯度计算中不引入舍入。200 步 Qwen3-8B-Base 实验在 AMD MI350X 与 NVIDIA GB200 间、以及 MI350X 上不同数据/张量/上下文并行配置下均保持训练状态逐比特一致。代价是较大输入形状下训练步延迟增加 11.8%–60.5%,但仍比 BF16 最高快 1.24 倍、比确定性 BF16 最高快 1.70 倍。
MXFP4是一种4-bit微缩放格式,正在成为大模型训练中降低显存与带宽压力的重要选项。但它有一个容易被忽视的副作用:训练结果不可复现。相同的输入,在不同并行布局或不同GPU厂商上跑出来的结果可能不同,这给调试、审计,以及训练与推理引擎之间的一致性带来了麻烦。CertiSum的提出,就是要把MXFP4训练做成比特级不变的操作。
问题:MXFP4训练为何会“跑偏”
MXFP4的核心是将数据切成小块,每块共享一个缩放因子,块内元素用4-bit表示。这种设计在存储和计算效率上有优势,但累加过程会引入不确定性。
原文指出,使用MXFP4训练时,相同输入在不同并行布局和GPU厂商之间会产生不同结果。这种差异并非误差可忽略的抖动,而是会实际影响训练状态的一致性。对于需要审计训练过程、复现实验结果,或者要求训练引擎与推理引擎给出相同输出的场景,这是硬伤。
问题根源在于浮点累加的不可结合性:矩阵乘法的求和顺序一变,舍入误差的累积方式就变了。并行布局改变意味着归约顺序改变,不同厂商的硬件实现也可能选择不同的累加路径,结果自然对不上。
MXFP4 格式细节:MXFP4 属于 OCP(Open Compute Project)微缩放(microscaling)格式家族,每个 32 元素块共享一个 8-bit 的 E8M0 缩放因子(仅指数、无尾数),块内 4-bit 元素为 E2M1(1 符号位、2 指数位、1 尾数位),可表示 0、±0.5、±1、±1.5、±2、±3、±4、±6 等有限取值。这种块共享缩放的设计让等效位宽远低于 FP4,但块边界与归约顺序的耦合会放大布局敏感性。
浮点累加不可结合性:实数加法满足 (a+b)+c = a+(b+c),但浮点加法因每次运算后舍入到有限精度而不满足结合律。矩阵乘法的归约是一长串加法,张量并行把 K 维切分到多卡、数据并行改变批次组合顺序、上下文并行改变序列拼接方式,都会改变加法的括号结构,从而得到不同舍入轨迹。这是所有非确定性训练的数学根源,与 MXFP4 本身无关,但低精度放大了可见性。
核心洞察:FP32累加往往已经是精确的
CertiSum的关键观察颇为反直觉:MXFP4乘积的原生FP32累加,对每一种求和顺序来说,常常已经是精确的。
换句话说,很多情况下不存在需要修复的舍入误差——累加结果本身就是准确的。这个洞察把问题从“如何让浮点累加变得可结合”转化为“如何判断哪些结果已经可靠、哪些需要补救”。
基于此,CertiSum设计了一套认证机制:在量化阶段收集统计信息,用来认证原生矩阵乘法结果是否精确;对未能通过认证的输出,用精确方式重新计算;在认证很少成功的场景,则直接采用精确kernel。
为何 FP32 累加常是精确的:MXFP4 的乘积来自两个 4-bit 尾数(各 1 位显式尾数加隐含 1 位),乘积的尾数有效位数很短;而 FP32 有 24 位尾数。当块内元素数量有限(32 个)且乘积动态范围被共享缩放因子约束时,部分和与后续乘积在 FP32 中相加往往不需要舍入,或舍入误差被后续项抵消。因此对很多求和顺序,原生 FP32 累加的结果恰好等于无限精度结果——这正是认证机制能够以较低成本覆盖大多数情形的依据。
实现机制:认证、重算与精确kernel
CertiSum的运行逻辑可以拆成三层。
第一层是统计认证。 量化过程中顺带收集足够的信息,判断当前矩阵乘法输出是否落在精确范围内。这一步不改变量化块本身,因此不会引入额外的布局依赖。
第二层是精确重算。 只有未通过认证的输出才会被重新计算,从而把额外开销控制在必要范围内。这是一种按需付费的策略,而不是对所有计算一律采用精确路径。
第三层是精确kernel兜底。 在某些场景下认证极少成功,此时直接使用精确kernel比反复重算更划算。
此外,CertiSum在跨布局时保持量化块不变,并在合并部分和时不进行舍入,注意力计算和权重梯度计算中也遵循同样的原则。这几点共同保证了不同并行布局下得到相同的比特结果。
精确 kernel 与确定性 BF16 对比的含义:精确 kernel 指用更高精度(如 FP64 或带误差补偿的 FP32)执行归约、并按固定顺序累加的 matmul 实现,其代价是吞吐下降。文中“确定性 BF16”指为保证比特可复现而采用固定归约顺序的 BF16 训练路径,本身已比常规 BF16 慢;CertiSum 相对它仍有最高 1.70 倍加速,说明认证机制命中了大部分计算,精确路径只在少数情形触发。
部分和合并与注意力:张量并行下各卡算出部分和需跨卡合并,若合并时先舍入到低精度再相加会引入布局依赖;CertiSum 要求合并阶段不舍入。注意力计算中的 softmax 归约与权重梯度中的跨 token 累加同样存在归约顺序问题,需遵循同一原则才能保证端到端比特一致。
实验:跨AMD与NVIDIA的比特级一致
在200步的Qwen3-8B-Base实验中,CertiSum在AMD MI350X与NVIDIA GB200之间保持了训练状态逐比特一致;在MI350X上改变数据并行、张量并行和上下文并行配置,结果同样逐比特一致。
这意味着同一份训练配置换到不同硬件或不同并行切分方式后,不再需要担心结果漂移。对于需要跨集群复现实验或做训练审计的团队,这是实质性变化。
性能方面,原文给出了明确代价:在MI350X上使用FineWeb-Edu对三个8B–14B模型进行测试,在较大评估输入形状下,CertiSum相对非精确的MXFP4对应实现增加了11.8%–60.5%的训练步延迟;但相较BF16仍有最高1.24倍的加速,相较确定性BF16最高可达1.70倍。
这组数据说明CertiSum并非免费午餐,它的定位是在保持MXFP4相对BF16速度优势的前提下,换取比特级可复现性。是否值得,取决于场景对一致性的要求有多硬。
谁需要比特级一致的MXFP4
从原文强调的动机看,CertiSum面向几类需求:调试训练异常时排除并行布局带来的干扰,审计训练过程是否被不可复现因素污染,以及确保训练与推理引擎对同一输入给出一致结果。
多源信息中,该工作来自rss渠道的技术发布,截图与原文内容一致,未见其他独立来源的交叉佐证,因此上述性能与一致性结论均应以原文为准。
一个值得关注的方向是,低精度训练的生态正在从“能不能训”转向“训得可不可信”。MXFP4的硬件支持在扩大,但如果没有类似CertiSum的机制,跨平台结果差异会成为工程落地中的隐性成本。CertiSum给出的思路——用统计认证识别精确情形、只对不确定部分付出精确计算代价——可能被更多低精度格式借鉴。
当然,11.8%–60.5%的延迟增幅在部分对吞吐极度敏感的预训练场景中仍不可忽视。如何在认证覆盖率与开销之间取得更好平衡,是这类方法后续需要回答的问题。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。