拆解DeepEP与DeepGEMM:MoE通信与大模型矩阵计算加速实战

DeepSeek与华为昇腾联合开源DeepEP与DeepGEMM,将MoE通信带宽利用率压至理论极限90%,矩阵计算性能提升最高2.5倍。
DeepSeek与华为昇腾团队联合开源了DeepEP Ascend与DeepGEMM Ascend两个底层加速库,分别针对混合专家模型(MoE)的跨设备通信瓶颈和矩阵计算瓶颈展开优化。DeepEP基于Atlas 950 SuperPod的UB总线级互联,通过四类Buffer(EP/PP/Ingram/Bucket)管理不同通信场景,在EP Buffer中采用本地多核并行、多队列并发及UMA通信计算重叠,使关键训练通信带宽达到理论极限的90%以上。DeepGEMM的旗舰算子MegaMoE将Dispatch、MoE FFN计算、Combine融合为单一算子,由1个AIC矩阵核与2个AIV向量核协同按块流水,实现通信与计算的深度重叠,最终达到852 TFLOPS,训练场景较串行基线提升1.5倍,Decode场景提升2.5倍。两个项目共同构成了一套"软硬协同压榨硬件潜力"的工程范式。
拆解DeepEP与DeepGEMM:MoE通信与大模型矩阵计算加速实战
DeepSeek广告社区近期开源了两个面向昇腾(Ascend)平台的底层加速项目——DeepEP Ascend 与 DeepGEMM Ascend。前者专注于解决混合专家模型(MoE)的跨设备通信问题,后者则瞄准大模型训练与推理中的矩阵计算优化。这两个库是华为昇腾与DeepSeek团队深度协同的产物,试图在算力与带宽两条主线上逼近硬件的理论极限。本文将逐层拆解它们的设计思路与性能收益。
硬件底座:Atlas 950 SuperPod与UB总线互联
DeepEP的性能发挥离不开底层互联能力。整套方案基于 Atlas 950 SuperPod,依托其高速互联能力为MoE模型提供跨设备的数据分发、结果合并以及部分集合通信操作。
从拓扑来看,一个 PC16 节点由两张 950 CPU 搭配 16 张 NPU 构成,每 8 张卡组成一个 4-Mesh 框。框内每张 NPU 用 7 个 UB 口和其余 7 张卡直连,双向带宽可达 784GB/s;另有 8 个 UB 口专门用于跨框通信,双向带宽达 850GB/s。多个 PC16 可以进一步组成 UB2128 超级节点。
这里最关键的变化在于互联范式:卡与卡之间是总线级互联,而不再是传统的「网卡 + RDMA」路径。正是这种总线级直连,为后续的通信带宽压榨提供了硬件前提。在关键的训练通信用例中,通信带宽可以达到理论极限的 90% 以上。
UB(Unified Bus,统一总线)是昇腾平台特有的片间高速互联技术,与英伟达生态中的 NVLink 定位类似,但实现路径不同。传统 GPU 集群通信依赖 InfiniBand 或 RoCE 网络,数据需经过网卡(NIC)、网络协议栈再到对端,引入了协议开销与延迟。UB 总线则将多张 NPU 直接以固定拓扑连接,数据传输无需经过网络协议栈,延迟更低、带宽更稳定。4-Mesh 拓扑意味着框内每张卡与其余 7 张卡各有一条直连链路,避免了多跳转发带来的带宽折损。这种总线级互联使得通信行为可被软件精确预测与调度,是 DeepEP 能够以 90% 以上带宽利用率逼近理论极限的根本原因——在传统网络方案中,网络抖动与协议开销会使实际利用率通常只有 60%~70%。
DeepEP的四类Buffer与EP Buffer优化
DeepEP 在上述硬件基础上提供了四类 Buffer,各司其职:
- EP Buffer:负责专家并行的 Dispatch 与 Combine,同时支持 FP8 数据类型及 Cache Handle 相关操作;
- PP Buffer:负责流水线并行中的 Send/Receive 操作;
- Ingram Buffer:负责 Ingram 算法结构下的 Table 写入与按层 Fetch;
- Bucket Buffer:负责分桶相关操作。
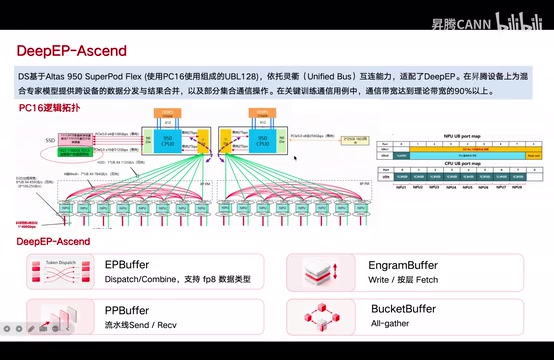
其中 EP Buffer 是性能设计的重中之重,核心目标是极致的本地处理性能与通信性能,并借助 UMA 在后台推进通信、释放 AIV 核,再通过计算与通信的并行提升端到端性能。
Dispatch与Combine的本地加速
Dispatch 在通信前需要完成统计、去重与报文组装;Combine 则可以先做本地规约再发送数据;通信完成后还有收尾的数据处理(即 Applog 阶段)。
在本地处理层面,DeepEP 做了三件事:多核并行加速统计与去重、批量组装报文以减少数据准备时间、收尾阶段通过多缓冲流水提升返存带宽利用率。
通信层面的载荷与并发优化
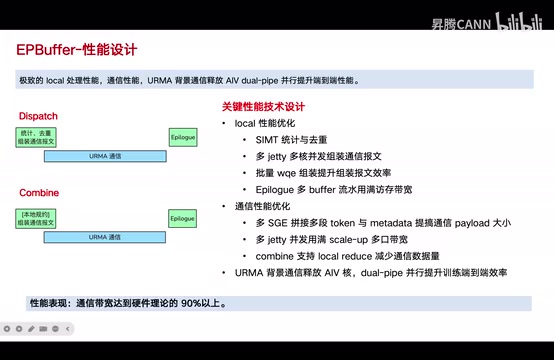
通信侧的思路是「增大有效载荷 + 多队列并发」。具体做法是把多段 Token 和原数据拼接到一次传输里,增大有效载荷;再通过多条通信队列并发利用多个互联端口的带宽。Combine 提前做本地规约也能有效减少需要传输的数据量。
叠加 UMA 在后台推进通信、释放出 AIV 核的机制,通信与计算得以重叠,最终在关键通信用例上实现了接近理论极限 90% 以上的带宽利用率。
专家并行(Expert Parallelism,EP)是 MoE 模型特有的并行维度。在密集模型中,每个 token 经过相同的 FFN 层;而在 MoE 模型中,每个 token 只被路由到少数几个专家(FFN 子网络),不同专家通常分布在不同设备上。这就产生了两个通信原语:Dispatch(分发)——将每个 token 发送到它被路由到的专家所在设备;Combine(合并)——专家计算完成后将结果汇回 token 的来源设备并加权求和。这两步通信在大规模 MoE 推理中非常频繁,且通信量随专家数和 token 数线性增长,因此成为端到端性能的主要瓶颈之一。EP Buffer 的设计目标正是针对这两个原语做极致优化。UMA(Unified Memory Access)机制允许通信在后台由专用硬件单元推进,同时释放 AIV(AI Vector)计算核执行其他工作,实现通信与计算的真正重叠。
DeepGEMM Ascend与MegaMoE融合算子
DeepGEMM Ascend 覆盖大模型训练与推理中的低精度计算以及多种专用融合算子,包括分组矩阵乘、张量计算、Logits 计算、RMSNorm 以及本次最具代表性的 MegaMoE。在 DeepSeek 团队的深度优化下,每个融合算子都几乎榨干了硬件的算力与带宽。
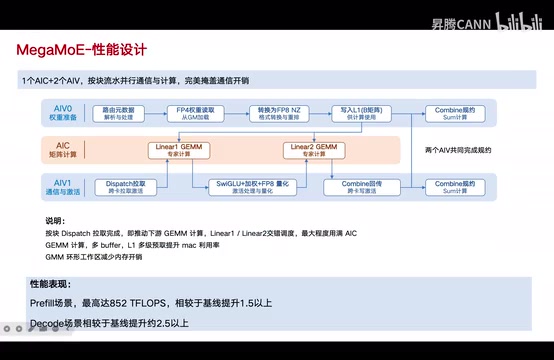
MegaMoE 的设计核心,是把通信和计算放进同一个算子里,按块(block)进行流水。它采用 1 个 AIC 加 2 个 AIV 协同工作:
- AIV0:负责权重准备,先解析数据并处理原数据,再做 FP4 权重读取、在 UB 中完成格式转换为 FP8 的 NZ 格式,最后载入 L1 供矩阵计算使用;
- AIC:负责 Linear1 的 GMM 计算与 Linear2 的 GMM 计算;
- AIV1:负责 Dispatch 拉取与激活计算,Linear1 完成后由其执行 SwiGLU、专家加权和 FP8 量化处理,再交给 Linear2;Linear2 完成后由 AIV1 完成 Combine 回传与跨卡写激活到对端。
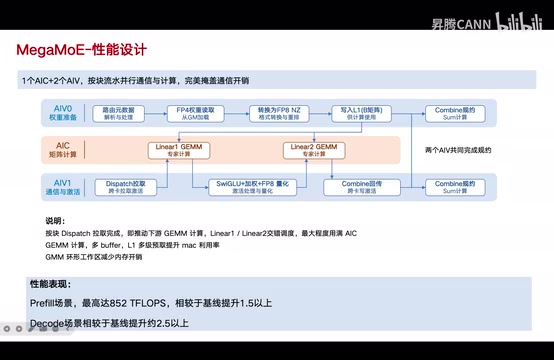
最终的 Combine 规约计算(Sum 计算)由 AIV0 与 AIV1 共同完成。整个调度的精髓在于:按块的 Dispatch 拉取推动下游 GMM 计算,Linear1 与 Linear2 交错调度,最大程度用满 Cube 算力;配合多 Buffer、L1 多级预取提升 MAC 利用率;内存处理上通过环形工作区减少开销。
性能收益
经过上述优化,MegaMoE 算子达到了 852 TFLOPS 的硬件水平。相较基线(Dispatch + MoE FFN + Combine 的串行调度):
- 训练场景提升 1.5 倍以上;
- Decode 场景提升 2.5 倍以上。
Decode 场景提升更明显,主要得益于通过单算子(「一个坑」)调度节省了大量的算子调度开销以及前置头开销。
昇腾 NPU 的计算核心分为三类:AIC(AI Core,矩阵计算核,即 Cube 核)专门执行高吞吐的矩阵乘运算(GEMM),适合大块规则计算;AIV(AI Vector Core,向量计算核)负责逐元素操作、激活函数、归一化等向量计算;AICPU 则处理标量控制逻辑。FP8 是 8 位浮点格式,相比 FP16 减少一半的内存占用和带宽消耗,同时 AIC 对 FP8 的计算吞吐可达 FP16 的两倍,是大模型低精度推理的关键数据类型。FP4 则进一步压缩权重存储,但需要在计算前转换为 FP8 格式(NZ 格式为昇腾特有的矩阵存储排布,经过转置优化以匹配 Cube 核的数据访问模式)。MegaMoE 中 AIV0 负责完成 FP4→FP8 NZ 的格式转换,正是为了把权重解压与矩阵计算的流水打满,避免 AIC 因等待数据而空转。
TFLOPS(Tera Floating Point Operations Per Second,每秒万亿次浮点运算)是衡量 AI 加速器算力利用率的核心指标。852 TFLOPS 的实测值需要对照硬件标称算力才能理解其意义——这一数字意味着 MegaMoE 算子将昇腾 NPU 的矩阵计算单元利用率维持在极高水平,基本榨干了可用算力。Decode 场景相比训练场景提升更显著(2.5倍 vs 1.5倍),原因在于推理 Decode 阶段每次只生成一个 token,算子调度本身的固定开销(启动延迟、内核加载时间)在总耗时中占比远高于训练批处理场景。将 Dispatch、MoE FFN、Combine 三个独立算子合并为一个 MegaMoE 算子后,三次独立的算子启动开销缩减为一次,这在 Decode 这种计算量相对小、调度开销相对突出的场景中收益尤为明显。
结语:软硬协同的生态探索
DeepEP Ascend 与 DeepGEMM Ascend 的核心价值,在于把 MoE 的两大瓶颈——跨设备通信与矩阵计算——分别拆开并压到硬件极限。前者靠总线级互联与通信/计算重叠,拿下 90% 带宽利用率;后者靠通算融合算子与精细调度,实现 1.5~2.5 倍的性能跃升。
这两个项目也是华为昇腾与 DeepSeek 团队深度协同、共建 AI 芯片软件生态的一次典型实践。对于关注大模型底层工程优化的开发者而言,它们提供了一套可参考的「软硬协同压榨硬件潜力」范式。
相关推荐

好莱坞的真正对手:免费内容的降维打击
Skydance 收购华纳和派拉蒙后高喊对标硅谷,但好莱坞真正的对手是 TikTok、Instagram 和 YouTube——它们几乎不为内容付费。本文剖析免费内容大军、硅谷版权侵权文化与 AI 训练数据争议背后的成本结构之战。

KernelAgent:多智能体自动优化GPU内核,跨硬件超越专家基线
Meta 推出的 KernelAgent 是一套多智能体 GPU 内核优化框架,能自动编写并优化内核,在 GPU、TPU、AMD 及 Meta 自研 AI 芯片等异构硬件上超越专家基线。本文解析其设计思路与应用价值。

Alexa Plus一年实测:智能家居之王,为何仍走不出家门?
The Verge播客实测Alexa Plus近一年:语音创建自动化场景体验出色,成为最强智能家居助手,但跨出家门做通用助理却屡屡碰壁。亚马逊500美元新平板欲补个人情境短板,苹果Siri AI也将入场,智能家居之争背后是技术成熟与隐私信任的深层张力。