拆解一套可扩展的AI Agent自动化系统架构

把采集交给Agent、后端只管派发与数据,这套开源系统演示了Agent自动化的解耦架构。
文章介绍了一位 UP 主开源的 AI 学习系统,核心思路是将 Agent 与后端数据服务拆解:后端只负责任务派发和数据管理,数据采集等易变逻辑交给 Agent 执行,从而获得更强的扩展性。演示流程为接入 Agent 并配置 DeepSeek 模型、通过模板派发 B 站视频采集任务、Agent 加载下载 Skill 调用 API 完成采集、数据入库后供学习系统阅读消化。作者强调采集仅用于个人学习,并指出这套「后端派发 + Agent 执行 + 数据回流」的骨架可复用到工作流自动化等场景,项目已开源,适合作为 Agent 应用开发的入门参考。
为什么要把 Agent 和后端拆开?
很多开发者做自动化系统时,第一反应是把采集、处理、展示全部塞进一个大程序里。B站一位 UP 主在分享自己的 AI 学习系统时,最初也走了这条路,但很快发现「全在系统内部实现缺乏扩展性」。于是他做了一个关键决定:把 Agent 和后端数据服务拆解开。
拆开之后的效果让他自己都感叹「真的太方便了」。后端只负责两件事——派发任务和管理数据;数据采集这类脏活累活,直接交给 Agent 去干。这种职责分离带来的直接收益是:想给 Agent 加功能,随时可以扩展,不用动后端一行代码。
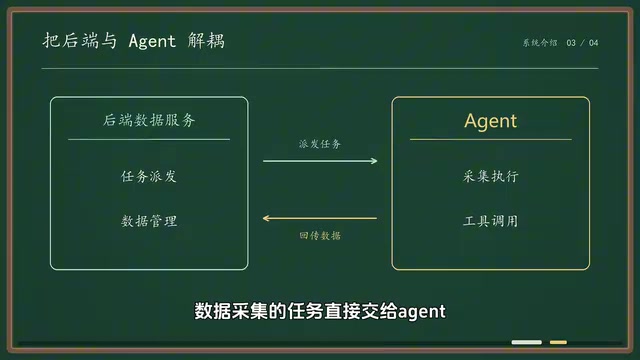
这个架构思路值得借鉴的地方在于,它把「变」和「不变」分开了。数据管理和任务调度是相对稳定的部分,而采集逻辑、外部接口对接是高频变化的部分,后者交给 Agent 这种可插拔的执行单元,系统整体的生命周期会长很多。
系统怎么跑起来:从接入 Agent 到派发任务
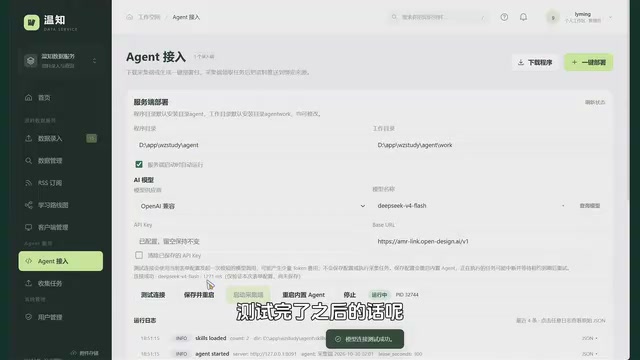
整套流程的起点是接入 Agent。UP 主演示了使用服务端内置 Agent 的方式:部署程序后,选择工作路径和 Agent 程序目录,再配置 AI 模型。他这里用的是 OpenDesign 提供的模型(DeepSeek广告),配置完成后测试连接,状态显示正常,下方还能看到实时运行日志。
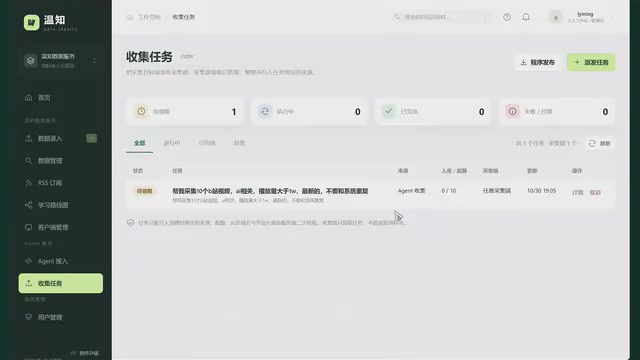
Agent 接入后,服务端定义了一套数据格式,就可以开始派发任务了。演示场景是采集 B 站 AI 相关、播放量大于 10000 的最新视频,系统里有现成模板可以一键派发。UP 主特别提到,采集用的是开源框架,「比较正规一点」,但仍然不建议大家随意去采集,仅作学习演示用途。
任务派发出去后,Agent 会加载视频下载相关的 skill,调用相应 API 查询数据,然后执行下载。这个过程中,Agent 的内置函数、MCP、Skill 等能力都可以按任务类型做针对性扩展——这也是拆分解耦带来的灵活性体现。
MCP(Model Context Protocol) 是一种为 AI 模型与外部工具、数据源之间建立标准化连接的开放协议。它由 Anthropic 于 2024 年底提出,核心思路是把「模型能调用什么」抽象成统一的 Server 接口,模型侧只需按协议发起请求,就能访问文件系统、数据库、第三方 API 等资源。对 Agent 系统而言,MCP 的价值在于解耦:新增一个外部能力时,只需部署对应的 MCP Server,Agent 端无需改代码即可发现并调用,这与文章中「后端派发任务、Agent 灵活扩展」的架构思路高度契合。
Skill 在 Agent 语境下通常指封装了特定领域操作流程的可复用能力单元,介于「单个工具函数」和「完整子 Agent」之间。一个 Skill 往往包含若干 API 调用、参数校验和结果处理逻辑,Agent 根据任务类型动态加载对应 Skill,从而避免把全部能力塞进系统提示词。文章提到的「加载视频下载相关 skill」正是这个机制:采集任务需要下载能力,就挂载下载 Skill,任务结束后即可卸载,既节省上下文又便于按需扩展。
数据落地之后:采集只是手段,学习才是目的
Agent 采集完成后,数据会进入系统的数据管理模块。UP 主在演示中打开任务详情,可以看到任务加载了哪些 skill、调用了哪些接口,最终视频数据会出现在列表里。
他强调了一个使用边界:采集这些数据的目的「是为了学习,并不是为了做其他方面的事情」,只是想看看最新、符合自己胃口的视频内容,然后直接通过学习系统去阅读和消化。这个定位其实挺清醒的——自动化采集容易滑向灰色地带,明确用途能让工具停留在合理范围内。
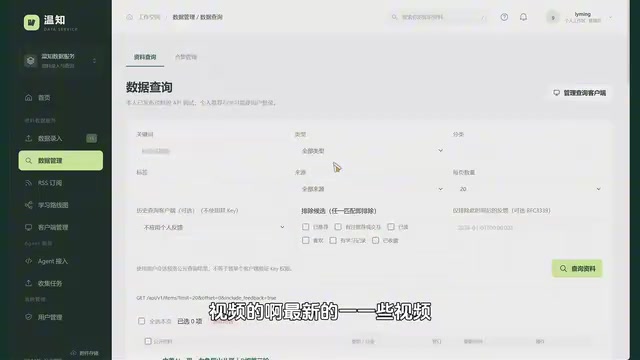
从产品体验角度看,这套系统把「采集—管理—学习」串成了一条闭环。用户不需要在多个工具之间跳转,Agent 在后台跑完任务,结果直接呈现在学习界面里,这种一体化体验是小脚本拼凑不出来的。
B 站视频数据采集 的技术路径通常有两条:一是调用 B 站开放平台或第三方封装的开源 API 查询视频元信息(标题、播放量、发布时间等),二是通过视频解析接口获取播放地址后下载媒体文件。文章提到的「开源框架」多指后者这类封装了请求签名、分页、去重逻辑的采集库。需要注意的是,B 站用户协议对自动化抓取有明确限制,播放量、评论等数据属于平台资产,高频请求容易触发风控甚至法律风险。因此原文强调「仅作学习演示」,实操时应控制请求频率、遵守 robots 协议,并将数据用途限定在个人学习范围内。
这套模式的复用价值:不止于数据采集
UP 主在实践后有一个值得注意的发现:这套 Agent 接入模式「不只是可以用来数据采集」。他打算在系统里做一个电子流(工作流),再让 Agent 去自动化执行,这是后续的规划方向。
换句话说,后端派发任务 + Agent 执行 + 数据回流的这套骨架,可以复用到任何需要「自动化执行 + 结果管理」的场景。数据采集只是第一个落地用例,工作流自动化是第二个。对于想入门 Agent 应用开发的开发者来说,这种「先跑通一条链路,再横向复制」的路径,比一上来就设计一个大而全的框架要务实得多。
项目本身是开源的,UP 主在视频末尾放出了源码地址,欢迎访问下载。如果你正在寻找一个 Agent 自动化系统的入门参考,这套拆解思路和可运行的代码,是比纯理论文章更好的起点。
几点实践建议
基于这套系统的演示,可以提炼几个落地时值得注意的点。模型接入环节要留好测试和日志,UP 主演示时连接状态和运行日志都是可见的,出问题时排查成本会低很多。任务模板能显著降低使用门槛,把常见采集需求做成模板,用户一键派发即可。Skill 和 MCP 的扩展性要提前规划,别等需求来了再重构。采集行为要设定明确用途和边界,避免工具被滥用。
Agent 应用开发的门槛正在快速下降,但真正拉开差距的,是对系统边界的判断——哪些交给 Agent,哪些留在后端,这套系统给出了一个清晰的答案。
相关推荐

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。
Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。