长时程智能体RL:别盯tokens/s,盯训练器空转

长时程agentic RL中tokens/sec会掩盖训练器空转,应按完成顺序取组并隔离资源。
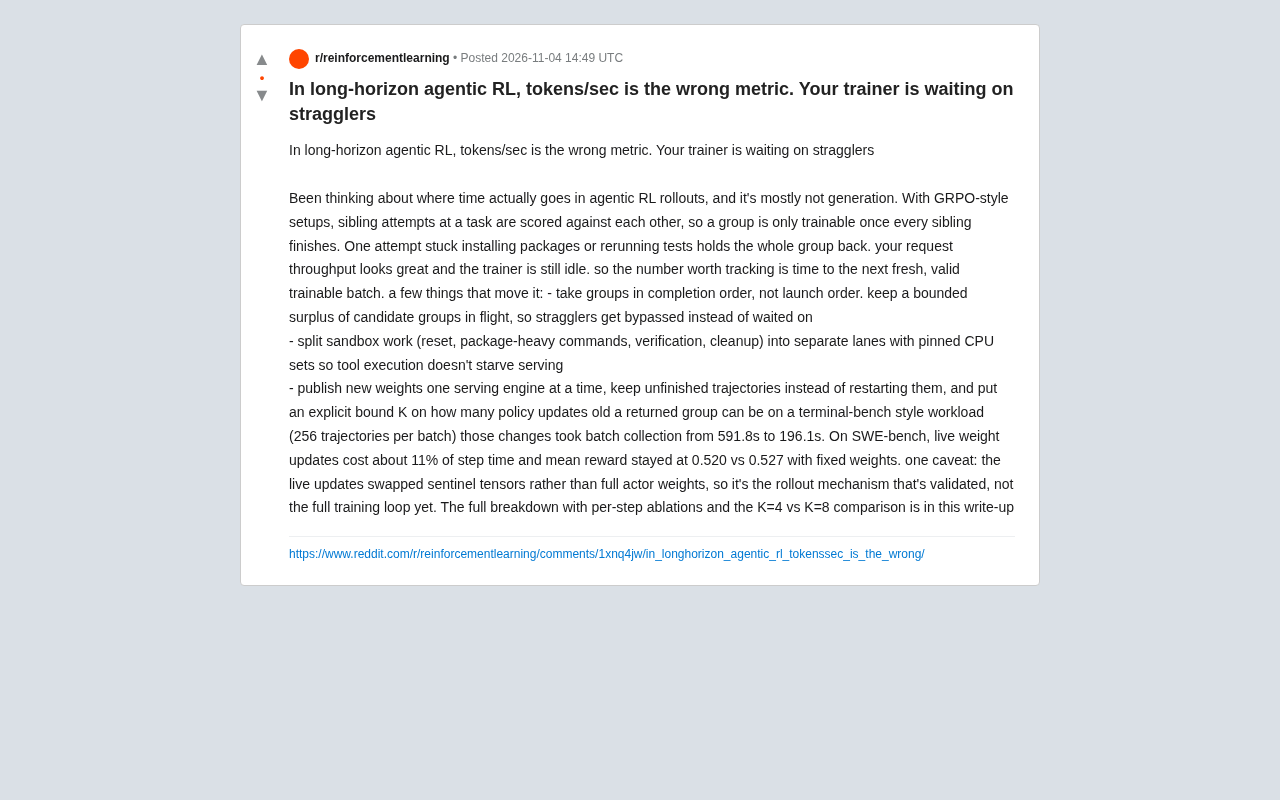
文章指出,在GRPO-style的长时程智能体强化学习中,tokens/sec是误导性指标:组内所有兄弟尝试必须全部完成才能训练,只要一条轨迹卡在装依赖或跑测试上,整组停摆,吞吐数字却依然好看。真正该跟踪的是生成下一个新鲜、有效、可训练batch所需的时间。为此原文给出三条工程手段:按完成顺序而非启动顺序取组,并保持有界surplus以绕过straggler;把沙箱重置、验证、清理拆到独立lane并绑定CPU集,避免工具执行抢占serving资源;逐serving引擎滚动发布权重并保留未完成轨迹,同时对旧策略设置上界K。在terminal-bench风格负载下,batch收集时间从591.8秒降至196.1秒。SWE-bench上live update约占step时间11%,reward 0.520对0.527,开销可控,但作者提醒其替换的是sentinel tensors而非完整actor权重,验证的是rollout机制而非完整训练循环。
为什么tokens/sec会骗人
在长时程智能体强化学习(agentic RL)中,大家习惯用tokens/sec衡量推理效率。但最近Reddit上的一篇分析指出,这个指标在GRPO-style训练里基本是误导。原因在于组内样本必须全部完成才能训练:一个任务会生成多个兄弟尝试(sibling attempts),它们互相评分,只有全部结束,整组才可训练。
只要有一个尝试卡在安装依赖或反复跑测试上,整个组就停摆。此时请求吞吐看起来很高,训练器却处于空闲等待。所以真正该跟踪的指标是:生成下一个新鲜、有效、可训练batch所需的时间。
GRPO(Group Relative Policy Optimization)是一种无需 critic 网络的策略优化算法,其核心思想是为同一 prompt 采样一组(group)多个候选回答,用组内奖励的相对排名(而非绝对值)来估计优势函数。这种设计省去了价值模型,但代价是组内样本必须全部生成完毕才能计算均值和方差、进而归一化优势。在 agentic RL 场景中,每个候选回答不是一次前向,而是一整条多步工具调用轨迹(安装依赖、跑测试、读写文件),耗时差异可达数十倍,于是组内最慢的那条轨迹就成了整个 batch 的瓶颈。理解这一点就能明白:tokens/sec 统计的是模型出 token 的速率,而训练真正等待的是最慢轨迹的完成,两者之间没有因果关系。
三个改变batch收集效率的工程手段
针对straggler拖慢训练的问题,原文给出了三条可落地的优化路径,且都围绕“缩短等待”展开。
按完成顺序取组,而非启动顺序
不要按启动顺序等待组完成,而是按完成顺序取组。同时在飞保持一个有界的候选组盈余(bounded surplus),让慢组被绕过而不是被等待。这相当于在调度层引入流水线,用少量额外并发换取训练器持续有活干。
Straggler(掉队者)源自分布式计算中的术语,指集群里完成速度显著慢于同侪的节点或任务,整体作业时间往往由它而非平均值决定。在 GRPO-style 的组采样里,straggler 表现为某条轨迹反复重试、卡在环境安装或长尾测试上,而它所在组的其他兄弟尝试早已就绪。bounded surplus(有界盈余)是一种经典的容错调度手段:在飞任务数允许超过目标 batch 所需数量,但设一个上限,超出的部分按完成顺序回收组,慢组继续在后台跑而不阻塞训练器。上限的作用是防止内存与沙箱资源被无限占满。本质上这是用少量额外并发(surplus)换取对长尾延迟的容忍度,属于延迟隐藏而非延迟消除。
把沙箱工作拆到独立lane
把沙箱里的重置、重包命令、验证、清理等操作拆分到独立的lane,并绑定CPU集(pinned CPU sets),避免工具执行抢占serving资源。工具执行和模型服务争抢CPU是长时程任务中常见的隐性瓶颈。
一次一个serving引擎发布新权重
新权重逐个serving引擎发布,未完成的轨迹保留而不是重启。同时对返回组可基于多旧的策略更新设置显式上界K。在terminal-bench风格负载(每batch 256条轨迹)下,这些改动把batch收集时间从591.8秒降到196.1秒。
在 RL 训练与推理共存的架构中,actor 权重需要周期性同步到 serving 引擎(如 vLLM 实例)以生成新轨迹。若一次性整体替换权重,正在进行的轨迹必须中断重启,造成大量浪费;逐引擎滚动发布则允许未完成轨迹在旧权重上跑完。文中提到的 sentinel tensors 是一种占位/哨兵张量机制:训练侧先更新这些哨兵,由它们触发或代理真正的权重同步,从而在不复制完整 actor 权重的前提下验证 rollout 链路是否通畅。因此该实验验证的是权重更新与轨迹生成之间的衔接机制,而非包含反向传播、优化器更新在内的完整训练循环——这是解读其数据时必须注意的边界。
实测数据与一个关键caveat
在SWE-bench上,实时权重更新大约占step时间的11%,平均reward为0.520,固定权重下为0.527,差距很小。这说明live update带来的开销可控。
但作者明确提醒:实时更新替换的是sentinel tensors,而非完整的actor权重。因此验证的是rollout机制,而非完整训练循环。K=4与K=8的对比以及逐步消融的完整拆解在原文write-up中。
对做agentic RL团队的启示
第一,监控指标要从吞吐转向“训练器空闲时间”或“下一可训练batch延迟”。第二,调度策略上要允许有界乱序,用surplus换straggler容忍度。第三,资源隔离不能只停在GPU层,CPU绑核与lane拆分同样影响端到端效率。
长时程任务的长尾不可避免,工程上的重点是让长尾不阻塞主流。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。