超越CLIP:少样本缺陷检测的校准决策模型

Jev与Clef-Flash在每类仅2张参考图下超越CLIP,实现少样本工业视觉检测。
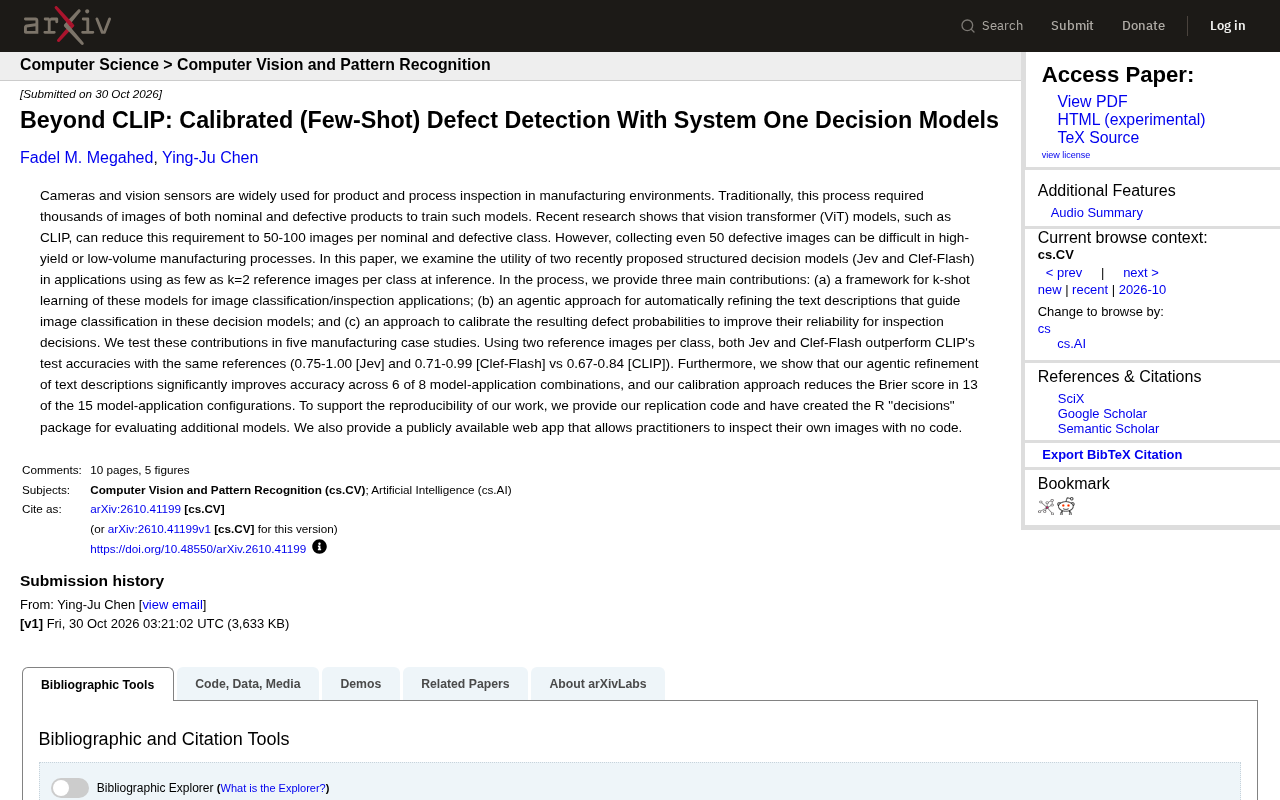
论文针对高良率或小批量生产中缺陷样本极度稀缺的问题,提出每类仅用k=2张参考图像进行视觉检测的少样本框架。研究评估了两种结构化决策模型(Jev与Clef-Flash),并贡献了三项技术:k-shot学习框架、智能体自动优化文本描述、以及缺陷概率校准。在五个制造案例中,Jev和Clef-Flash的测试准确率分别为0.75-1.00和0.71-0.99,均优于CLIP的0.67-0.84。智能体优化在8个组合中的6个提升准确率,概率校准在15个配置中的13个降低Brier分数。研究还开源了代码、R包和无代码Web应用,为少样本工业检测提供了超越CLIP的务实路径。
引言:当缺陷样本只有两张时,视觉检测怎么办?
在制造业的产品与工艺检测中,视觉传感器早已是标配。但传统深度学习模型依赖大量标注数据——动辄需要数千张正常与缺陷产品图像来训练。近年来,以CLIP为代表的视觉Transformer(ViT)模型显著降低了这一门槛,据研究可将每类所需图像降至50-100张。然而在高良率或小批量生产场景中,即便收集50张缺陷图像也困难重重。
一篇最新论文将目光投向了更极端的设定:每类仅用k=2张参考图像进行推理。研究者评估了两种结构化决策模型(Jev与Clef-Flash)在图像分类/检测中的实用性,并提出了三项核心贡献:k-shot学习框架、自动优化文本描述的智能体方法,以及缺陷概率校准技术。
从CLIP到结构化决策模型:为何需要新范式?
CLIP的零样本与少样本能力源于大规模图文对比预训练,它通过文本描述来引导图像分类。但在工业检测中,缺陷的定义往往细微且依赖上下文——划痕、色差、形变之间的界限并不总是清晰。CLIP的“系统二”式推理(类比人类慢思考)虽然灵活,却可能在少样本下不够稳定。
论文所研究的Jev与Clef-Flash属于“系统一决策模型”(System One Decision Models),强调快速、结构化的判断路径。它们同样利用文本描述作为分类依据,但通过结构化决策机制提升了在极少样本下的鲁棒性。这为高良率产线提供了一种可能:无需积累大量缺陷样本,仅凭两张参考图即可部署检测。
系统一与系统二是丹尼尔·卡尼曼在《思考,快与慢》中提出的双系统理论概念。系统一对应快速、直觉、自动化的思维模式,几乎不消耗认知资源;系统二则是缓慢、分析性、需要意志控制的推理过程。在人工智能领域,这一框架常被借用来区分两类模型:大语言模型与CLIP等往往被视为“系统二”式,依赖大规模预训练和上下文推理;而结构化决策模型(如Jev、Clef-Flash)则模仿系统一的快速判断路径,通过规则化或模板化的决策机制在少量样本下保持稳定。这种类比有助于理解为何在极端少样本工业检测中,结构化模型可能比灵活的对比学习模型更可靠——前者以牺牲部分泛化能力换取确定性。
三项核心贡献:框架、智能体与校准
k-shot学习框架
研究者提出了一个面向图像分类/检测的k-shot学习框架,系统化地定义了如何用极少参考图像配置Jev与Clef-Flash。该框架涵盖参考图像的组织、文本提示的构建以及推理流程的标准化,使少样本部署有章可循。
智能体自动优化文本描述
文本描述在决策模型中扮演关键角色——它告诉模型“什么是缺陷”。但人工撰写描述费时且依赖经验。论文提出一种智能体(agentic)方法,自动迭代优化引导分类的文本描述。实验显示,在8个模型-应用组合中,有6个组合的准确率因此获得显著提升。
缺陷概率校准
检测决策不仅需要分类结果,更需要可靠的概率估计。研究者引入校准方法,使输出的缺陷概率更贴合真实 likelihood。在15个模型-应用配置中,有13个配置的Brier分数(衡量概率预测准确性的指标)得到降低,意味着校准后的概率更可信,有助于设定合理的报警阈值。
Brier分数是评估概率预测准确性的经典指标,定义为预测概率与真实结果(0或1)之间平方误差的均值。对于二分类问题,Brier分数越低,说明模型输出的概率越接近真实 likelihood。它同时惩罚过度自信和信心不足:例如,若模型对正样本预测概率0.9,而真实标签为1,则贡献误差0.01;若预测0.6,误差则为0.16。与仅关注分类阈值的准确率不同,Brier分数直接衡量概率的可靠性,因此常用于需要设定报警阈值的工业检测场景。校准方法(如Platt缩放、等渗回归)通过后处理调整模型输出,使预测概率与经验频率对齐,从而降低Brier分数。
五组制造案例的实证结果
论文在五个制造案例中验证了上述方法。在每类仅使用两张参考图像的条件下,Jev与Clef-Flash的测试准确率区间分别为0.75-1.00和0.71-0.99,均优于CLIP在相同参考下的0.67-0.84。这一结果说明,结构化决策模型在极端少样本场景中具备明显优势。
需要强调的是,准确率区间跨度较大,反映出不同制造场景的难度差异。但整体趋势一致:Jev在多数案例中领先,Clef-Flash紧随其后,二者均稳定超越CLIP基线。
k-shot学习中的k指每个类别可用的标注样本数。在传统监督学习中,k通常为数十到数百;而k=2属于极端少样本设定,模型必须从极少量示例中归纳类别的本质特征。与零样本学习(k=0,仅靠语义描述)和单样本学习(k=1)相比,k=2提供了最微弱的视觉证据,但也引入了过拟合风险。在工业检测中,k-shot设定直接对应小批量或高良率产线切换时只能获取极少数缺陷样本的现实约束。评价k-shot方法时,通常需报告多次随机抽取参考图像后的平均性能与方差,以评估稳定性。
可复现性与工具生态
为支持复现,研究团队公开了复现代码,并发布了R语言包“decisions”用于评估更多模型。此外,他们还提供了一个公开的Web应用,让从业者无需编写代码即可用自己的图像进行检测实验。这种开放态度降低了工业界尝试新方法的门槛,也有助于推动少样本缺陷检测的标准化评估。
实践意义与局限
对于高良率、小批量或定制化生产场景,每类两张参考图的设定极具吸引力——它意味着产线切换时无需停机收集大量缺陷样本。智能体优化文本描述与概率校准则进一步提升了部署的可靠性。
不过,论文的案例研究仍限于五个制造场景,泛化到更复杂的缺陷类型(如微小裂纹、透明材质缺陷)尚需验证。此外,系统一决策模型的黑箱特性可能给根因分析带来挑战。未来工作可探索更多模型组合与跨领域迁移能力。
总体而言,这项研究为“少样本工业视觉检测”提供了一条超越CLIP的务实路径,其开源工具链值得从业者关注。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。