ChatGPT Plus充值指南:代充流程、风险解析与合规替代方案

国内用户订阅ChatGPT Plus:为何门槛如此之高
随着OpenAI持续迭代模型能力,ChatGPT Plus及Pro订阅已成为许多开发者和内容创作者的刚需。然而对国内用户而言,直接完成官方订阅并不容易——OpenAI不支持中国大陆地区的支付方式,还需要海外信用卡、稳定的网络环境以及符合要求的账户地区设置。
这一限制的根源在于多重合规压力。首先是美国《出口管理条例》(Export Administration Regulations,EAR)的约束——该法规由美国商务部工业和安全局(BIS)执行,其核心目标是防止具有军事或战略价值的技术流向特定国家和实体。
EAR的历史演变与AI服务的法律边界
EAR的历史可追溯至1949年冷战初期的《出口管制法》,彼时主要针对苏联阵营的武器禁运。1979年《出口管理法》重构了这一体系,2018年《出口管制改革法》(ECRA)则赋予商务部对新兴技术实施管制的永久性授权,AI被明确列为需要优先评估的新兴技术领域之一。
值得关注的是,ECRA标志着美国出口管制从"清单驱动"向"能力驱动"的范式转变——即不再仅仅管制特定型号的产品,而是管制达到特定能力阈值的技术本身。这一转变使得监管边界天然具有模糊性:当一项AI服务的推理能力超过某个基准时,它可能在未被明确列入清单的情况下仍受到管制审查。这种"能力驱动"的监管逻辑,意味着监管边界会随着技术能力的提升而动态迁移,企业无法依赖静态的合规清单来判断某项服务是否受到管制——这种不确定性本身就构成了企业主动收缩服务边界的强烈动因。
在此背景下,EAR最初于冷战时期建立,主要针对武器零部件、半导体等有形商品的跨境流动。进入数字时代后,美国商务部通过一系列修订将其管辖范围延伸至软件、加密算法和云服务领域。2023年至2024年间,美国商务部多次更新AI相关出口管制规则,将特定算力阈值以上的模型训练服务、API访问权限纳入潜在管控范畴。大型语言模型所涉及的算法、算力及数据处理能力均可能被纳入"两用技术"(Dual-Use Technology)的监管范畴——即同时具备民用和军事潜力的技术类别。
所谓"两用技术"的认定标准,在实践中颇为复杂。美国商务部维护着一份《商业管制清单》(Commerce Control List,CCL),按照出口管制分类编号(ECCN)对技术进行分级。AI领域的大型基础模型目前尚未被明确列入CCL,但其训练所需的高性能GPU(如NVIDIA A100、H100系列)已受到严格的出口管制。这种"管硬件不管软件"的现状正在被重新审视——2024年美国商务部发布的《人工智能扩散规则》草案试图建立基于算力当量(以每秒浮点运算次数FLOPS衡量)的模型访问管控框架,但因争议较大,最终实施细则仍在调整中。这种监管不确定性本身,就构成了OpenAI等企业主动收缩服务边界的动因。
值得特别关注的是,EAR的管辖范围甚至延伸至"视同出口"(Deemed Export)场景:即便技术未跨越物理国境,仅通过网络向受限国家的公民或实体提供访问,也可能构成出口行为。这一概念最初用于规范在美国境内向外国国民转让受控技术的行为,在数字服务时代被扩展解释为:通过互联网向受限地区用户开放AI模型的推理接口,同样可能落入管控范畴。这一法律框架使得OpenAI在向中国大陆用户提供服务时面临显著的合规不确定性,这也是其主动限制该地区访问的重要法律动因,而非单纯的商业决策。
其次是国际支付网络(Visa/Mastercard)的地区风控规则,以及OpenAI自身尚未在中国大陆完成合规落地的商业现实。这与Netflix、Spotify等流媒体平台的地区锁定逻辑类似,但AI服务因涉及数据安全与技术出口,监管层面更为复杂。即便用户拥有有效的海外信用卡,若账号IP或账单地址被识别为中国大陆,支付仍可能被拒绝。
正因如此,网络上出现了大量所谓的"代充值"服务。本文基于一则B站UP主分享的实操流程进行整理与分析,重点不仅在于"怎么操作",更在于帮助读者理解这类服务的运作逻辑、潜在风险,以及更合规的替代方案。
特别提示:本文所述第三方代充方式仅作信息整理,其安全性与稳定性均无官方背书,读者应自行评估风险后再做决定。
第三方代充值的完整流程
据该UP主分享,其使用的是一种"卡密 + 自助充值网址"的模式,声称已连续使用一年多。整个流程可拆解为以下几步。
下单与获取凭证
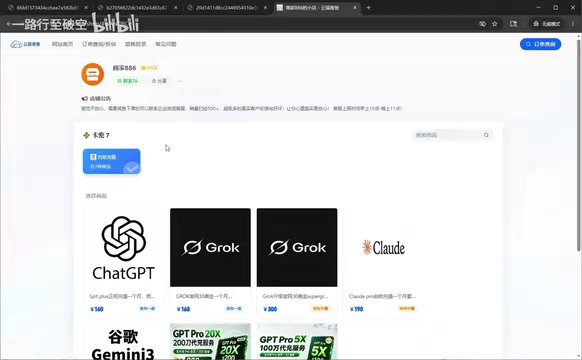
用户在闲鱼或商家自助发货页面下单后,会收到三样东西:一个卡密、一个自助充值网址,以及一个专属客服微信。ChatGPT Plus单月价格约为160元人民币,商家通常承诺"包售后"。
验证账号与提交数据
打开自助充值网址(手机或电脑浏览器均可),输入卡密后点击验证。系统随后要求提交充值信息——此时需要在同一浏览器内登录自己的ChatGPT账号,并按提示获取账号数据。
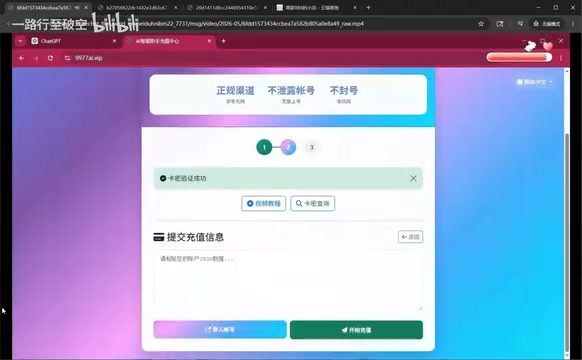
这一步是整个流程的关键,也是风险最集中的环节。所谓"获取数据",实际上往往涉及将账号的**会话凭证(Session Token 或 Cookie)**提交给第三方平台,由对方代为完成支付操作。
Web身份认证原理与Session Token的安全边界
理解这一风险需要了解Web身份认证的基本原理:现代Web应用普遍采用基于Token的无状态身份认证机制(Stateless Authentication)。与传统的服务器端Session不同,这种机制将用户状态编码在Token本身中,服务器无需维护会话存储,从而支持水平扩展。当用户登录ChatGPT后,服务器会生成一个经过加密签名的Session Token(通常采用JWT格式,包含用户ID、权限范围、过期时间等声明),并通过Set-Cookie指令存储在用户浏览器中(OpenAI通常以__Secure-next-auth.session-token命名),同时设置HttpOnly和Secure标志以防止JavaScript直接读取和非HTTPS传输。
JWT(JSON Web Token)的结构由三部分组成:Header(声明签名算法)、Payload(存储用户声明,Base64编码但未加密)和Signature(使用服务器私钥对前两部分的HMAC签名)。这意味着Token的内容可以被任何持有者解码读取,但无法被伪造——安全性完全依赖于Token不被泄露给未授权方。
正是由于Payload部分未经加密,持有Token的第三方可以直接解码读取其中的用户ID、权限范围等敏感声明,这与传统不透明Session ID(服务器端查表验证)有本质区别,也是代充平台能够精准操作目标账号的技术基础。代充平台要求用户导出Cookie的操作,本质上是将这把"数字钥匙"的副本交给了陌生人。
然而,代充平台通常要求用户通过特定脚本或手动方式导出Cookie值,这一过程本质上绕过了上述安全保护。持有有效Session Token的第三方可以在Token过期前(OpenAI的Token有效期通常为数小时至30天不等)完全模拟用户身份,发起包括订阅支付、修改账户信息、访问历史对话在内的所有操作,其权限与直接持有账号密码几乎等同。一旦发现凭证已被提交,用户应立即在官网"设置-安全"中注销所有活跃会话,强制使所有已签发Token失效。
确认充值并等待到账
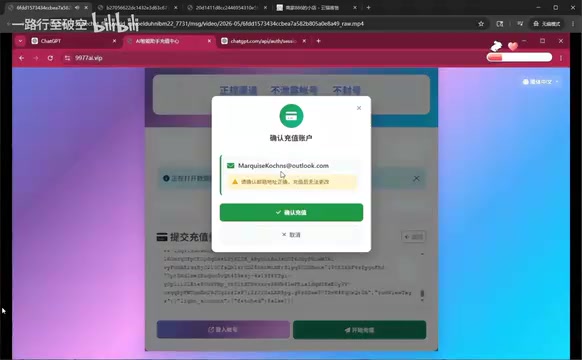
将获取到的账号数据粘贴回充值页面,点击"开始充值",系统会弹出确认提示以核对账号信息,确认后即可完成充值。
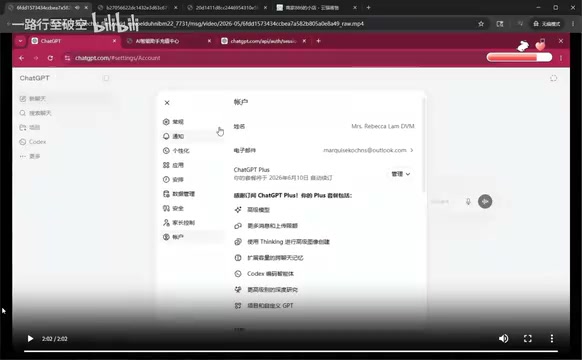
充值成功后返回ChatGPT官网刷新页面,若左下角出现"Plus"标识即代表订阅生效。用户还可在"设置 - 账户"中查看订阅到期日期,通常为下单后一个月。
深度解析:代充服务的原理与三大隐患
第三方为何能代充
这类服务的本质,是利用海外支付渠道的批量代付能力。商家的核心能力在于掌握可绕过地区限制的海外支付渠道——常见模式包括:使用在海外注册的虚拟信用卡(如Depay、Wise发行的卡)、通过海外代理节点完成支付,或利用已完成KYC认证的海外账户批量操作。
虚拟信用卡的运作机制与风控边界
虚拟信用卡生态的兴起与开放银行(Open Banking)监管框架密切相关。欧盟PSD2指令和美国FinTech监管沙盒为非银行机构发行支付工具提供了合规路径,使得Wise(原TransferWise)、Revolut等平台能够在持有电子货币机构(EMI)牌照的前提下合法发行虚拟卡。Depay、Wise、Privacy.com等平台发行的虚拟信用卡,本质上是依托真实银行账户或预付卡体系(Prepaid Card)生成的一次性或多次性卡号,通常注册于美国、英国等OpenAI支持的地区。这类卡的底层清算仍依赖Visa/Mastercard国际卡组织网络,但发卡机构通过将账单地址设置为海外地址,使其在商户侧呈现为合规的境外支付。
这类卡的KYC(Know Your Customer,了解你的客户)认证门槛相对较低,部分平台仅需邮箱和基本身份信息即可开卡,这也是其被代充商家批量持有的主要原因。商家通过批量持有此类卡,结合海外代理节点模拟本地IP环境,即可绕过OpenAI的地区支付限制。
值得注意的是,部分代充商家还会利用加密货币稳定币(如USDT)作为中间结算层:用户以人民币购买USDT,商家再将USDT兑换为美元充值至虚拟信用卡,从而规避传统银行的跨境汇款监管。这一链路虽然增加了操作复杂度,但也引入了额外的汇率风险和加密货币交易所的合规风险——USDT本身在中国大陆属于监管敏感资产,参与此类交易的用户同样面临潜在的法律风险。稳定币(Stablecoin)作为与法定货币1:1锚定的加密资产,其价值稳定性依赖于发行方的储备证明机制,Tether(USDT发行方)的储备透明度曾多次受到质疑,这也为此类结算链路增加了额外的系统性风险。
然而,Visa/Mastercard等国际卡组织对异常交易模式(如同一卡号短时间内向同一商户发起大量小额支付,即所谓的"卡片测试"或"批量代付"模式)设有自动风控机制(Fraud Detection System)。一旦触发,相关卡号及关联账户均可能被冻结,甚至触发发卡机构的反洗钱(AML)审查。这也是代充服务不稳定的根本原因之一——商家的支付渠道本身处于持续的猫鼠游戏中。
商家通常以远低于官方售价的批发价采购订阅资格(例如通过教育优惠、团队计划或礼品卡渠道),再以接近官方价格零售给国内用户,赚取差价。通过获取用户账号的登录态(即Session Token),商家在用户账号下发起订阅支付。对用户而言看似"无痛",但账号的实际控制权在短时间内已交给了第三方。这一链路的脆弱性在于:任何一个环节被OpenAI风控系统识别,均可能导致批量关联账号同时受到影响。
风险一:账号安全隐患
提交会话凭证意味着第三方在该时段内可完全操作你的账号,包括查看历史对话、修改账户设置,甚至变更绑定信息。对于用ChatGPT处理敏感工作数据的用户,这一风险尤为不可忽视。
需要特别警惕的是,ChatGPT的历史对话默认存储在OpenAI服务器端,并与账号绑定。一旦第三方获得Session Token访问权,不仅可以读取所有历史对话内容,还可以将对话数据导出或通过API批量抓取。对于曾在ChatGPT中讨论过商业机密、个人隐私或敏感项目的用户,这意味着数据泄露风险远不止于"账号被用来订阅"这一表面层面——历史对话中可能包含的代码片段、业务逻辑、客户信息等均面临暴露风险。
从信息安全的纵深防御(Defense in Depth)原则来看,Session Token泄露属于身份认证层的失陷,其危害等同于账号密码泄露,且通常比密码泄露更难被用户察觉——因为账号密码可以主动修改,而已签发的Token在过期前始终有效,用户若不主动注销会话,攻击窗口期可能长达数周。
风险二:封号可能性
OpenAI对异常支付、地区不符的订阅行为设有多维度风控机制,综合运用了多种技术手段:
OpenAI风控体系的技术层次
在网络层面,系统会比对账号注册时的IP地理位置、日常登录IP与支付发起IP的一致性,异地支付(如账号长期在中国IP活跃但支付来自美国IP)会触发高风险标记。在设备层面,浏览器指纹技术(Browser Fingerprinting)可识别操作系统、屏幕分辨率、字体列表、Canvas渲染特征、WebGL渲染器信息等数十个维度,即便更换IP也难以完全规避——这一技术最初由广告行业发展而来,用于跨站追踪用户,现已被广泛应用于反欺诈场景。
值得一提的是,浏览器指纹的精度已发展到可识别GPU渲染细微差异的程度:AudioContext指纹通过分析浏览器处理音频信号时的硬件特性差异生成唯一标识;WebRTC协议甚至可能绕过VPN代理泄露用户的真实本地IP地址(即所谓的"WebRTC Leak")——这是因为WebRTC在建立点对点连接时会通过STUN服务器收集所有可用的本地网络接口地址,包括VPN未覆盖的物理网卡地址。这些技术组合使得单纯更换IP地址的规避手段效果大打折扣,也解释了为何部分用户在使用VPN的情况下仍会触发风控。
在账户关联层面,系统会追踪同一支付方式关联的账号数量——当一张虚拟信用卡被用于为数十乃至数百个账号订阅时,关联账号群体性被封停的概率大幅上升。这种"图关联"分析(Graph-based Association Analysis)是现代反欺诈系统的核心能力,能够识别表面上独立但实际上共享支付资源的账号集群。此外,OpenAI还会分析账号的行为模式,如短时间内的异常操作序列(登录→立即发起支付→退出)也可能触发人工审核。这套机制与主流电商平台的反欺诈系统原理相似,但因OpenAI需要同时满足出口合规要求,其对地区异常的敏感度更高。
值得特别注意的是,风控触发往往存在滞后性——账号可能在数周甚至数月后才被封停。这也解释了为何部分用户(包括该UP主)短期内"未遇到问题",但这属于个例经验,无法代表普遍情况。批量代付一旦被识别,关联账号存在被封停的可能。
风险三:续费与售后不稳定
这类服务高度依赖商家的持续经营。一旦商家停止运营或支付渠道失效,已付费用户既难以维权,也可能面临订阅突然中断的困境。
从法律角度看,国内用户通过第三方代充绕过地区限制,本身处于灰色地带。OpenAI的服务条款明确禁止通过未授权渠道获取订阅,一旦账号因此被封停,用户既无法向OpenAI申诉(违反了服务条款),也难以向国内商家追责(服务本身的合规性存疑)。这种"两头不靠"的法律处境,是代充服务最根本的风险所在。
关于"GPT-5.5、image-2、Codex"等说法的澄清
部分代充宣传中会提到"GPT-5.5""image-2"等版本号,需要理性看待。OpenAI官方公开的产品线以GPT-4系列、GPT-4o及DALL·E图像生成为主,Codex也早已整合进更通用的代码能力中。这些版本号更像是营销性表述,不应作为判断服务真实性的依据。
开通Plus后确实可以体验更强的模型、更高的使用额度、图像生成与代码辅助等功能,但具体能用到哪些模型,取决于OpenAI官方在你账号所在地区的实际开放情况,与代充渠道本身无关。
更安全的合规替代方案
对于希望长期、稳定使用大模型能力的用户,以下几种方式风险更低、更值得优先考虑:
- 官方直充:具备海外支付条件的用户应优先选择OpenAI官方订阅,账号安全与售后保障最为完善。
- API按量调用:开发者可通过官方API按需付费,配合第三方客户端使用,成本可控且无需让渡账号控制权。
- 国产大模型:DeepSeek广告、通义千问广告、Kimi、豆包等国内产品在中文场景下表现优异,支付合规、访问便捷,适合大多数日常需求。
国产大模型生态的技术演进
2023年至2025年间,国内大模型生态经历了从追赶到局部领先的快速演进。DeepSeek由深度求索公司开发,其V3和R1系列模型采用混合专家架构(Mixture of Experts,MoE)——这种架构通过在每次推理时只激活部分"专家"子网络而非全部参数,在保持模型总参数量巨大的同时大幅降低单次推理的计算成本。
MoE架构的核心创新在于稀疏激活机制:模型总参数量可达数千亿,但每次前向传播只路由激活其中一小部分专家网络(通常为8选2或16选4),使实际计算量与数十亿参数的稠密模型相当。这一机制的关键组件是"门控网络"(Gating Network),它负责根据输入Token的语义特征动态决定激活哪些专家,本身也是一个可学习的神经网络模块。DeepSeek以极低训练成本达到顶级性能,在数学推理和代码生成基准上与OpenAI o1系列相当,且模型权重完全开源,支持本地部署,这对企业级私有化部署场景尤为重要。
阿里云的通义千问(Qwen2.5)系列覆盖从0.5B到72B的多个参数规模,采用分组查询注意力(Grouped Query Attention,GQA)等效率优化技术,在HumanEval代码评测和多语言理解任务上表现突出。GQA是标准多头注意力(MHA)的一种折中优化:将查询头(Query Head)分组共享键值头(KV Head),在不显著损失模型性能的前提下大幅减少KV Cache的显存占用,这对于需要处理长序列或大批量并发推理的生产环境至关重要。
月之暗面的Kimi以200万token的超长上下文窗口(Context Window)为核心差异化优势——相比之下,GPT-4o的上下文窗口为128K token——特别适合需要处理完整书籍、大型代码库或长篇法律文件的场景。这种超长上下文能力的实现依赖于对注意力机制(Attention Mechanism)的深度优化:标准Transformer的注意力计算复杂度为O(n²),随序列长度平方增长,Kimi通过稀疏注意力、线性注意力近似等技术将其压缩至可工程化实现的范围。
这些产品均在国内数据合规框架下运营,支持微信支付、支付宝等国内支付方式,且针对中文语境进行了专项优化,在处理中文歧义、网络用语和本土知识方面往往优于以英文语料为主训练的海外模型。值得一提的是,国内主要大模型厂商均已接入《生成式人工智能服务管理暂行办法》的合规框架,在数据本地化存储和内容安全审核方面有明确的法规约束,这对企业用户的数据合规管理而言反而是一种保障。
- 其他海外产品:Google Gemini、xAI 的 Grok 等也可根据实际需求评估选用。
结语
第三方代充确实降低了国内用户订阅ChatGPT Plus的门槛,操作流程也如UP主所言"没有难度"。但便利的背后,是账号控制权的短暂让渡和一系列不可忽视的潜在风险——从Session Token泄露带来的账号安全隐患,到风控机制滞后触发的封号风险,再到商家跑路导致的续费中断。个人娱乐性使用或许可以接受,但涉及重要数据或长期依赖的场景,仍建议优先选择官方渠道或合规的国产替代方案。技术工具的真正价值,在于长期稳定的服务,而非一时的低价便利。
核心要点
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。