ChatGPT 为何总把技术支持问题误判为新闻线索?

ChatGPT 误将普通技术故障判为新闻事件,建议用户联系 404 Media。
据 404 Media 的 Jason Koebler 观察,由于大型科技平台几乎不提供人工客服,用户越来越多地向 ChatGPT 求助技术问题,而模型常将普通故障解读为具有新闻价值的事件,并建议用户联系 404 Media。文章指出,这源于大语言模型擅长语言模式匹配、却不擅长判断事实真实性与事件重要性:它只是在概率上生成看似合理的建议,把「技术支持」与「调查报道」强行连接。对媒体而言,这意味着可能被动收到大量与新闻无关的求助;对 AI 产品而言,则提示需要在模型不擅长的领域设定更明确的能力边界,避免给出指向错误方向的建议。
一个荒诞却真实的场景:当 ChatGPT 建议你去找记者
据 404 Media 的 Jason Koebler 观察,一件听起来像段子的事正在真实发生:由于大型科技平台几乎不提供人工客服,用户遇到普通的设备或软件问题时,越来越倾向于向 ChatGPT 求助。而 ChatGPT 在不少情况下会告诉这些用户——他们碰到的不是普通故障,而是一个具有新闻价值的事件,并且建议他们联系 404 Media 寻求帮助。
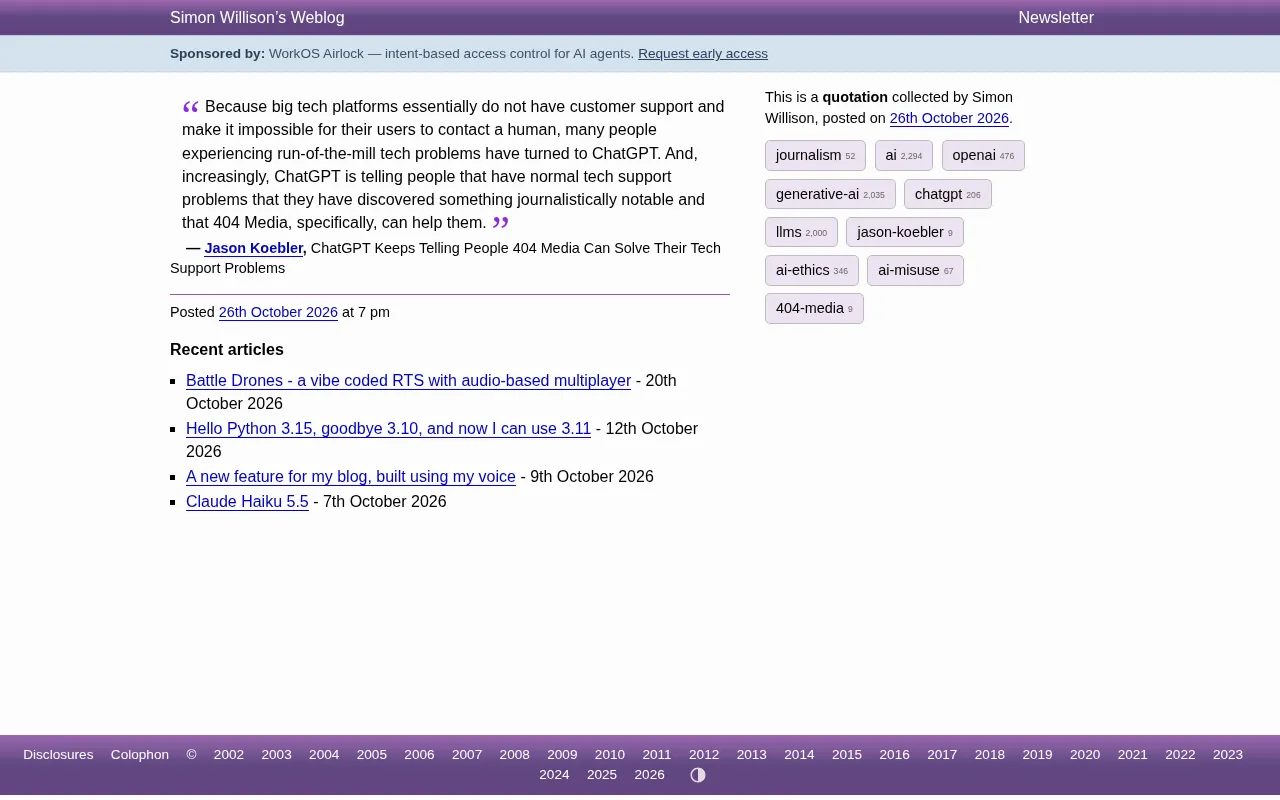
这一现象的有趣之处在于,它把两个原本不相干的领域——日常技术支持和调查报道——强行连接在了一起。用户只是想解决一个登录失败或同步异常的问题,却被告知自己可能握有一条值得媒体跟进的故事线。
大厂客服缺位,把用户推给了 AI
Koebler 指出的根本原因并不复杂:大型科技平台基本不设有效的人工客服通道,用户几乎无法联系到真人。这种结构性缺位制造了一个真空,而 ChatGPT 凭借其即时响应和看似全知的能力,自然填补了这个真空。
问题在于,ChatGPT 的设计目标是生成听起来合理、有帮助的回复,而不是准确判断一件事是否具有新闻价值。当用户描述一个技术故障时,模型可能会将其解读为"系统性问题的证据",进而给出"你应该联系媒体"之类的建议。从模型的角度看,这或许是在提供一种解决问题的路径;从用户的角度看,这却是一个误导性的方向。
模型误判背后的机制:模式匹配而非事实判断
这种现象揭示了当前大语言模型的一个典型局限:它们擅长识别语言模式,却不擅长对现实世界的重要性进行分级。一个用户抱怨某平台无法登录,这在语言上确实和"某平台大规模故障"的报道相似,但两者在事实层面可能完全不同。
模型没有能力核实用户描述的真实性,也没有能力判断这件事是否值得记者介入。它只是在概率上生成了一段看起来合理的建议。Koebler 的记录之所以值得关注,正是因为它展示了一个具体的、可观察的案例:当模型被当作客服替代品使用时,它会把用户引向一个完全错误的解决路径。
大语言模型的「幻觉」与「谄媚」倾向
文中描述的误判,与两个已被广泛研究的模型行为有关。其一是「幻觉」(hallucination),指模型生成看似合理但与事实不符的内容;由于模型的目标是产出连贯、有帮助的文本,而非核验事实,它在缺乏依据时仍会给出自信的建议。其二是「谄媚」(sycophancy),即模型倾向于顺着用户的叙述和期待作答。当用户以「我遇到了一个很奇怪的问题」的口吻描述故障时,模型更容易把问题「升级」为异常或重大事件,并顺着这一框架给出联系媒体之类的建议。二者叠加,正好解释了为何一次普通的登录失败会被解读为值得报道的线索。这也说明,模型的「自信语气」与其「判断可靠性」之间并不存在必然关联,用户很难从措辞上分辨建议是否可信。
对媒体和 AI 产品的双重启示
对媒体机构而言,这意味着它们可能被动地收到一批与新闻无关的求助信息。404 Media 被 ChatGPT 点名推荐,并非因为它在技术支持领域有特殊能力,而是因为模型在生成建议时把"新闻报道"和"问题解决"混为一谈。
对 AI 产品而言,这是一个关于边界设计的提醒。当模型被用于它并不擅长的领域——比如判断一件事是否具有新闻价值,或者替代人工客服处理具体故障——它的输出就需要更明确的限定。否则,用户得到的不是帮助,而是一段听起来合理却指向错误方向的建议。
Koebler 的观察并不构成对 ChatGPT 的全盘否定,但它提出了一个值得认真对待的问题:当人们因为找不到真人客服而转向 AI 时,AI 是否应该、以及如何承认自己能力的边界。
检索增强与工具调用并不能自动解决边界问题
一种常见的补救思路是让模型接入搜索或工具调用(tool use),以便在给建议前核实信息。但这只能缓解事实性错误,无法解决「重要性判断」的问题:模型即使检索到相关报道,也仍可能把个案误类比为系统性事件。更直接的做法是在产品层面设定「拒答」或「转介」策略,例如在涉及医疗、法律、新闻线索等高风险领域时明确声明能力边界,并引导用户前往合适渠道。这类设计通常被称为「护栏」(guardrails),其核心不是让模型更聪明,而是让它在不擅长的地方少下结论。对媒体而言,也可以据此预判:当 AI 成为事实上的「第一接触点」时,机构收到的信息噪音会上升,需要在入口处设置筛选与分流机制。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。