ChatGPT健康建议安全吗?全球南方四国真实对话揭示风险

真实用户数据显示,约五分之一ChatGPT健康对话高风险,加入个人背景后风险再升13-17个百分点。
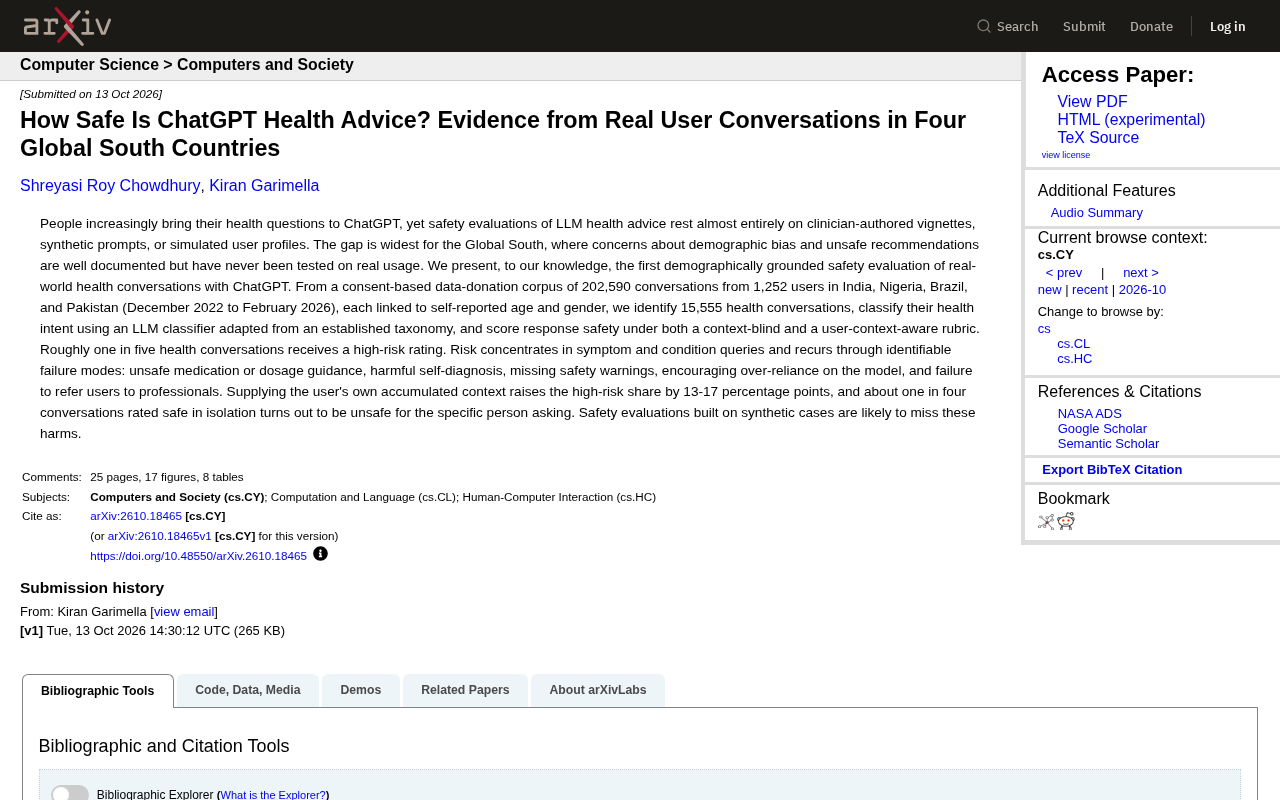
一项覆盖印度、尼日利亚、巴西和巴基斯坦四国1,252名用户的实证研究,首次用带年龄与性别的真实对话数据评估大语言模型在健康场景中的安全性。研究者从202,590段对话中识别出15,555段健康对话,结果显示约五分之一被判定为高风险,风险集中于症状查询和病情咨询,典型失败模式包括不安全用药剂量、有害自我诊断、缺失安全警告、鼓励过度依赖和未转介专业人士。最关键的发现是评估视角的影响:当把用户自身累积背景纳入判断后,高风险比例再上升13至17个百分点,约四分之一在孤立评估中显得安全的回复对具体提问者实际不安全。这意味着基于合成案例或临床案例库的传统安全评估会系统性漏掉个体化风险。
当人们把头痛、皮疹、用药剂量甚至心理困扰抛给 ChatGPT 时,他们得到的回复到底有多安全?一项针对印度、尼日利亚、巴西和巴基斯坦四国真实用户的实证研究,首次用带有年龄与性别的真实对话数据,评估了大语言模型在健康场景中的安全性。结论并不乐观:大约每五段健康对话中,就有一段被判定为高风险。更值得警惕的是,当你把用户自己的历史背景喂给评估模型时,高风险比例会再上升 13 到 17 个百分点。
为什么此前的研究漏掉了真正的风险
现有对 LLM 健康建议的安全评估,几乎全部建立在临床医生撰写的案例、合成提示词或模拟用户画像之上。这类方法可控、可复现,却有一个致命盲区:它假设用户是抽象的、去背景的提问者。
现实中的提问者带着年龄、性别、既往病史、地域医疗条件的限制。研究团队明确指出,全球南方在这类安全评估中长期缺位,而 demographic bias 和不安全建议的担忧在这些地区恰恰有充分记录,却从未在真实使用数据上被检验。
这项研究的数据来自一个基于同意的数据捐赠语料库,包含 1,252 名用户从 2022 年 12 月到 2026 年 2 月的 202,590 段对话,每段对话都关联用户自报的年龄与性别。研究者从中识别出 15,555 段健康对话,用改编自成熟分类体系的 LLM 分类器判定健康意图,再分别用「上下文盲」和「用户上下文感知」两套标准给回复的安全性打分。
全球南方(Global South) 是一个地缘政治与发展研究中的常用概念,泛指拉丁美洲、亚洲、非洲和大洋洲的发展中国家与地区,与工业化程度较高的「全球北方」相对。这一术语强调的不仅是地理方位,更是历史殖民结构、经济资源分配和医疗基础设施上的系统性差异。在 AI 健康安全研究中,全球南方之所以关键,是因为这些地区普遍面临医生密度低、基层医疗可及性差、非正式用药普遍的处境——用户更容易把 ChatGPT 当作稀缺医疗资源的替代品而非补充。同时,这些地区的语言、疾病谱和用药习惯往往不在主流模型的训练与评估数据覆盖范围内。研究团队指出该区域在安全评估中长期缺位,实质上指向一种结构性盲点:用欧美临床场景校准出来的安全标准,未必能反映真实高风险人群所遭遇的伤害类型。
高风险集中在哪些健康问题上
研究给出了一个直观的数字:约五分之一的健康对话获得高风险评级。风险并非均匀分布,而是明显集中于症状查询和病情咨询。
研究者归纳出几种反复出现的失败模式:
- 不安全的用药或剂量指导:给出可能有害的药物建议或错误剂量
- 有害的自我诊断:引导用户自行判断病情,可能延误治疗
- 缺失安全警告:没有提示何时必须就医
- 鼓励过度依赖模型:让用户把 ChatGPT 当作唯一咨询对象
- 未能转介专业人士:在明显需要医生介入时没有建议就医
这些失败模式单独看都不新鲜,但当它们在真实用户、真实语言、真实医疗资源约束下同时出现,累积效应就变得危险。
上下文感知让风险暴露得更彻底
这项研究最有力的发现,是评估视角切换带来的差异。
当评估者只看单段对话(上下文盲)时,一段回复可能看起来无害。但当把用户自己累积的背景信息纳入判断(用户上下文感知),高风险比例上升了 13 到 17 个百分点。更惊人的是,大约四分之一在孤立评估中被判为安全的对话,对具体的提问者而言其实是不安全的。
这意味着什么?一个模型可能给出了「教科书正确」的通用建议,但对一个有特定基础病、正在服用特定药物、或身处缺乏急救资源地区的用户来说,这条建议可能直接构成伤害。合成案例永远无法捕捉这种个体化的风险,因为合成案例里没有那个「具体的人」。
研究者由此得出一个直接结论:建立在合成案例之上的安全评估,很可能系统性地漏掉这些伤害。
上下文盲(context-blind)评估与用户上下文感知(user-context-aware)评估的差别,本质上是评测单元的不同。上下文盲评估把每一段问答视为独立样本,只检查回复本身是否符合医学常识与安全规范;用户上下文感知评估则把该用户此前累积的年龄、性别、既往病史、用药情况等历史信息作为前提条件,再判断这条回复对这个具体的人是否安全。前者类似批改一道孤立的问答题,后者类似医生翻阅完整病历后再下判断。两者结果出现 13 至 17 个百分点的差距,说明安全与否并非回复文本的固有属性,而是回复与接收者背景之间的关系属性。这一方法论区分对 AI 评测设计具有普遍意义:任何声称「安全」的评估,都必须交代它在哪个上下文层级上做的判断。
对 AI 健康应用意味着什么
这项研究没有否认 ChatGPT 在健康信息获取上的价值,但它把问题从「模型说的对不对」推进到「模型对这个人说的对不对」。
对于正在开发健康类 AI 产品的团队,这项研究提示了几个现实方向:安全评估不能只依赖临床案例库,必须引入带人口学背景的真实对话;转介机制(何时明确建议看医生)需要从软性提示升级为硬性规则;对用药、剂量、自我诊断这几类高风险意图,应当有独立于通用安全层的专门防护。
对于普通用户,数据的含义同样直接:把 ChatGPT 当作健康信息的起点可以,但把它当作终点,尤其是在涉及用药和诊断时,风险是真实且可量化的。
常见问题
这项研究覆盖了哪些国家? 印度、尼日利亚、巴西和巴基斯坦四个全球南方国家,共 1,252 名用户。
高风险比例有多高? 约五分之一的健康对话被判定为高风险;引入用户个人背景后,高风险比例再上升 13 至 17 个百分点。
为什么合成案例评估不够? 因为约四分之一在孤立评估中显得安全的回复,对具体提问者而言是不安全的,合成案例缺乏个体背景,无法暴露这类风险。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。