ChatGPT与AI Agent工作原理:无数学拆解核心机制

大语言模型逐token猜词、无记忆,Agent靠工具和循环行动,理解机制才能清醒使用。
文章基于科普视频《ChatGPT vs AI Agents: How They Actually Work (No Math)》,用无数学公式的方式拆解大语言模型与AI Agent的工作机制。核心观点是:模型将文本切分为token并转为数字,通过数十亿权重的神经网络逐词预测下一个token,训练靠猜错微调,注意力机制让词义随语境变化。模型本身没有记忆,聊天时应用每次重发完整对话历史,受上下文窗口限制,长对话会“犯糊涂”。Agent则在模型基础上增加工具和循环,能通过工具影响真实世界,能力扩展的同时风险放大。文章据此提出职场使用AI的三条原则:核实关键事实、新任务开新对话、对Agent严格授权并保留人工审批。
很多人每天用ChatGPT,却说不清它到底怎么工作。一个常见的误解是:AI会"记住"你。事实并非如此。本文基于YouTube热门科普视频《ChatGPT vs AI Agents: How They Actually Work (No Math)》的核心内容,用最直白的语言拆解大语言模型与AI Agent的本质差异,不涉及任何数学公式。
大语言模型:一场关于"下一个词"的猜谜游戏
从文字到数字:Token化
模型从来没见过字母。你输入的文本首先被切成小块,称为token,每个token再转换成一个数字。在一个真实的tokenizer中,"the cat sat on the"被切成五个片段,而"unbelievably"这样的长词会被拆成三个。这一步看似机械,却决定了模型理解语言的基本粒度。
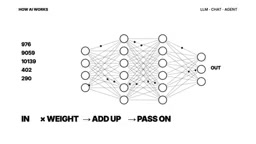
Token是语言模型处理文本的最小单位,但它并不等同于“单词”或“字符”。常见的子词分词算法(如BPE,字节对编码)会从字符开始,反复合并高频相邻片段,最终形成一套兼顾常用词完整性和生僻词可拆分性的词表。因此,常见词如“the”往往独占一个token,而“unbelievably”可能被拆成“un”“believ”“ably”三个token。不同模型使用不同的tokenizer和词表大小(GPT-3约为5万),这直接影响了模型能“看到”的文本粒度和上下文窗口的实际容量——同样的字数,token数可能差异很大。
神经网络:海量微型计算器的叠加
这些数字流入一个神经网络。可以把它想象成层层叠叠的微型计算器:每个计算器接收数字,乘以自己的设置(称为权重),求和后传给下一层。单个计算器很简单,但大型模型拥有数十亿个权重——2020年的GPT-3就有1750亿。正是这种规模的叠加,让简单的乘法运算涌现出语言能力。
训练:猜错就微调
训练过程朴素得惊人:模型阅读海量文本,但下一个词被隐藏,它需要猜出那个词。猜错时,每个权重都会被微调一点点,让正确答案下次更可能出现。重复亿万次之后,权重中沉淀下了语言模式和事实知识。第二轮训练引入人类反馈,教它像助手一样遵循指令。
注意力机制:让"bank"知道自己是河岸还是银行
内部还有一个关键技巧叫注意力(attention)。每个词都会"看"其他词,来确定自己在此处的含义。在"river bank"中,bank看向river,意思是河岸;在"bank account"中,它看向account,意思是金钱。这就是GPT中T的来源——Transformer,谷歌研究人员于2017年发布的架构设计。
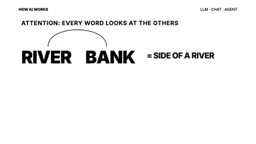
Transformer架构的核心创新是自注意力机制(self-attention),它允许序列中每个位置直接与所有其他位置交互,从而并行计算词与词之间的关联权重。这与循环神经网络(RNN)必须按顺序逐步处理形成鲜明对比,使Transformer能够高效利用GPU并行训练超大规模模型。2017年谷歌的论文《Attention Is All You Need》首次提出该架构,最初用于机器翻译,但因其可扩展性成为此后几乎所有大语言模型的基础。GPT中的“T”即Transformer,而“预训练”(pre-trained)则指模型先在海量无标注文本上学习语言规律,再针对具体任务微调。
输出:逐词生成的概率游戏
模型输出的是一个候选token列表,每个都附有概率。对于"the cat sat on the","mat"得分很高。模型选一个,加到文本末尾,再跑一轮预测下一个。这就是回答逐词出现的原因,也是模型能言之凿凿却出错的根源——它只是挑选了高概率的词,整个过程中没有任何一步去核实事实。
聊天:没有记忆,全靠"重读全文"
模型本身在消息之间没有任何记忆。每次你发送消息,应用都会把整段对话重新发一遍:公司设定的隐藏指令、你说过的每句话、它说过的每句话,以及你的新消息。模型读完这一整包内容,预测出回复。这个包裹叫上下文窗口(context window),有大小上限。
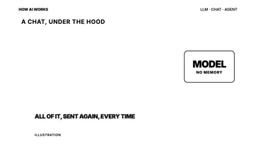
这也解释了一个日常困惑:为什么长对话到后面模型开始"犯糊涂"?因为上下文窗口装不下了,早期信息被挤了出去。视频给出的实用建议是——新任务开新对话,把必要信息粘贴进去,而不是在一条超长对话里继续追问。
上下文窗口(context window)指模型单次前向计算所能处理的最大token数量,包括系统指令、历史对话和当前输入。不同模型的窗口大小差异显著:早期GPT-3为2048个token,GPT-3.5 Turbo为4096,而后续模型已扩展到数万乃至数十万token。窗口越大,模型能“记住”的对话越长,但计算成本和内存占用也呈平方级增长(因注意力机制需计算每对token之间的关系)。当对话超出窗口时,应用通常采用截断早期消息或摘要压缩的策略,这解释了长对话中模型遗漏早期信息或前后矛盾的现象。
Agent:工具加循环,从"说"到"做"
Agent比聊天模型多了两样东西:工具和循环。假设你让它订周五六人桌的餐厅,模型的回复不是直接执行,而是一个请求:查一下日历。应用运行这个工具,把结果放回对话;模型读取结果,决定下一步;循环持续,直到任务完成。Anthropic对Agent的定义正是如此简洁:模型在循环中使用工具。
这个定义的价值在于,它揭示了Agent能力的边界与风险。模型本身仍然只会猜下一个token,但它现在能通过工具影响真实世界。工具越多,循环越长,出错的代价也越大。
工具调用(tool use / function calling)是Agent实现行动能力的技术基础。开发者以结构化描述(名称、功能、参数 schema)向模型注册可用工具,模型在生成回复时若判断需要外部操作,便输出一个符合该schema的调用请求,而非自然语言。应用层执行该工具(如查询日历、发送邮件、调用支付API),并将结果作为新消息追加到对话中,模型据此继续推理。这种“模型决策、应用执行”的分工意味着模型本身不直接接触真实系统,权限控制完全落在应用层——这也是为什么对不可逆操作保留人工审批是必要的安全设计。
职场使用AI的三个习惯
视频结尾提炼了三条实操原则,值得每个用AI工作的人记住:
第一,核实每一个重要事实。 模型挑选的是高概率词,而非真相。涉及数据、引用、法规的内容,必须人工复核。
第二,新任务开新对话。 模型每次都重读全文,长对话会耗尽上下文空间。与其在旧对话里打补丁,不如干净地重新开始。
第三,对Agent严格授权。 Agent通过工具行动,只给它任务必需的工具;对发送、支付、删除这类不可逆操作,保持人工审批。
简单步骤的规模化,才是"魔法"的来源
一句话总结这套机制:语言模型猜下一个token,聊天每次发送整段对话,Agent则给它工具和循环。每一步都简单到可以用一句话描述,但规模(数十亿权重)和长度(逐词生成、循环执行)叠加起来,就产生了令人惊叹的智能感。理解这一点,你就能更清醒地使用它——既不过度神化,也不低估风险。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。