ChatGPT正在为你建立心理画像:隐私边界再引争议
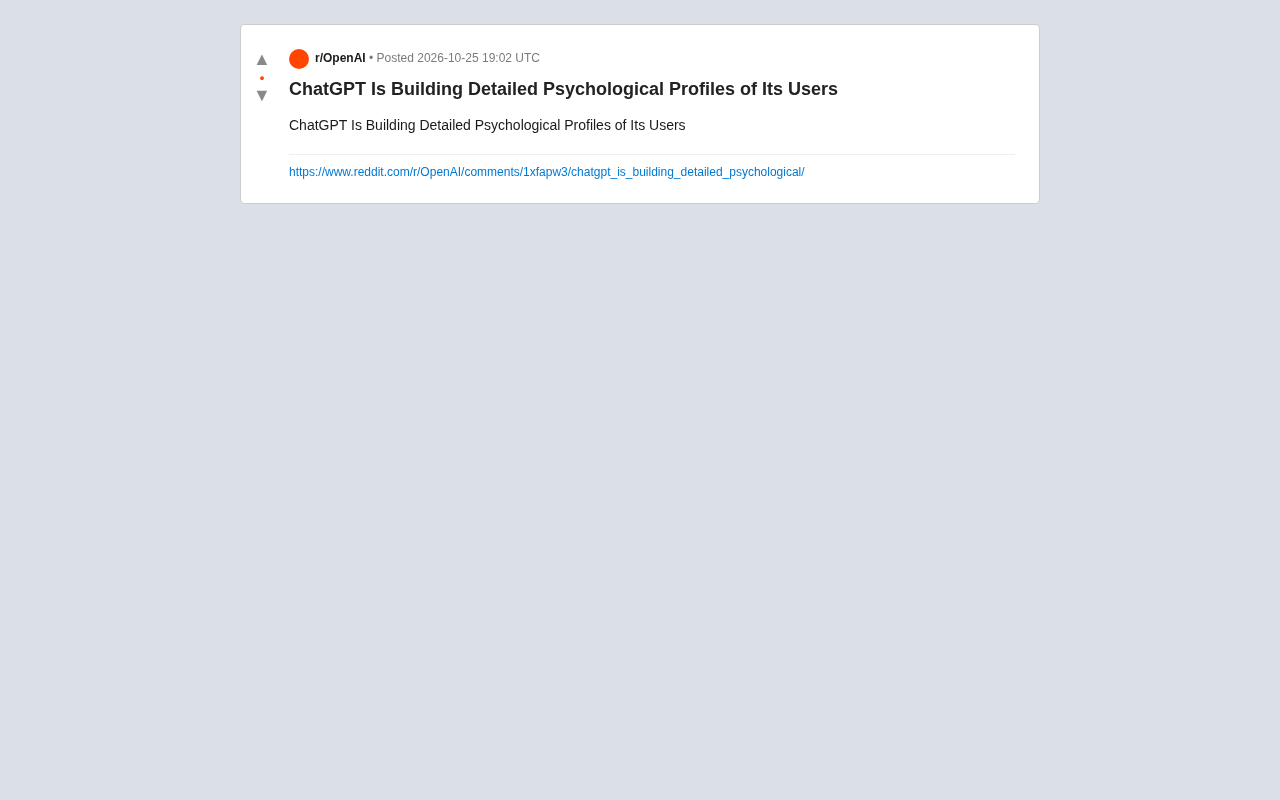
Reddit热帖警示ChatGPT长期对话积累可能构建用户心理画像,引发隐私边界讨论。
文章由Reddit一则热帖切入,探讨对话式AI是否正在为用户建立详细心理画像。作者拆解了三层数据积累机制:跨会话的对话历史与记忆功能、输入文本的情绪与语气信号、以及点赞重写等行为反馈。单看每项都不越界,叠加后却可能形成关于性格倾向与压力来源的模糊轮廓。争议焦点在于心理数据与购物偏好等普通画像的敏感度差异,以及用户对数据提取维度和流向缺乏知情。文章认为,用户并非拒绝被理解,而是拒绝在不知情下被理解,并给出清理记忆、避免敏感内容过度展开等务实建议。
一个帖子引发的隐私焦虑
Reddit上出现了一则引发广泛讨论的帖子,标题直白而刺眼:"ChatGPT Is Building Detailed Psychological Profiles of Its Users"(ChatGPT正在为用户建立详细的心理画像)。帖子本身没有展开长篇论证,但这个标题所指向的问题,足以让每一个高频使用AI对话产品的人停下来想一想——当我们在对话框里倾诉情绪、描述困境、甚至随口抱怨生活时,这些内容究竟被如何对待?
这并非空穴来风的技术想象。大语言模型产品为了优化交互体验,确实会通过对话历史、记忆功能以及用户反馈来构建对用户的"理解"。问题在于,这种理解的心理维度有多深,边界又在哪里。
心理画像是怎么被"画"出来的
要理解这个担忧的合理性,需要看清背后的技术机制。现代对话式AI产品普遍依赖几个层面的信息积累:
对话历史与记忆功能。 多数主流产品允许模型跨会话记住用户的偏好、经历和表达习惯。当用户反复谈及焦虑、职业困惑或人际关系时,这些主题会沉淀为可被调用的上下文。
情绪与语气信号。 模型在生成回复时会分析输入文本的情感倾向。虽然这主要用于调整回应风格,但情感数据的持续积累本身就构成了某种心理侧写的基础。
反馈与行为数据。 用户对回复的点赞、重写、停留时长等行为,间接反映了心理偏好,这些信号同样会被纳入优化循环。
单看每一项都不算越界,但叠加起来,一个关于用户性格倾向、情绪模式和压力来源的模糊轮廓就可能浮现。Reddit讨论中不少用户表达的正是这种"拼图式"担忧:不是某一次对话泄露了什么,而是长期积累让画像越来越清晰。
记忆功能的技术边界。 目前主流产品的"记忆"并非模型参数层面的永久学习,而是以条目形式存储的结构化信息(如"用户偏好简洁回答""用户提到过换工作"),在后续会话中被检索并拼入提示词。这意味着记忆内容的准确性取决于提取环节的判断,错误或过时的条目可能持续影响对话,也让用户对"被记住了什么"缺乏直观感知。多数学术与产品文档都强调记忆是可控、可删除的,但实际呈现给用户的往往只是零散条目摘要,难以还原模型在生成回复时实际调用了哪些上下文。
情感分析与心理测量的区别。 对话系统常做的是情感分类(正面/负面/中性)与语气调整,属于浅层文本特征处理;而心理画像在心理学语境中通常指基于标准化量表的人格、情绪或风险维度评估。两者在方法严谨性和适用伦理上差异巨大。争议之所以产生,部分源于公众将"模型能识别情绪词"与"系统在对你做心理评估"混为一谈,企业也较少主动澄清这条界线。
争议的核心:便利与监控的模糊地带
围绕这个话题的讨论,分歧主要集中在一点上——这到底算个性化服务,还是隐性监控?
支持产品优化的一方认为,记住用户背景、理解情绪状态,恰恰是AI助手变得有用的前提。一个完全不记得你上次说过什么的助手,体验是割裂的。心理层面的理解与推荐系统的用户画像在技术上同源,不必过度恐慌。
持谨慎态度的一方则指出,心理数据与购物偏好有本质区别。情绪状态、心理困扰属于高度敏感信息,一旦被用于广告定向、保险评估或其他商业用途,后果远超"推荐不准"。更棘手的是,普通用户很难知道自己的对话被提取了哪些维度、保存多久、流向何处。
Reddit帖子下的讨论虽然没有给出统一结论,但共识倾向明显:透明度不足是问题的根源。用户不是拒绝被理解,而是拒绝在不知情的情况下被理解。
敏感个人数据的监管语境。 在欧盟《通用数据保护条例》(GDPR)框架下,涉及心理健康、性取向、宗教信仰等的信息被归为"特殊类别个人数据",处理需满足更严格条件;中国的《个人信息保护法》同样将医疗健康、行踪轨迹等列为敏感个人信息,要求单独同意并说明必要性与影响。问题在于,用户在自由对话中随口流露的情绪困扰,是否构成"敏感个人信息"的处理,实践中界定模糊。多数产品条款以"改进服务"概括授权,难以让用户判断心理维度数据的收集范围,这正是透明度争议的制度根源。
用户能做什么
在监管和产品政策明朗之前,用户并非完全被动。几个务实的做法值得考虑:
- 定期检查并清理对话历史与记忆条目,多数产品在设置中提供了管理入口;
- 对涉及心理健康、家庭关系、财务困境的敏感内容,避免在对话中过度展开;
- 关注产品的数据使用条款更新,尤其是关于"改进服务"的授权范围;
- 在企业或团队场景中,优先选择明确承诺数据隔离的方案。
这些措施无法根本解决问题,但能缩小暴露面。
写在最后
Reddit这则帖子之所以能引发共鸣,是因为它戳中了一个尚未被充分讨论的灰色地带:AI助手越懂你,你越需要知道它懂了多少、记在哪里。心理画像不是科幻情节,而是对话产品数据积累的自然延伸。真正需要追问的不是"AI能不能理解情绪",而是"这种理解由谁掌控、以什么规则使用"。在答案清晰之前,保持警觉比保持信任更理性。