彻底讲透Skill:从Tools到MCP再到Agent Skills的技术演进

从Function Call到MCP再到Skill,一文拆解AI Agent能力编排的三层递进逻辑。
本文沿着 Function Call → MCP → Skill 的技术演进脉络,逐层拆解AI Agent调用外部能力的底层原理。Tools(Function Call)将自然语言转化为结构化JSON,让大模型间接调用应用程序方法;MCP在此基础上建立统一协议,使第三方服务可以自声明工具并被任意AI应用复用;Skill则更进一步,用Markdown文件封装元数据与多步指令,通过「渐进式披露」按需加载,解决复杂多步任务的编排问题。Skill本质上仍是Function Call,内置一个读取Markdown的callSkill工具,因此必须依赖支持Function Call的大模型。文章最后展示了如何借助Spring AI Alibaba将这套机制移植到任意大模型,并以搜索学术论文为实战案例,演示了Skill自动推理、自动纠错的完整运行过程。
Skill到底是什么?一句话看懂本质
做开发、搞大模型、玩技术的人天天把Skill挂在嘴边,但真正能说清它是干嘛的人并不多。抛开那些晦涩的定义,Skill本质上就是一套面向复杂任务的「超级能力工具箱」——它让AI Agent具备在特定场景下按需调用能力、编排流程的核心底气。
要真正理解Skill,不能孤立地看它,而要沿着 Function Call(Tools)→ MCP → Skill 这条技术演进脉络来梳理。这三者并非互相取代的关系,而是层层递进、彼此依赖。本文基于B站UP主徐树在Spring AI Alibaba Agent Framework下的讲解,还原Skill的原理与落地实践。
第一层:Tools解决「怎么调用」的问题
大模型天然缺乏实时信息获取能力。当你让它查询北京的天气时,它本身答不上来,于是会在可用工具里寻找能处理这次对话的Tool。经过推理,它发现有一个专门查天气的工具,便返回一段调用Tool的JSON信息——里面包含方法名称和所需参数(比如位置「北京」)。
应用程序识别到这段JSON后,通过反射方式找到对应方法执行调用。所以Tool(Function Call)的本质,是把非结构化的自然语言转化为可处理的结构化JSON信息,从而让大模型间接调用应用程序中的方法。
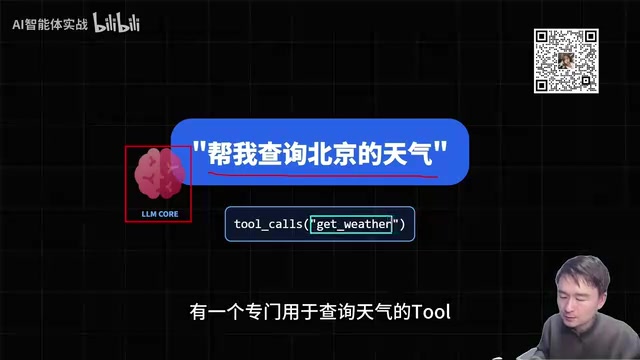
一句话总结:Tools解决的是「怎么调用」的问题。
第二层:MCP解决「调哪里」的问题
当需求从查天气扩展到查询GitHub开源项目、查博客、查地图位置等第三方服务时,问题就来了。如果为每个第三方服务都手写一个Tool方法,实现成本极高:第三方服务多,就要写大量Tool方法;AI应用多,还要在每个应用里重复实现,因为这些Tool方法无法共享。
那能不能让第三方服务自己声明Tools、对外提供呢?这正是MCP(Model Context Protocol)出现的意义。MCP解决的是大模型如何用统一方式对接第三方服务共享Tools的问题。它提供STDIO和HTTP两种调用方式,其中HTTP又细分为SSE和Streamable,怎么调、返回什么数据,全由MCP协议规定。
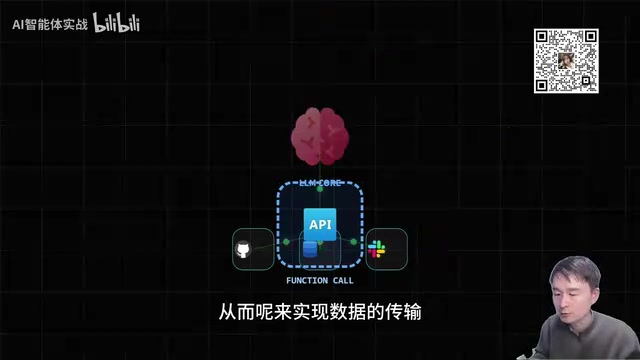
值得强调的是,MCP依然离不开Function Call。对大模型而言,它不区分内部Tools还是外部第三方Tools——在它眼里这些都是工具。整个流程是:大模型返回调用Tools的JSON,应用程序通过Function Call提供给大模型,再去调用外部第三方共享Tools完成数据传输。MCP解决的是「调哪里」的问题。
MCP(Model Context Protocol)是Anthropic于2024年11月正式开源的标准协议,目标是成为AI应用与外部工具/数据源之间的「USB-C接口」——就像USB-C统一了设备充电和数据传输标准一样,MCP试图统一大模型与外部服务的对接方式。协议架构分为三个角色:MCP Host(运行AI模型的应用程序,如Claude Desktop)、MCP Client(负责与服务端通信的客户端模块)、MCP Server(第三方服务方提供的能力声明端)。第三方服务只需实现一次MCP Server,即可被任意支持MCP协议的AI应用直接调用,彻底打破了此前「每个AI应用各自手写对接代码」的重复建设困境。目前GitHub、Google Drive、Slack等主流平台已陆续发布官方MCP Server,开发者社区也积累了大量开源实现。
第三层:Skill解决「怎么编排一系列任务」的问题
现实中的任务往往不是调用单个Tool就能完成的。比如「打开浏览器、请求百度、查询函数、获取相关信息」,或者「获取桌面上所有文件名和类型再交给大模型推理」——这类任务需要经过一系列工作流再结合Tools。
在传统的Workflow Agent模式下,开发者必须用大量提示词告诉大模型:针对不同任务怎么拆分、每一步怎么处理。比如网络搜索要拆成「打开浏览器→输入百度→搜索关键词→获取网页内容→推理返回」,每一步都要写提示词。这导致提示词体量极其庞大。
Anthropic(Claude背后的公司)意识到这个问题,推出了Skill。一个Skill由一个Markdown文件构成,包含两部分:
- 元数据(Metadata):描述这个Skill的作用,比如「网络搜索」
- 指令(Instructions):详细编排每一步怎么执行,比如第一步启动浏览器Tool、第二步搜索关键词、第三步甚至可以执行Python或JS脚本解析网页内容
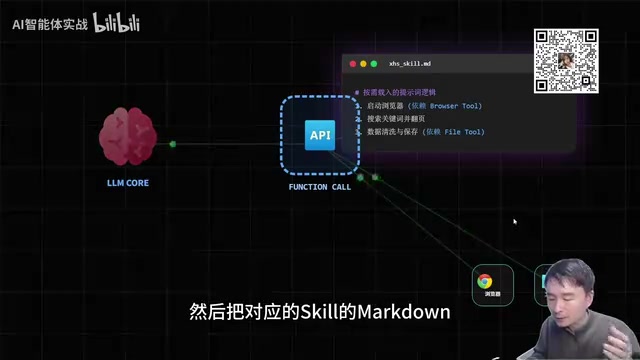
Skill如何做到「按需加载」
Skill最关键的设计是渐进式披露(按需加载),而不是像Workflow Agent那样把所有处理能力的提示词一次性全丢给大模型。
具体流程是:先把每个Skill的元数据(即作用描述)发给大模型。当你说「我要去百度搜索函数」时,大模型推理判断哪个Skill能处理,然后返回一段JSON,表示需要调用 callSkill 并带上Skill名字。
callSkill 本质上依然沿用Function Call——应用程序中有一个名为 callSkill 的Tool方法,它根据Skill的name决定读取哪个Markdown文件(网络搜索读网络搜索的md,文件操作读文件操作的md),再把对应Skill的Markdown发给大模型,让它推理执行下一步。
正因如此,Skill也被称为 Subagent——它只是一个大智能体中的一环,且天然便于传输和共享。
一个重要结论:Skill本质仍是Function Call。 它只是内置了一个读取Skill文本的Function Call,所以必须有支持Function Call的大模型才能支持Skill。
「渐进式披露」(Progressive Disclosure)这一概念最初来自UX设计领域,指的是只在用户需要时才展示复杂信息,以降低认知负担。Skill将这一思想移植到提示词工程中:如果一个智能体支持20种Skill,将全部指令一次性塞入上下文,不仅会消耗大量Token(直接增加推理成本),还会因上下文过长导致大模型注意力分散、指令遵循质量下降。按需加载的做法是只将各Skill的名称和简短描述(元数据)常驻上下文,当模型判断需要某个Skill时再动态拉取完整指令。这与操作系统的「懒加载」(Lazy Loading)机制本质相通——程序启动时不加载全部模块,只在真正调用时才映射到内存,从而大幅降低资源占用并提升系统响应速度。
用Spring AI Alibaba对接任意大模型实现Skill
这套Skill机制最初由Claude模型提供,目前原生只有Claude支持。但既然已经掌握了原理,就可以通过Spring AI Alibaba结合Tools,对接任意大模型来实现Skill。
在Spring AI Alibaba最新版本中,Skill的实现已被内置封装好。开发者只需要:
- 定义一个Skill Agent,告诉它Skill文件所在的根目录路径(比如目录里放了网络搜索等三个Skill,每个Skill是一个技能,含元数据的名字和描述)
- 框架内部已定义读取文件的Tool,会自动读取这些Markdown
- 提供一个执行Shell命令的Hook(因为Skill除了读Markdown,还能执行Python等脚本,需要通过CMD命令执行文件)
- 提供Python的Tool工具(底层依靠GraalVM的第三方库支持)
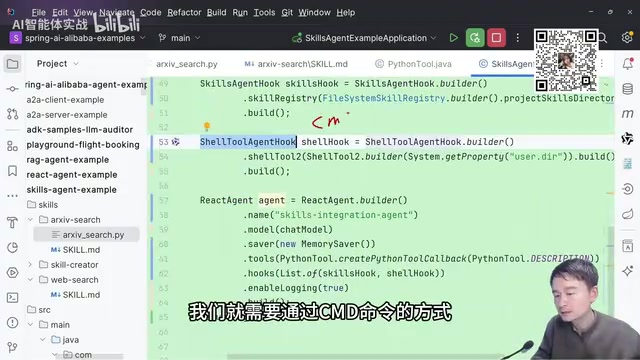
实战案例:搜索蛋白质折叠预测论文
演示中,通过Controller接口接收请求「搜索关于蛋白质折叠预测的最新论文」,对应一个用于搜索物理、数学、计算机科学论文的Skill,它会使用Python去arXiv等网站获取论文。
观察控制台可以看到完整的自动推理过程:
- 大模型先读取Skill对应的Markdown文件
- 发现需要执行Python文件,先用Python Tool检测是否具备Python环境
- 确认环境后运行Python脚本去目标网站搜索
- 第一次没搜到结果,自动推理可能是命令执行问题,查看Python文件语法
- 确认脚本逻辑正确后重新运行,搜索到五篇论文
- 发现结果与蛋白质折叠不太相关,又通过分类方式更精准地搜索
整个过程完全依照Skill描述文件自动编排、自动检查、自动纠错。开发者要做的仅仅是提供Skill的Markdown文件和对应的Python脚本。
Spring AI Alibaba是阿里巴巴基于Spring AI框架推出的企业级AI应用开发框架,旨在降低Java生态下接入大模型的门槛。Spring AI本身是Spring官方维护的AI抽象层,对OpenAI、Anthropic、Ollama等多家模型提供商提供统一的API封装,开发者切换底层模型时无需大幅改动业务代码。Spring AI Alibaba在此基础上进一步集成了通义千问广告等阿里云模型,并扩展了Agent、RAG(检索增强生成)、工作流等高阶能力。值得注意的是,由于Skill的执行依赖Function Call能力,选用底层大模型时必须确认其支持Tool Use / Function Calling特性,GPT-4o、Qwen-Plus、Claude 3系列等主流模型均已支持,但部分轻量级开源模型尚不具备此能力。
现成Skill资源与小结
如果不想从零编写,社区已有大量现成的Skill。可以通过 Skills.sh 搜索,目前已有四万多个Skill可按需取用。
回顾整条技术脉络:
- Tools / Function Call 解决「怎么调用」——自然语言转结构化JSON
- MCP 解决「调哪里」——统一对接第三方共享Tools
- Skill 解决「怎么编排一系列任务」——用Markdown封装元数据+指令,按需加载,本质仍是Function Call
理解这三层递进关系,才能真正说清Skill是什么、什么场景该选哪种技术。对于想在Spring AI Alibaba下落地Agent的开发者来说,掌握Skill的渐进式披露与Subagent设计思路,是构建可进化、可动态扩展智能体的关键一步。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。