抽取式摘要新框架:CNN-BiLSTM如何解决医疗文本的事实幻觉难题
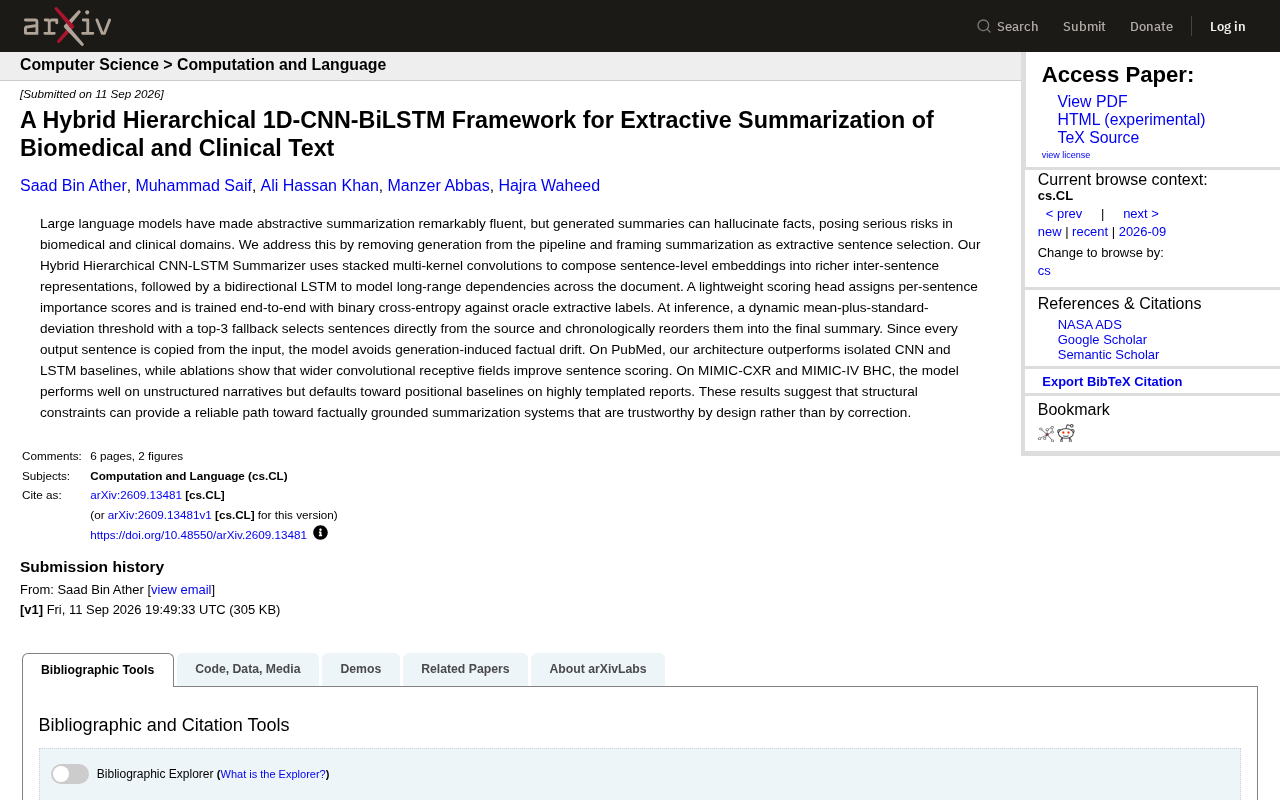
用抽取式CNN-LSTM架构替代生成式摘要,从设计层面消除生物医学文本的事实幻觉风险
这篇arXiv论文针对生成式大语言模型在临床与生物医学摘要中易产生"幻觉"的致命缺陷,提出将摘要任务重新定义为抽取式句子选择:模型不再生成新文本,而是从原文中直接挑选句子,从架构层面杜绝事实漂移。技术上,论文构建了多核CNN与双向LSTM的分层混合架构,前者捕捉局部句间语义关联,后者建模文档级长程依赖,并以动态阈值(均值加标准差)加top-3兜底机制筛选句子,最终按时间顺序重排输出。实验表明,模型在PubMed上优于单一CNN或LSTM基线,在非结构化临床叙述文本上表现良好,但在高度模板化报告上性能退化至位置基线水平。论文以"可信源于设计而非事后修正"为核心理念,为医疗可信AI提供了一条务实的替代路径。
大语言模型让摘要生成变得异常流畅,但在生物医学与临床领域,一个致命隐患始终存在——生成式摘要会“幻觉”出并不存在的事实。一份看似专业的病历摘要中若出现凭空捏造的诊断或数值,后果可能危及患者安全。一篇新发布的arXiv论文提出了一条截然不同的技术路线:干脆把“生成”这一步从流程中彻底移除,转而将摘要任务重新定义为抽取式句子选择。
为什么放弃生成式摘要
生成式(abstractive)摘要的核心问题在于,模型会用自己的语言重新组织内容,这个过程中难免引入原文没有的信息,即所谓的“事实漂移”(factual drift)。在新闻或通用文本里,偶尔的措辞偏差尚可接受;但在临床报告、放射影像描述、病程记录这类场景中,任何一处事实失真都可能带来严重风险。
这篇论文的思路是回归抽取式(extractive)摘要——不再让模型“写”摘要,而是让它从原文中“挑”出最重要的句子。由于每一个输出句子都直接复制自输入,模型从架构层面就杜绝了生成引发的事实错误。作者将这种设计理念概括为“可信源于设计,而非源于事后修正”(trustworthy by design rather than by correction),这也是该工作最值得关注的立意所在。
混合分层架构的技术设计
论文提出的模型名为 Hybrid Hierarchical CNN-LSTM Summarizer,其结构可以拆解为几个协同工作的模块。
多核卷积构建句间表示
模型首先使用堆叠的多核卷积(multi-kernel convolutions),将句子级别的嵌入向量组合成更丰富的句间表示。不同宽度的卷积核相当于不同的“视野窗口”,能够捕捉相邻句子之间的局部语义关联。消融实验显示,更宽的卷积感受野能够提升句子评分的准确性,这说明捕捉更大范围的上下文对判断句子重要性确有帮助。
双向LSTM建模长程依赖
在卷积层之上,模型接入一个双向LSTM(BiLSTM),用于建模整篇文档中跨度较长的依赖关系。CNN擅长局部特征提取,而BiLSTM能够把握全局结构,二者结合形成了“先局部聚合、再全局建模”的分层设计,这也是“Hierarchical”一词的由来。
轻量评分头与端到端训练
最后由一个轻量的**评分头(scoring head)**为每个句子输出重要性分数。整个网络采用二元交叉熵(binary cross-entropy)损失,对照oracle抽取标签进行端到端训练,判断每个句子是否应被纳入摘要。
动态阈值的句子筛选策略
模型在推理阶段的筛选机制颇具巧思。它没有采用固定的句子数量,而是使用**“均值加标准差”的动态阈值来决定哪些句子入选——分数显著高于文档平均水平的句子才会被保留。为防止某些文档筛不出足够内容,还设置了top-3兜底机制**,确保至少选出三个句子。
入选句子会按照在原文中出现的时间顺序(chronological order)重新排列,形成最终摘要。这一步对临床文本尤为重要,因为病程记录、检查结果往往具有时间逻辑,打乱顺序会损害可读性和临床价值。
实验结果与局限
在实验层面,该架构在多个数据集上得到了验证。
在 PubMed 数据集上,混合架构的表现优于单独的CNN基线和LSTM基线,证明了CNN与LSTM结合的有效性。
在 MIMIC-CXR(胸片报告)和 MIMIC-IV BHC(出院小结)上,结果则呈现出更细致的分化:模型在非结构化叙述文本上表现良好,但面对高度模板化的报告时,性能会退化到接近位置基线(positional baselines)的水平。换句话说,当报告本身格式高度固定、重要信息总是出现在特定位置时,复杂模型相比“直接取开头几句”这类简单策略并没有明显优势。这一发现如实揭示了方法的适用边界——结构化约束的价值主要体现在处理自由文本时。
对可信AI的启示
这项工作的意义超出了单一模型本身。在生成式AI席卷各行各业的当下,它提醒我们:并非所有场景都适合追求“流畅生成”。在容错率极低的医疗领域,用架构约束换取事实可靠性是一种值得认真对待的权衡。
抽取式摘要牺牲了一定的语言流畅度和信息压缩率,但换来了“每句话都可追溯到原文”的可验证性。对于需要监管审查、法律追责或临床决策支持的系统而言,这种“设计即可信”的思路,可能比在生成式模型后不断打补丁纠错更为务实。当然,如何在保证事实性的同时进一步提升摘要的连贯性,仍是这一路线未来需要突破的方向。
相关推荐
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。