传音的说话人归属多语种ASR系统:MLC-SLM 2026挑战赛亚军方案解析

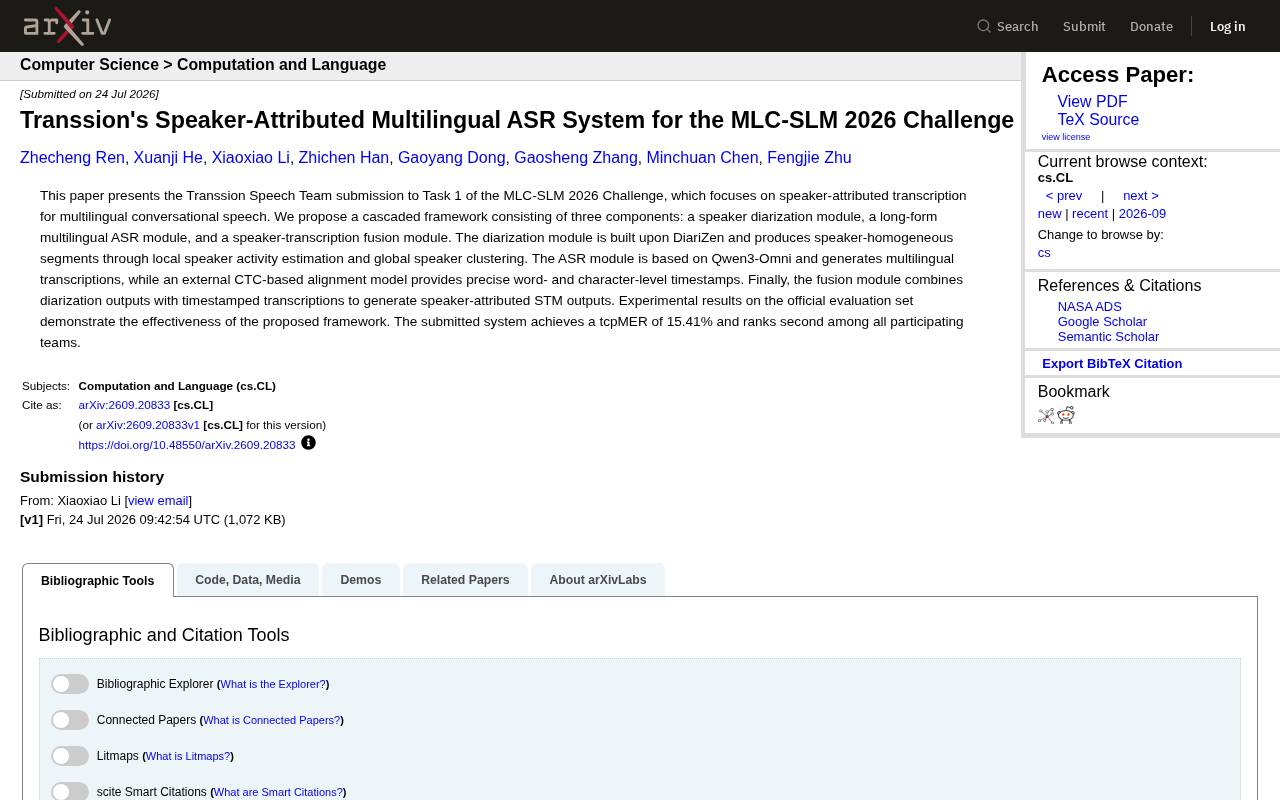
传音语音团队用DiariZen+Qwen3-Omni+CTC三段式级联框架,在MLC-SLM 2026多语种对话转写赛事中以15.41% tcpMER夺得第二名。
传音(Transsion)语音团队为MLC-SLM 2026挑战赛Task 1提交了一套三段式级联系统,用于多语种对话的说话人归属转写。系统分为三个模块:基于DiariZen的说话人日志模块,通过局部活动估计与全局聚类将音频切分为说话人同质片段;基于Qwen3-Omni多模态大模型的ASR模块负责多语种转写,并引入外部CTC对齐模型补足词级时间戳精度;最终由融合模块将两路结果按时间轴合并,生成"谁在何时说了什么"的结构化输出。该系统在官方评估集上以15.41%的tcpMER排名第二,验证了大模型与专用模型混合使用、模块化级联设计在复杂多语种场景中的实用价值。
多语种对话语音的转写一直是语音识别领域的硬骨头。既要识别出说了什么,又要分清是谁说的,还要跨越多种语言的障碍,任何一个环节出错都会让最终结果打折扣。传音(Transsion)语音团队在MLC-SLM 2026挑战赛Task 1中提交的系统,用一套级联框架给出了自己的答案,并最终以15.41%的tcpMER成绩排名所有参赛队伍第二。
挑战任务:说话人归属的多语种转写
MLC-SLM 2026挑战赛的Task 1聚焦于说话人归属转写(speaker-attributed transcription),针对的是多语种对话场景。这类任务的核心难点在于三重叠加:一是多人对话中需要区分不同说话人(说话人日志),二是对话跨越多种语言(多语种ASR),三是要把两者精确对齐,形成"谁在什么时候说了什么"的完整结构化输出。
评估指标采用tcpMER(time-constrained permutation Mixed Error Rate),这是一个在时间约束下综合考量说话人归属与转写准确率的指标。传音团队的系统在官方评估集上取得15.41%的成绩,在众多参赛队伍中位列第二,说明其框架设计在实际场景中具有较强的竞争力。
tcpMER(time-constrained permutation Mixed Error Rate)是在传统词错误率(WER)基础上专为多说话人场景设计的评估指标。其中"permutation"指在计算错误率时,系统输出的说话人标签与参考标签之间的最优匹配是通过排列组合搜索得出的,避免因标签命名不一致而产生惩罚;"time-constrained"则指评估时会对每个片段施加时间窗口约束,只有时间上对齐的片段才会被匹配计算,从而同时惩罚说话人归属错误和时间边界偏差;"Mixed"则反映该指标兼顾了字符错误率(CER)和词错误率(WER),适用于多语种混合场景。因此,tcpMER综合衡量了转写准确率、说话人归属准确率和时间定位精度三个维度,是多语种对话转写任务中公认较为严苛的评估标准。
三段式级联框架:分工明确的模块化设计
传音团队没有采用端到端的一体化模型,而是选择了级联框架(cascaded framework),将复杂任务拆解为三个各司其职的模块。这种模块化思路的好处在于每个组件都可以独立优化、更换和调试,工程可控性更高。
说话人日志模块:先分清有几个人在说话
第一个模块是说话人日志(speaker diarization),负责回答"什么时候是谁在说话"这一问题。该模块基于DiariZen构建,通过两个步骤生成说话人同质片段:局部说话人活动估计(local speaker activity estimation)先在短时窗内判断说话人活动状态,全局说话人聚类(global speaker clustering)再将整段音频中属于同一说话人的片段归并到一起。这样得到的片段内部只包含单一说话人的语音,为后续对齐打下基础。
DiariZen是一个基于深度学习的说话人日志系统,其核心思想来自于将说话人日志问题建模为序列到序列任务。与传统基于聚类的日志方法相比,DiariZen能够更好地处理说话人重叠(overlapping speech)的情形,即多人同时发言的片段。传统方法往往对重叠语音束手无策,只能将其归入某一个说话人,而基于神经网络的端到端日志方法可以为同一时间段输出多个说话人标签。局部说话人活动估计与全局聚类的两阶段设计,也是为了平衡短时感受野下的精细判断与长音频中跨片段身份一致性之间的矛盾——前者专注于逐帧或逐窗口的活动检测,后者确保同一说话人在整场对话中被赋予统一的标识。
多语种ASR模块:基于Qwen3-Omni的转写引擎
第二个模块是长音频多语种ASR,负责把语音转成文字。值得关注的是,该模块建立在Qwen3-Omni之上——这是阿里通义千问广告系列的多模态大模型,具备处理多语种音频的能力。借助大模型的强大表征能力,ASR模块能够生成跨语种的转写结果。
不过大模型本身在时间戳精度上往往不够理想,为此团队引入了一个外部的CTC对齐模型,专门提供词级和字符级的精确时间戳。这一设计体现了工程上的务实取舍:让大模型负责它擅长的语义转写,让专门的CTC模型负责它擅长的时间对齐,各取所长。
CTC(Connectionist Temporal Classification)是语音识别中一种经典的序列对齐算法,由Alex Graves等人于2006年提出。其核心贡献在于无需手动对齐输入帧与输出标签,模型可以直接从音频帧序列学习到字符或词的对应关系,并通过特殊的"空白帧"标记来处理重复和静音段。CTC模型天然输出帧级别的对齐概率,因此可以精确推算每个词或字符在音频中出现的起止时间戳。相比自回归生成式大模型,CTC的推理延迟低、时间戳可靠性高,正因为此才被用于弥补Qwen3-Omni在精细时间对齐上的不足。两者的分工本质上是"理解-定位"的解耦:大模型负责跨语种的语义理解与转写生成,CTC模型负责将生成结果锚定到精确的时间坐标上。
融合模块:把"谁"和"说什么"拼在一起
第三个模块是说话人-转写融合模块(speaker-transcription fusion module)。它把说话人日志的输出与带时间戳的转写结果结合起来,生成最终的说话人归属STM输出(Segment Time Mark格式)。简单来说,就是利用两个模块共享的时间轴,把每一段文字精准地"贴"到对应的说话人身上。
技术路线的启示
传音这套方案给业界带来几点值得思考的地方。大模型与专用模型的混合使用是当前一个明显趋势——用Qwen3-Omni这样的通用多模态大模型承担核心转写,用轻量的CTC模型补足时间戳精度短板,既享受了大模型的泛化能力,又规避了其在细粒度对齐上的不足。
级联架构相比端到端方案,在多语种、多说话人的复杂场景下依然展现出实用价值。虽然近年来端到端的说话人归属ASR研究热度很高,但传音的实践表明,把任务分解为可控模块并逐一优化,在竞赛级评测中仍能取得靠前的名次。这对资源有限、需要快速迭代的工程团队来说是一条可借鉴的路径。
15.41%的tcpMER与第二名的成绩,也反映出多语种对话转写这一任务的整体难度——即便是精心设计的系统,错误率仍在两位数区间,说明这个方向还有相当大的提升空间。
总结
传音语音团队为MLC-SLM 2026挑战赛Task 1提交的系统,通过说话人日志、多语种ASR、说话人-转写融合三个模块的级联组合,实现了对多语种对话语音的说话人归属转写。其中基于DiariZen的日志模块、基于Qwen3-Omni的ASR模块,加上外部CTC对齐模型的组合设计颇具代表性。这套方案最终以15.41%的tcpMER排名第二,验证了模块化级联框架在复杂语音任务中的有效性。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
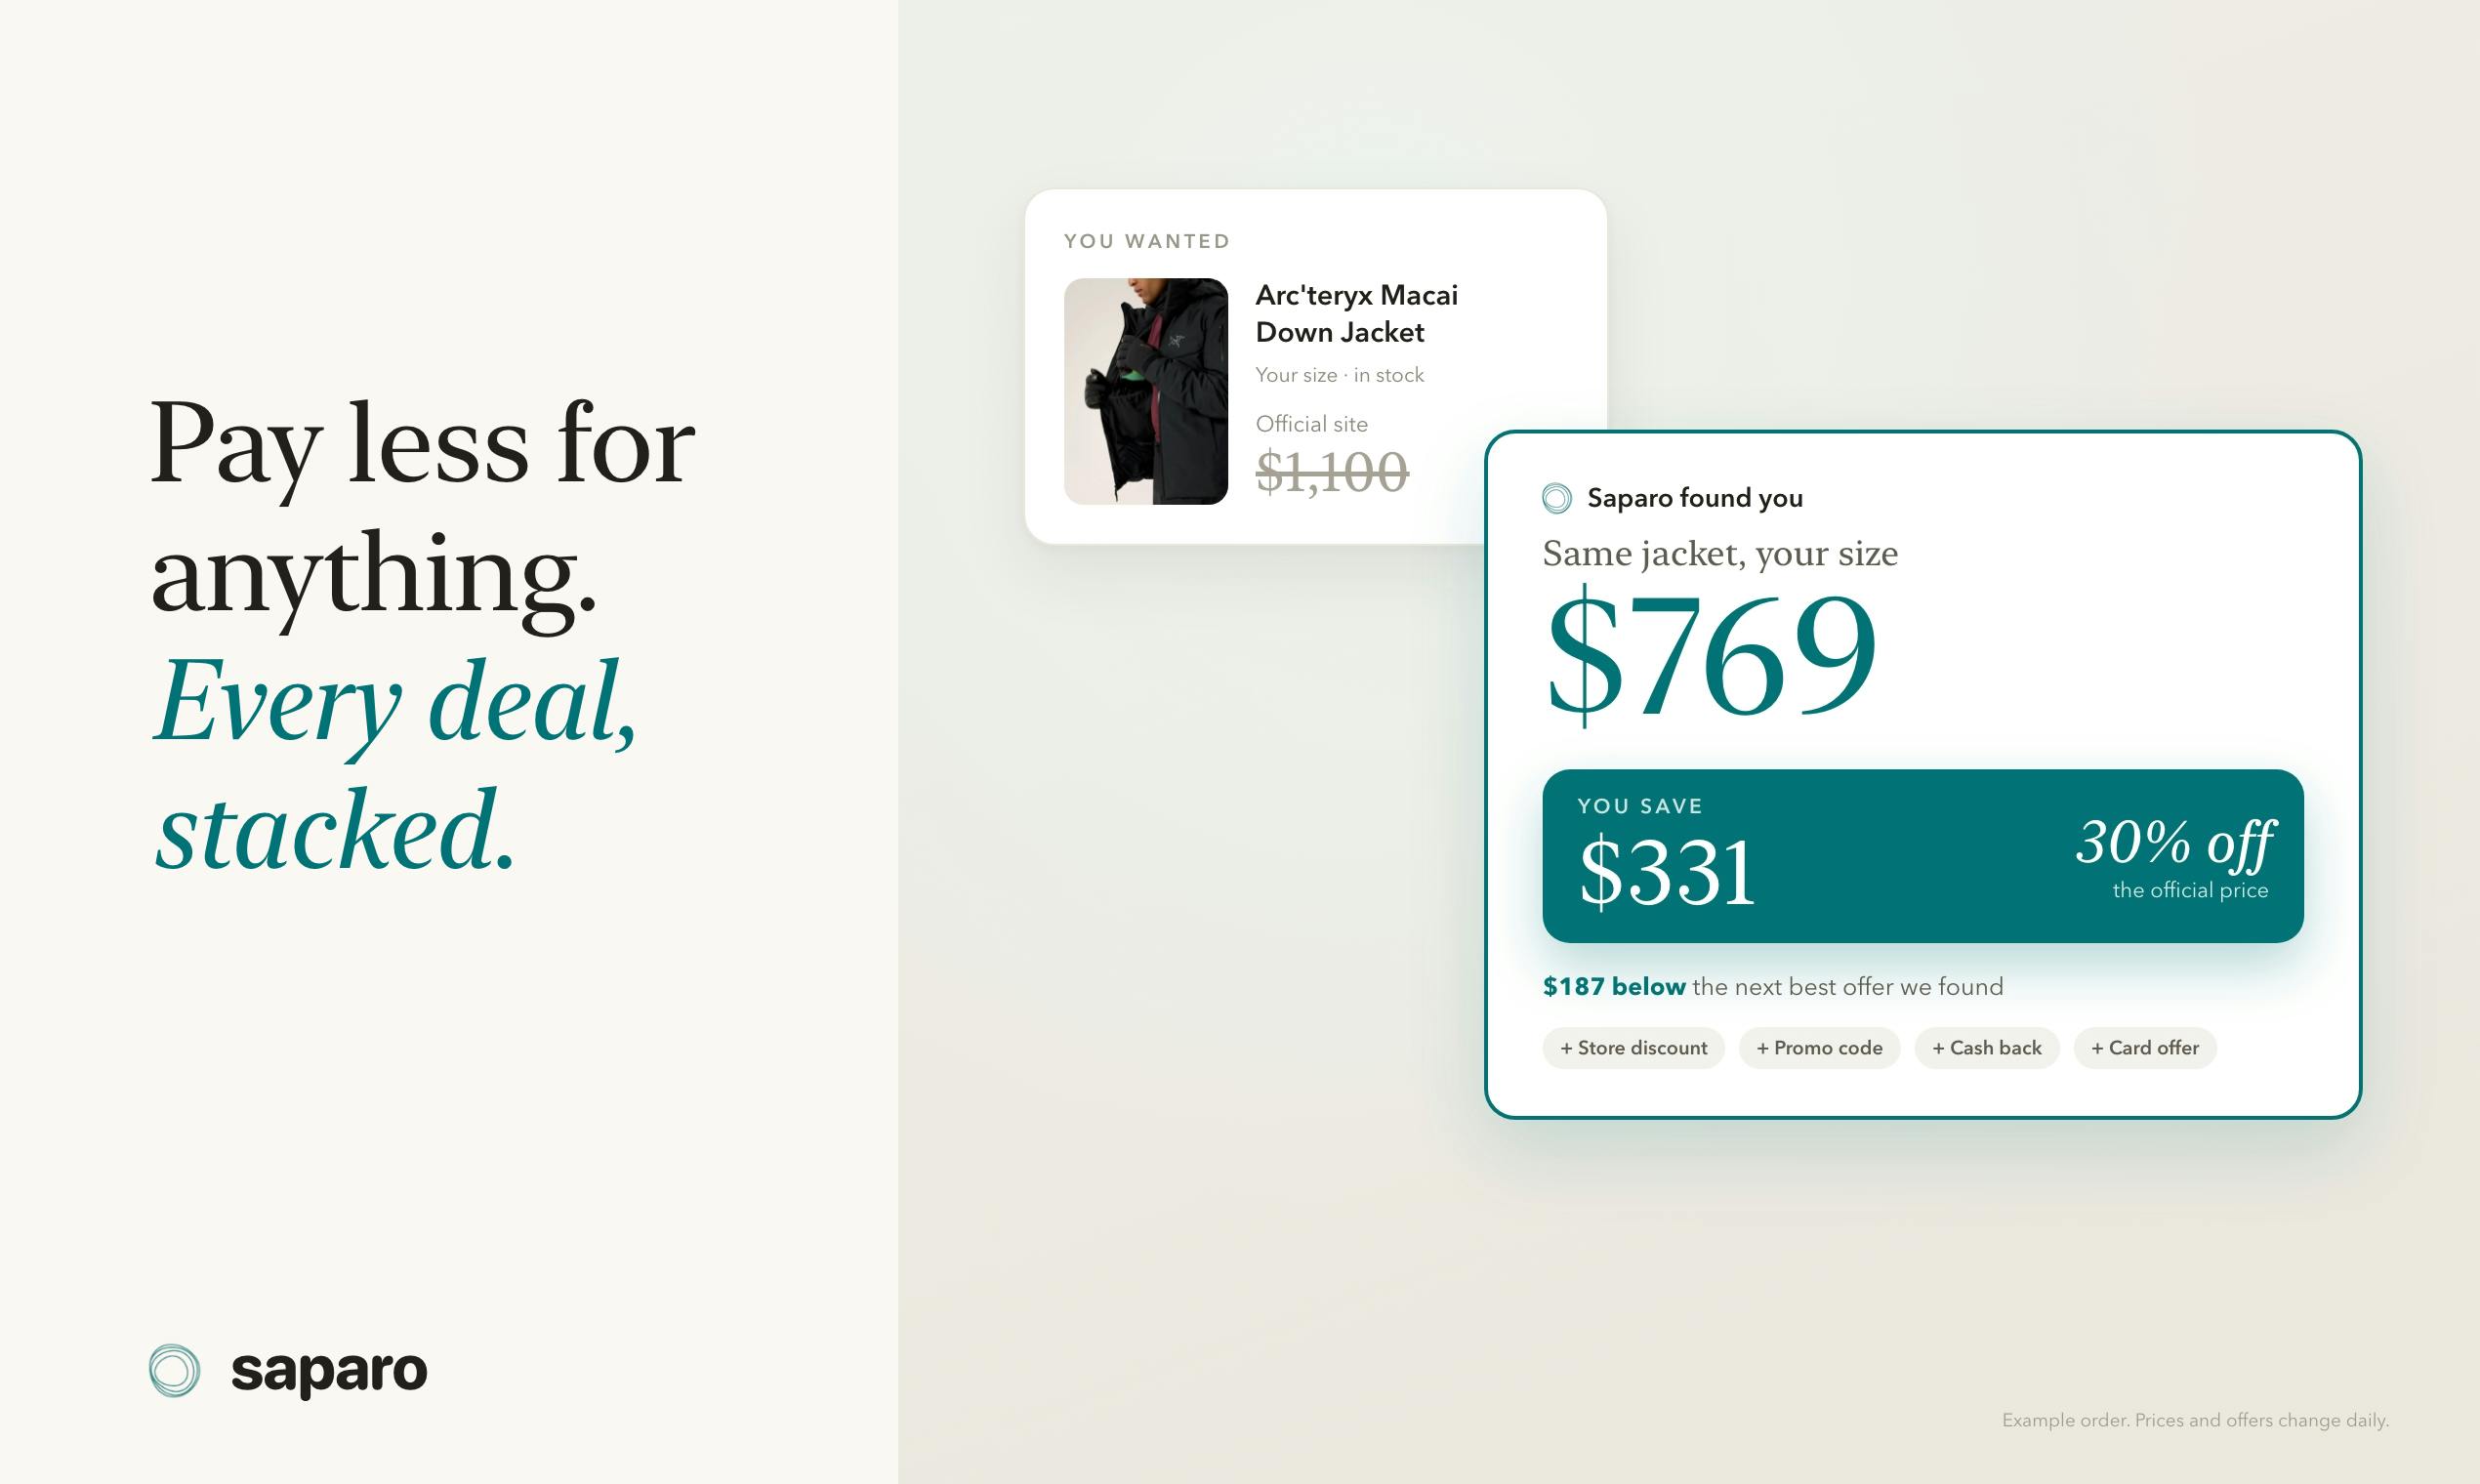
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
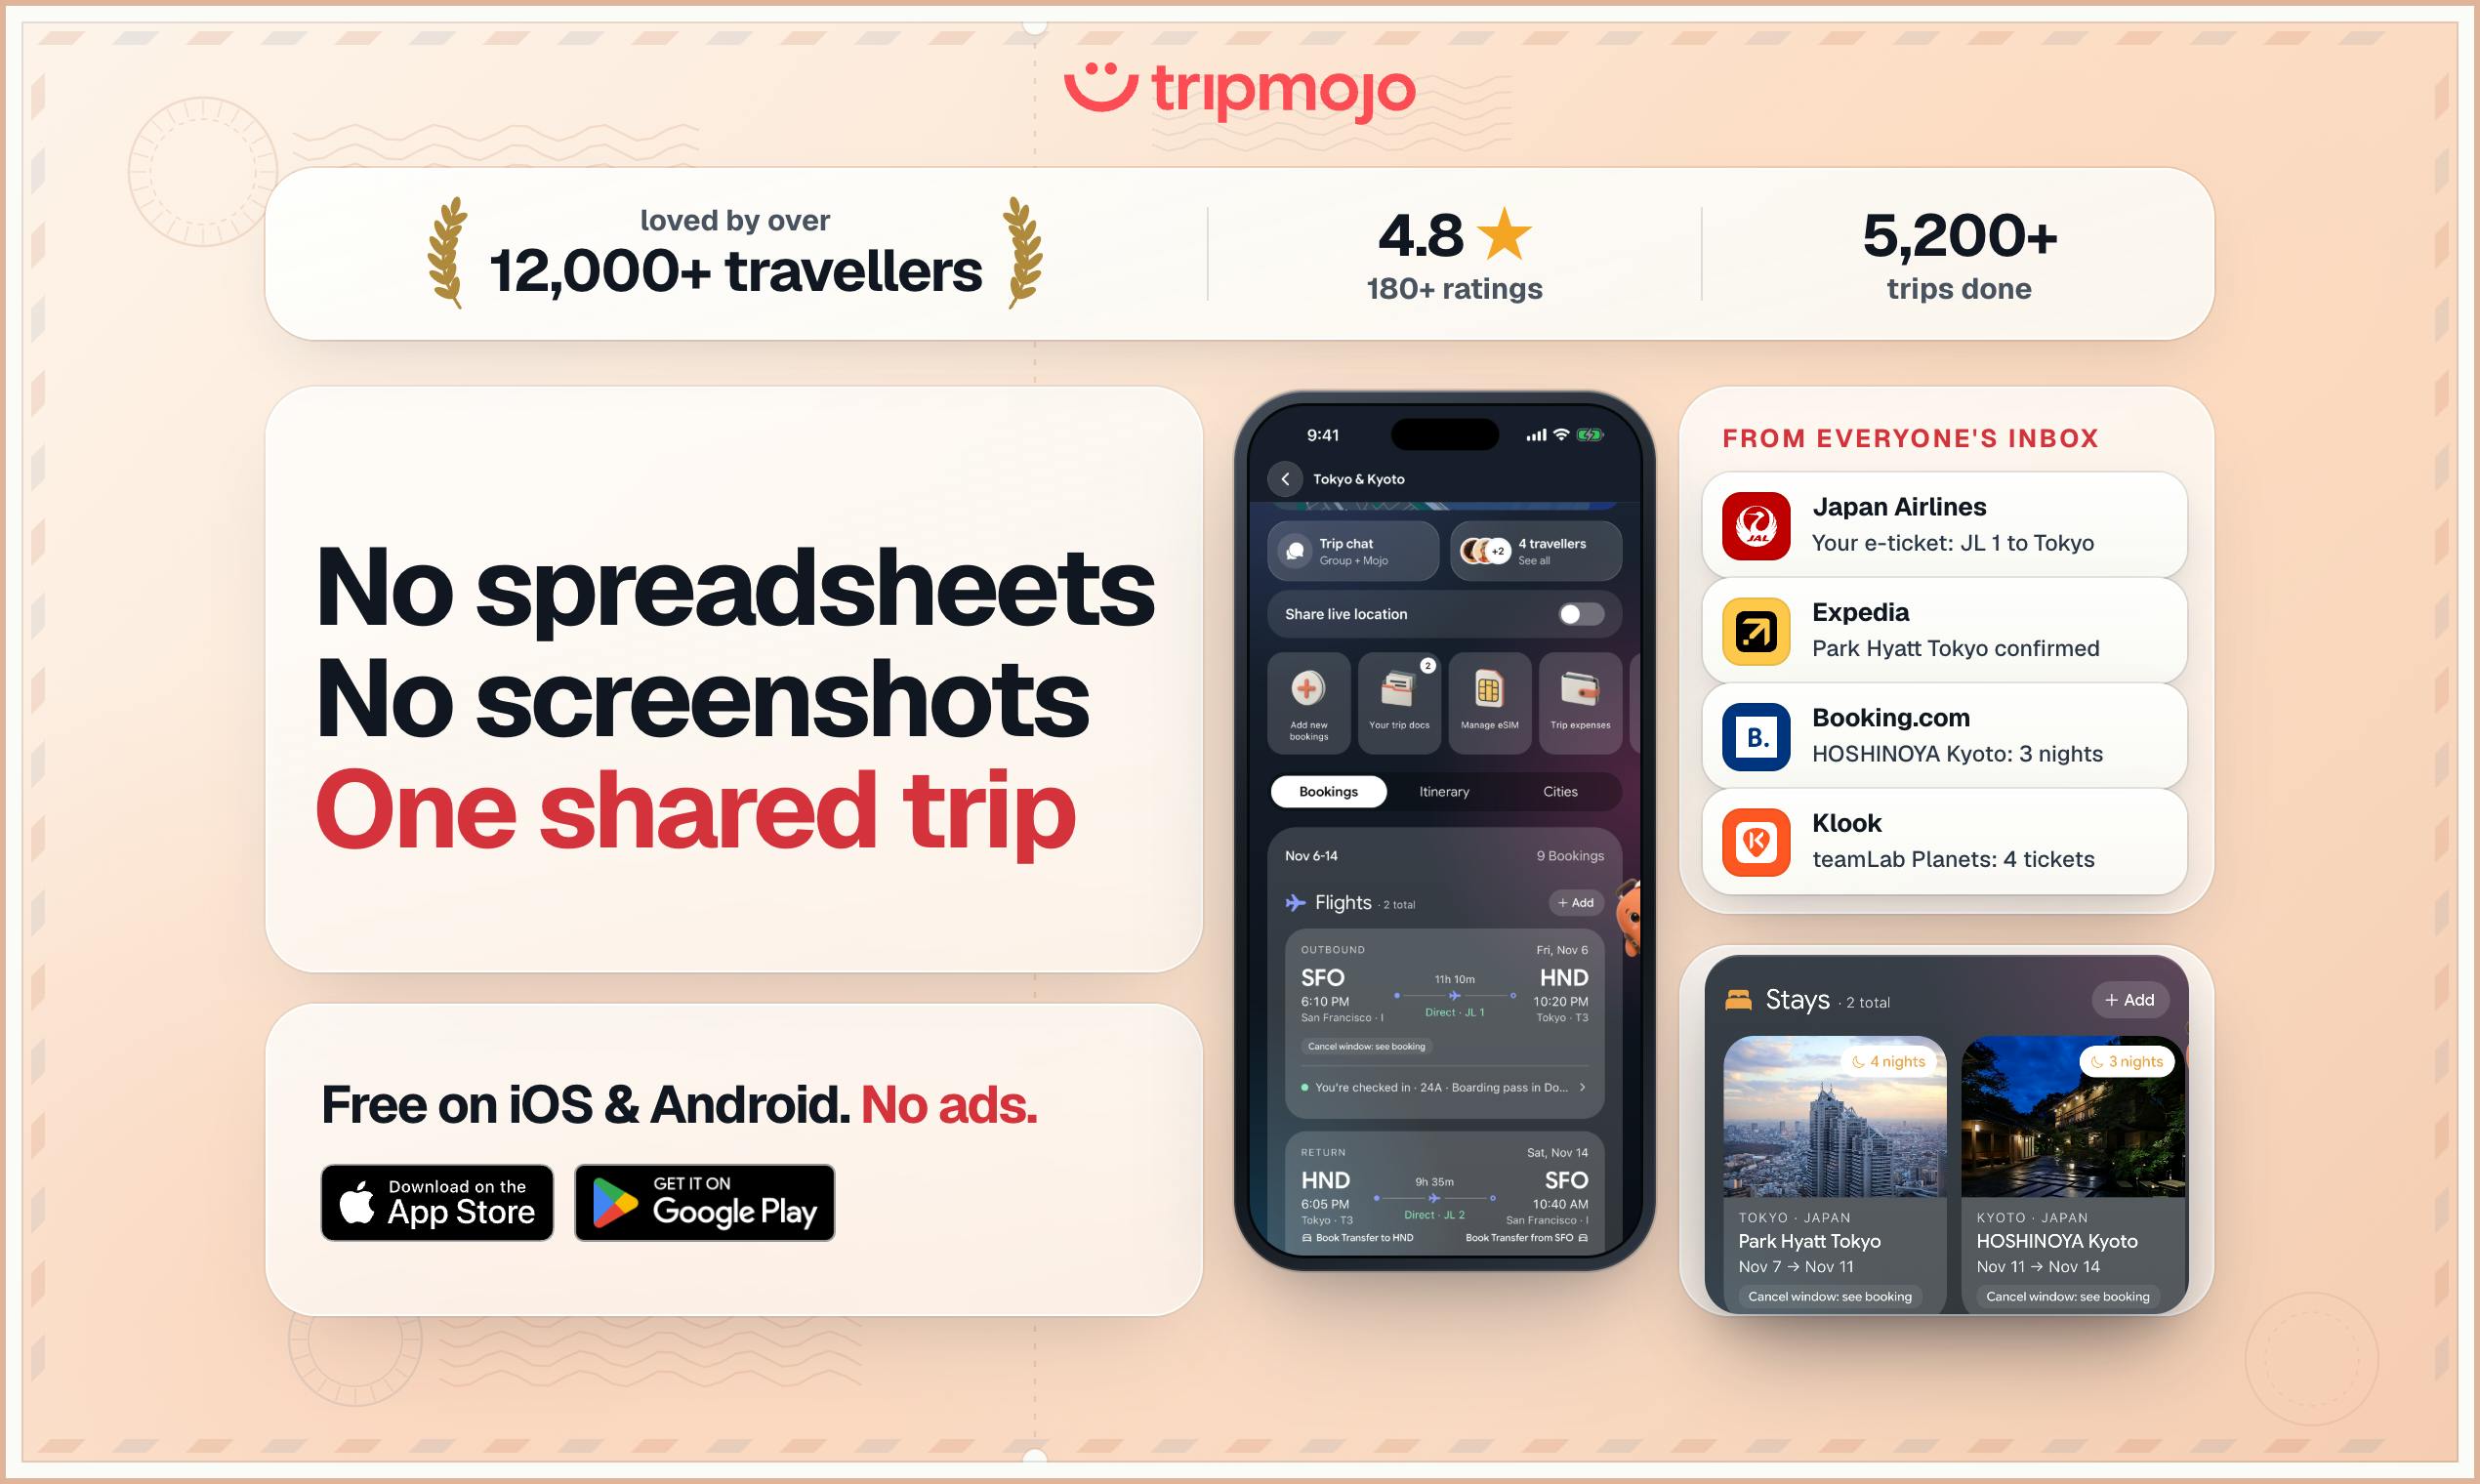
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。