Claude 安装 Kubuntu 时的「老头点赞」为何让人破防
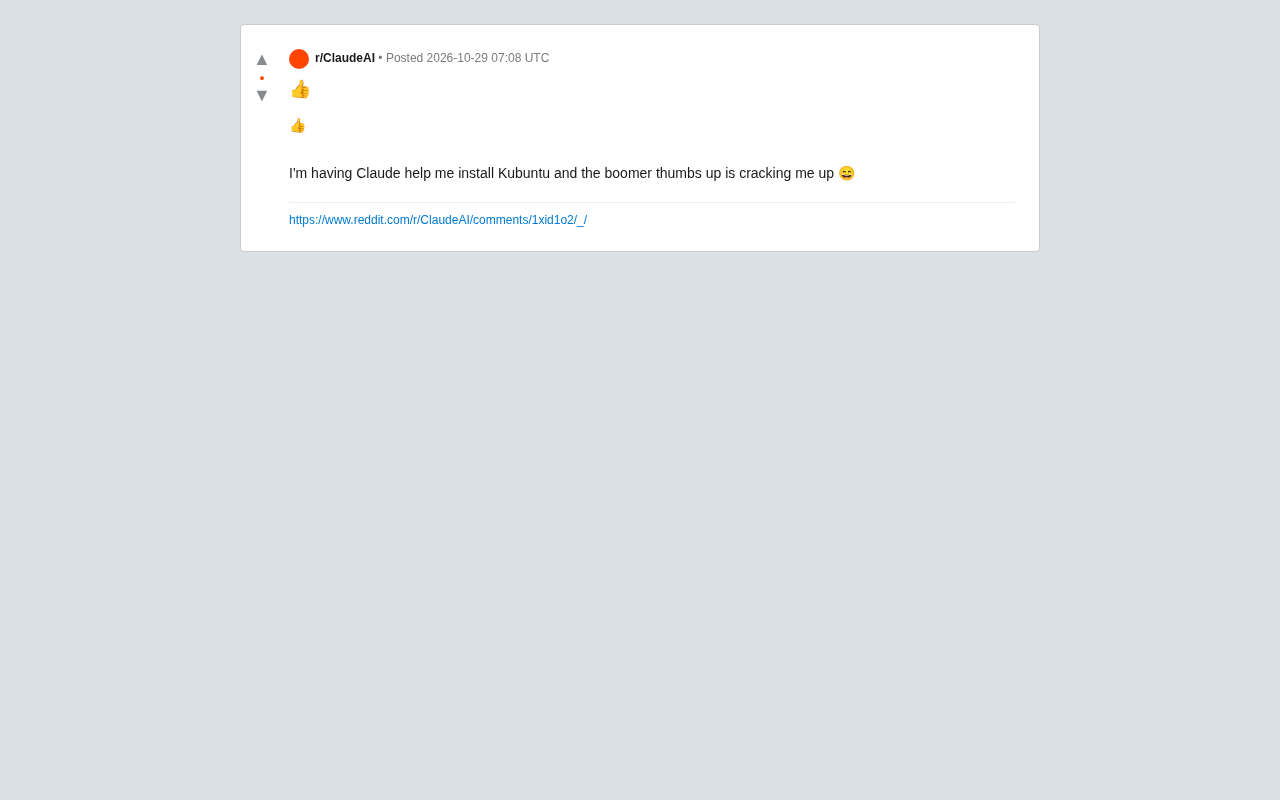
Claude 安装 Kubuntu 时的老派点赞语气,引发 AI 陪伴感讨论。
一条仅以「👍」为标题的 Reddit 帖子引发讨论:用户让 Claude 协助安装 Kubuntu,Claude 回复中带有「boomer thumbs up」式的鼓励语气,让用户觉得滑稽又亲切。文章指出,这种表达并非刻意设计,而是模型从人类对话数据中学到的社交习惯——先肯定再帮助。当对象是正在敲命令行的 Linux 用户时,这种加油打气形成反差笑点。帖子反映出用户对 AI 的期待正从单纯给答案转向协作陪伴,在分区、驱动、引导等多轮易错任务中,稳定语气能降低焦虑,也让人重新思考希望 AI 更像工具还是同事。
一个👍引发的共鸣
Reddit 上有一条帖子只用了「👍」作为标题,内容却意外地引发讨论:用户让 Claude 帮忙安装 Kubuntu,而 Claude 在回复中给出的「boomer thumbs up」(老一辈式竖大拇指)表情,把这位用户逗乐了。原帖写道:「I'm having Claude help me install Kubuntu and the boomer thumbs up is cracking me up 😄」。
这条内容之所以有意思,不在于安装 Kubuntu 本身有多复杂,而在于 AI 助手在技术协助场景中流露出的「人情味」——那种夹杂着鼓励、肯定、甚至有点过时的表达方式,与 Linux 安装这种硬核操作形成了微妙的反差。
为什么 AI 的「鼓励式语气」会让人觉得好笑
大模型在对话中往往被训练得更友好、更积极。当用户说「我要装 Kubuntu」时,Claude 不仅给出步骤,还会附上一句鼓励,比如「你能搞定的」「这个选择不错」。这种语气在人类交流中常见于长辈或教练,因此被用户戏称为「boomer thumbs up」。
说个细节,这种表达并非刻意设计。它来自模型在大量人类对话数据中学到的社交习惯:面对他人的求助,先给予肯定再提供帮助。只不过,当对象是一个正在敲命令行的 Linux 用户时,这种「加油打气」就显得格外滑稽。
「Boomer thumbs up」是英语互联网中的俚语,指年长一代(Baby Boomer,二战后婴儿潮出生的人)在短信或社交媒体中常用 👍 表情表示赞许、认可或「收到」。年轻用户常把这种用法视为过时、略显笨拙但真诚的沟通方式,因此带有轻微的调侃意味,并无强烈贬义。在 AI 对话语境中,模型从包含各年龄层用户的语料里习得了这种表达,当它出现在命令行安装这类年轻技术社群的场景中,代际语用差异就被放大成了笑点。
AI 编程助手正在进入「陪伴」场景
从这条帖子可以看出,用户对 AI 的期待已经不止于「给答案」。他们愿意把安装系统这类需要多轮交互的任务交给 Claude,并在过程中留意它的语气和个性。这反映出 AI 助手正从工具向「协作伙伴」的角色滑动。
对于开发者来说,这种陪伴感有实际价值:安装 Kubuntu 涉及分区、驱动、引导等容易出错的环节,一个语气稳定的助手能降低焦虑。用户把 Claude 的回复截图发到 Reddit,本质上是在分享一种「被机器鼓励到」的新奇体验。
Kubuntu 是 Ubuntu 的官方衍生版本,区别在于默认桌面环境使用 KDE Plasma 而非 GNOME。安装 Kubuntu 通常涉及制作启动 U 盘、选择分区方案、处理 UEFI/BIOS 引导模式、安装显卡或无线网卡驱动等步骤,对不熟悉的用户来说容易出现引导失败、分区误删等问题。正是因为流程存在多个易错节点,用户才会倾向于让 AI 逐步引导,并在多轮对话中反复确认,这也解释了为什么语气稳定性在此类任务中会被感知为有价值。
小结
这条 Reddit 帖子没有技术干货,却捕捉到了 AI 融入日常技术工作时的真实瞬间:一句老派的点赞,让枯燥的系统安装多了一点人情味。随着 AI 助手越来越多地参与开发与运维流程,这类「语气事故」或许会变成常态,也让我们重新思考:我们到底希望 AI 像工具,还是像同事。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。