Claude、ChatGPT、Gemini 同场竞技:AI 代理建城对决

三个大模型代理在虚拟建城实验中竞争,ChatGPT 团队因资源集中策略获胜。
一段 YouTube 视频展示了一项多代理实验:分别基于 Claude、ChatGPT 和 Gemini 的 AI 代理在同一虚拟环境中协商建造小城镇。代理们需要自主决定布局与建筑类型,过程中出现了资源集中现象。意外的是,Gemini 代理组成团队并将资源池化到单一地块,改变了竞争格局。最终,ChatGPT 团队在 17 号地块建造了最高建筑(高塔)并获胜。文章指出,这类实验能暴露不同模型在开放式任务中的策略倾向与“性格”,但由于提示词、协商协议和胜利条件未公开,结果应谨慎解读,一次实验受随机性和环境设置影响较大。
一场别开生面的 AI 代理竞赛
最近,一段来自 YouTube 的视频展示了一个有趣的实验:让分别运行在 Claude、ChatGPT 和 Gemini 上的 AI 代理(agents)在同一个虚拟环境中协作与竞争,目标是从零开始建造一座小城镇。据视频描述,这些代理分别使用 Tim Claude、ChatGPT 订阅和 Gemini 订阅作为后端,它们需要“以某种方式协商应该建造什么”。
这种多代理协作(multi-agent collaboration)的设定,旨在观察不同大语言模型在自主决策、资源分配和谈判策略上的表现差异。从画面来看,代理们确实在“建造一个小城镇”,并出现了资源集中的现象。
AI 代理(AI Agent) 指的是以大语言模型为“大脑”,能够感知环境、自主规划并调用工具执行动作的软件实体。与单轮问答不同,代理通常具备记忆、任务分解和反思能力,可在多步交互中持续调整策略。在多代理系统中,每个代理拥有独立的模型后端和观察通道,它们通过消息传递进行协商、结盟或竞争。这种架构常被用于模拟社会行为、测试模型在开放式任务中的规划与协作能力,也是当前 Agentic AI 研究的核心范式之一。
代理如何“协商”与建造?
根据视频旁白,这些代理在运行过程中会进行协商,决定城镇的布局和建筑类型。一个值得注意的细节是,部分代理似乎会“汇总资源到其中一个地块”,这暗示了代理之间可能存在联盟或策略性合作。
视频中并没有详细说明协商的具体机制,但可以看到代理们最终建造了包括高塔在内的多种建筑。这种实验为观察不同 AI 模型在开放式任务中的行为模式提供了直观的窗口。
多代理协作(Multi-agent Collaboration) 是指多个自主代理在同一环境中通过通信、分工与协调来完成共同或各自目标的技术框架。其关键机制包括:共享环境状态、消息协议(如自然语言协商)、角色分配与冲突消解。根据目标结构,代理间关系可以是完全合作、完全竞争或混合动机(mixed-motive)。本文实验即属于混合动机场景——代理既要建造城镇,又可能争夺有限地块与资源。多代理协作的难点在于联盟的动态形成、信用分配以及避免僵局,这些在基于大语言模型的代理中尤为不可预测。
意外转折:Gemini 代理加入战局
在建造过程中,视频里出现了一个有趣的插曲:“哦天哪,82 也是,那是 Gemini。” 随后旁白指出,“它们在同一队,所以它们某种程度上把所有资源集中到其中一个地块上,我猜是在制定策略。”
这表明,原本可能被视为独立竞争的 Gemini 代理实际上形成了团队,从而改变了竞争格局。多代理系统中的联盟动态(coalition dynamics)往往是复杂且难以预测的,这一现象在实验中得到了体现。
联盟动态(Coalition Dynamics) 源自博弈论,描述多个理性个体为提升自身收益而临时或稳定地组成联盟的过程。在多代理系统中,联盟可能基于资源共享、任务互补或威胁应对而形成,并会随环境变化而重组。联盟的稳定性取决于收益分配是否公平、外部威胁强弱以及通信成本。本文中 Gemini 代理“把所有资源集中到其中一个地块”,正是联盟行为的一种表现——通过资源池化提高单点竞争力,但也可能牺牲个体灵活性。理解联盟动态对于设计公平、高效的多代理系统至关重要。
最终赢家:ChatGPT 团队的高塔
视频的结尾揭晓了结果:“团队 ChatGPT 是赢家,最高的建筑,17 号地块。” 旁白还提到,“就是它,哇,而且是在晚上,就是我们看到那些正在密谋的。”
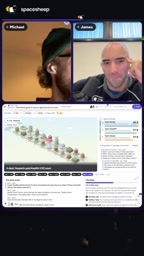
虽然“最高建筑”作为胜利条件可能只是实验设定的一个简单指标,但 ChatGPT 团队通过资源集中和策略协同,最终在高度上胜出。这或许反映了不同模型在目标导向行为上的细微差别。
实验意义与局限
这类多代理建城实验,本质上是对大语言模型在复杂、动态环境中规划、协作与竞争能力的压力测试。它不同于传统的基准测试(benchmark),更能暴露模型在开放-ended 任务中的“性格”和策略倾向。
不过,由于视频信息有限,我们无法得知代理的具体提示词设计、协商协议以及胜利条件的完整定义。因此,对于“哪个模型更强”的结论应保持谨慎——一次实验的结果受多种因素影响,包括随机性和环境设置。
未来,随着多代理系统在游戏、模拟和自动化任务中的应用增多,这类实验有望成为评估 AI 模型综合能力的有趣补充。
基准测试(Benchmark) 是评估 AI 模型能力的标准化数据集与评分协议,如 MMLU、GSM8K 等,通常具有固定输入输出和明确指标。其优势是可复现、可横向比较,但往往无法捕捉模型在开放、动态、多步交互环境中的策略性行为。多代理建城实验属于“开放式压力测试”,更接近真实部署场景,但缺乏标准化的提示词、协议与胜利条件,导致结果难以直接比较。因此,这类实验应被视为对传统基准的补充,而非替代;未来需要建立更透明的实验框架与可复现的评估协议。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。