Claude Code、Codex、Antigravity、Cursor怎么选?按任务分配AI编程工具
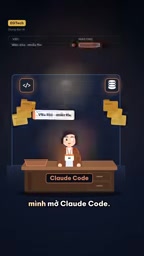
AI编程工具应按任务类型而非厂商排名来选择,四款工具各占一个场景生态位。
一位同时使用 Claude Code、Codex、Antigravity 和 Cursor 的开发者提出,选 AI 编程工具不应按厂商排名,而应按任务类型分配。他把工作分为四类:架构修改和深层 bug 交给 Claude Code,因其先规划再执行、返工少;边界清晰的测试与琐碎修复交给云端运行的 Codex,可批量派发后统一审批;界面调试用内置浏览器操作且有免费套餐的 Antigravity,以高频试错消化轻量任务;手动编码时用 Cursor 的补全保持心流。快速问答则直接用网页端。他还建议提前编写项目说明文件,让多数工具读取,从而降低跨工具切换的上下文成本。
为什么“哪个AI编程工具最好”是个错误问题
一位同时使用Claude Code、Codex、Antigravity和Cursor的开发者,在被反复问到“写代码该用哪个AI”时,给出了一个反直觉的答案:不要按厂商排名来选,要按任务类型来选。他在视频中明确表示,自己的选择逻辑是「按事选,不按品牌选」,并且强调这只是个人主观经验,且AI工具迭代极快,结论会随时间变化。
这个视角值得展开:当四款工具的能力边界逐渐清晰,真正的效率差距往往不来自工具本身的绝对强弱,而来自把任务交给了不合适的工具。以下是他划分的四类场景和对应选择。
高难度任务:Claude Code负责“想清楚再动手”
遇到动架构、深挖隐藏bug、重写大块代码这类任务,他会打开Claude Code。这类工作的共同点是需要理解整个项目、牵涉多个文件,而不是改一个函数就能收工。
他的观察是:Claude Code会先做计划再执行,速度慢一些,但返工少。这个取舍在复杂任务上是划算的——架构级改动的返工成本远高于首次执行的时间成本。换句话说,Claude Code的价值不在于快,而在于降低“改完发现方向错了”的概率。
什么是“先计划再执行”的代理循环?
Claude Code 这类工具的核心机制是“规划—执行—反思”循环:模型先把任务拆成子步骤,生成计划,再逐步调用读写文件、运行命令等工具,并在每步后根据结果修正计划。这与“补全式”助手(只预测下一段代码)有本质区别——后者不维护跨步骤的状态,也不主动验证执行结果。规划式代理的代价是每步都要额外的推理开销和工具调用往返,因此首轮耗时长;好处是能在动手前发现设计冲突,例如某个接口已被其他模块占用,从而避免“写完才发现方向错”的高额返工。理解这一机制,就能明白为何架构级任务更适合交给规划型工具,而单函数修改用补全型工具更划算。
边界清晰的任务:Codex适合批量外包
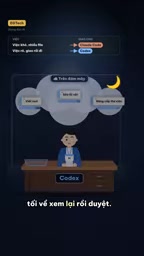
如果任务有明确的头和尾,交付后就能去干别的,他会交给Codex。典型例子是写测试、修琐碎的bug、升级依赖库。
Codex跑在云端,这意味着可以同时派发多个任务,晚上回来统一查看和审批。这是一种“异步外包”的工作模式:人不必盯着执行过程,工具在后台跑,人只负责验收。对于可并行、可预期的任务,这种模式的时间利用率明显更高。
你可能没注意到,视频中提到Claude Code现在也能自己打开浏览器,但Antigravity从设计之初就内置了这个能力。
云端异步代理与本地代理的差别
Codex 类工具运行在云端沙箱中,任务以“派发—排队—执行—回传 diff”的方式完成,人不需要保持会话在线。这与本地 IDE 内代理的关键差异在于:本地代理共享你的工作区和实时状态,但一次只能服务一个交互会话;云端代理每次在独立沙箱中克隆仓库,天然支持多任务并行,但需要显式的任务描述和验收环节。因此,云端异步模式适合“输入输出边界清晰、结果可自动或快速验证”的任务,例如补测试、修 lint、升级依赖版本;而需要频繁人工判断的探索性工作,在云端往返一轮的成本反而更高。
界面调试:Antigravity的反复试错优势
做UI时,需要反复点击、反复验证,他会用Antigravity。这类任务的特点是反馈循环密集——改一点、看一眼、再改一点,对即时可视化的要求高。
Antigravity从一开始就内置了浏览器操作能力,并且提供免费套餐。他的策略是把云端额度省下来留给高难度任务,日常的界面迭代用Antigravity消化。这是一个成本与场景匹配的分配思路:免费额度覆盖高频轻量场景,付费额度集中投在重任务上。
代理如何“操作浏览器”
内置浏览器操作能力,指代理可以通过浏览器自动化协议(如 Chrome DevTools Protocol)打开页面、点击元素、读取 DOM 与截图,并把结果回传给模型作为下一步决策依据。对 UI 调试而言,这意味着反馈循环从“人截图—粘贴给模型—模型改代码”压缩为“模型自己看—自己改”,每轮迭代的时间从分钟级降到秒级。反复试错类任务对单轮智能要求不高,但对循环次数极其敏感,因此这类能力的价值主要体现在高频轻量场景,而非一次性复杂重构。
手动编码:Cursor的补全手感
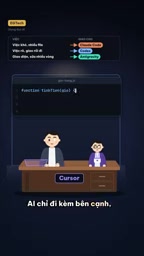
当他想自己动手写、AI只在旁边辅助时,Cursor是他认为最顺手的编辑器。他提到一个具体体验:敲半行代码,它能猜出后半行。
这种场景的定位很清晰——人主导、AI补位。补全的流畅度直接决定心流是否被打断,这也是Cursor在这类场景下的核心竞争力所在。
快速问答:网页端就够,不必装工具
如果只是快速问一句、贴一段报错请它解释,他会直接开网页版ChatGPT(视频中还提到了另一个网页端工具),不需要任何本地安装。
这一条容易被忽略,但逻辑成立:不是所有AI辅助都需要IDE插件或命令行工具。轻量问题用轻量入口,避免为了一个小问题启动重型工具链。
跨工具切换的关键:一份项目说明文件
他分享的一个实用技巧是:提前为项目写一份说明文件,目前大多数工具都能读取这个文件。这样在不同工具之间切换时,不需要每次都从头交代项目背景。
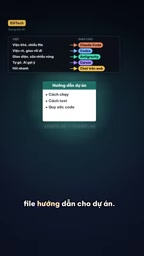
这个做法的价值在于把“上下文”从工具中解耦出来。工具的上下文窗口和记忆机制各不相同,但一份规范的项目说明文件是通用的,切换成本因此大幅降低。对于同时使用多个AI编程工具的开发者,这几乎是必备的基础设施。
项目说明文件为什么能跨工具通用
不同 AI 编程工具的上下文窗口大小、记忆持久化机制和检索方式各不相同:有的把整个仓库索引进向量库,有的只读取当前打开的文件,有的依赖会话历史。一份写在仓库根目录的项目说明文件(通常命名为 AGENTS.md、CLAUDE.md 或类似的约定文件)之所以通用,是因为它把“项目背景、构建命令、代码规范、禁忌事项”这些稳定信息固化成了纯文本,任何工具只要具备文件读取能力就能直接加载。它本质上是把上下文从工具的私有记忆里解耦出来,变成版本可控的仓库资产——这也解释了为什么它对多工具并用的开发者几乎是必备基础设施。
从“谁最强”到“派给谁”
整套方法可以归纳成一句话:不要问哪个AI最强,要问这个任务该派给谁。四种工具在这套逻辑里各占一个生态位——Claude Code负责深度规划,Codex负责异步批量执行,Antigravity负责高频界面迭代,Cursor负责手动编码时的补全,网页端负责轻量问答。
需要说明的是,这是单一来源的个人经验分享,并非系统性评测,作者本人也强调结论会随AI发展快速变化。工具的能力边界在持续移动,今天的分工可能在不久后需要重新划分。真正稳定的方法论是任务分类本身:先看清任务需要多深的项目理解、多快的反馈循环、是否可并行,再决定交给哪个工具。
相关推荐

Free Claude Code实测:零门槛接入DeepSeek全流程
Free Claude Code 实测:通过本地服务将 Claude Code 模型替换为 DeepSeek 等国内模型,保留终端 Agent 体验。本文梳理克隆安装、Providers 配置、Model Config 覆盖机制的完整流程,分析速度与成本优势及使用注意事项。
别再用紫色渐变!这个免费技能让AI网站秒变专业设计
Hallmark技能通过50个真实主题和硬性设计禁令,解决AI建站千篇一律的紫色渐变问题,并衍生出400美元的设计救援变现模式。本文解析其机制、商业逻辑与设计约束趋势。

AI自动化重塑Ripgrep文档:MkDocs实践解析
解析Ripgrep借助AI自动化与MkDocs重塑文档体系的实践思路,探讨内容生成、一致性校验与结构优化三个切入点,为开源项目文档维护提供可复制的低成本方案。