Claude Code Projects全面开放:AI智能体协作迎来新一波更新

本周AI圈密集更新,核心趋势是智能体从单任务助手走向多线程并行协作与生态整合。
本周AI领域的核心主题是智能体协作化与生态整合。Anthropic将Claude Code Projects向全体Pro/Max用户开放,允许用户设定一个目标后由协调者自动拆分为多个并行线程分别执行,并将结果汇报回同一对话;同步公测的托管智能体动态工作流则面向批量合同审阅等大规模任务,通过主控智能体编排多个执行智能体并行处理。OpenAI Codex新增Composer Predictions,可为Pro用户预测下一条消息输入。Devin打通了个人ChatGPT订阅额度,避免重复付费。此外,Qwen Image 2.1 Turbo开放权重并支持8步图像生成,Google AI Pro在Colab中引入80GB显存A100 GPU,可运行310亿参数模型无需压缩。整体趋势指向AI工具的可编排化与订阅生态的逐步整合。
本周五的AI圈迎来一轮密集更新,核心主题围绕一个方向——让AI智能体从「单打独斗」走向「团队协作」。Anthropic的Claude Code Projects全面开放,托管智能体支持任务拆分,OpenAI的Codex开始预测你的下一条消息,Devin也打通了已有的ChatGPT订阅额度。以下逐一拆解这些值得关注的变化。
Claude Code Projects:一个对话,多线程并行
Anthropic将Claude Code Projects从等待列表中释放,向所有Pro和Max用户开放。这项功能的核心逻辑颇具代表性:一个Project就是一场由「协调者(coordinator)」主导的对话。你只需给出一个目标,系统便会为每一块子任务开启独立的线程。
举例来说,当你询问「某个营销站点为什么加载缓慢」时,它会把工作拆分成八个线程,每个线程各自提交一个pull request,最终全部汇报回同一场对话中。这种设计让复杂任务的拆解与追踪变得透明——你既能看到整体进度,也能深入每个子任务的细节。
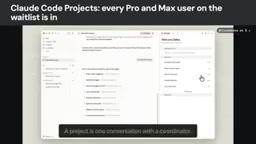
从实用角度看,如果你已经在为Pro或Max付费,这是本周末最值得优先尝试的更新。它把「让AI帮我完成一个大项目」从概念变成了可操作的工作流。
托管智能体:动态工作流进入公测
Anthropic的托管智能体(Managed Agents)同步推出了动态工作流(Dynamic Workflows)公测版。它要解决的问题是:当一项任务的子环节多到单个智能体难以承载时,由主导智能体先写出一份计划,再由服务器分阶段调度多个智能体执行。
一个典型场景是批量合同审阅——系统可以一次性读取300份合同并给出统一结论,比如识别出其中41份包含「控制权变更条款」。你只需在智能体定义中开启该功能,并通过预算上限控制整次运行的成本。
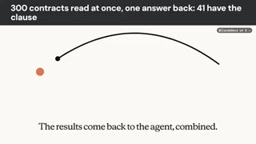
需要留意的是,这项能力是为大规模批处理任务设计的。如果只是单一任务、单个智能体就能搞定,传统方式反而更简单直接。换句话说,动态工作流的价值在于规模化,而非替代所有场景。
动态工作流背后的技术模式通常被称为「多智能体编排(Multi-Agent Orchestration)」。其核心思路是引入一个「主控智能体(Orchestrator)」负责任务规划与分解,再将子任务分发给多个「执行智能体(Worker Agents)」并行处理,最后汇总结果。这种架构的优势在于突破了单个大语言模型上下文窗口的长度限制——300份合同如果塞入单次对话往往会超出模型可处理的范围,而通过并行分片处理后合并结论,就能绕过这一瓶颈。预算上限(Budget Cap)机制则是对这类任务的成本管控手段:由于每个子智能体的每次调用都会产生API费用,主控层在分发任务前会预估总token消耗,并在超出阈值时中止执行,防止因任务设计不当导致费用失控。
OpenAI Codex:开始预测你的下一句话
OpenAI的Codex新增了名为「Composer Predictions」的功能,它会根据你的对话内容以及你的表达习惯,主动建议你接下来可能想输入的消息。目前该功能面向Pro用户开放测试。
客观地说,这是一个小幅的效率提升,暂时也仅限Pro用户使用。它更像是对交互体验的打磨,而非颠覆性能力的升级——但在高频使用场景下,节省下来的输入时间会逐渐累积成真实的价值。
Dots与Devin:移动化与额度打通
OpenAI上周推出的常驻智能体「Dots」现在可以直接从手机创建,iOS和Android的ChatGPT应用均已支持。这意味着启动一个常驻任务不再需要坐在电脑前,移动端随时可发起。
另一个对付费用户特别友好的变化来自Cognition——Devin现在可以接入任意个人ChatGPT订阅方案,无论是Go、Plus还是Pro。Devin调用GPT模型时,将直接从你ChatGPT方案的额度中扣减。
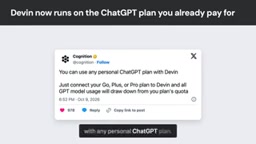
如果你同时为ChatGPT和Devin付费,现在就应该打开这个开关——这样可以避免为同一个模型重复付费。这类「订阅互通」的趋势,也反映出AI工具生态正在逐步整合,减少用户的重复成本。
其他值得关注的发布
除上述主线更新外,本周五还有两项面向开发者和创作者的发布:
- Qwen Image 2.1 Turbo开放权重:通义千问广告团队发布了该模型的开放权重版本,可在8步内完成图像的生成与编辑,大幅压缩了推理步数,对追求效率的图像工作流颇具吸引力。
- Google AI Pro引入A100 GPU:Google的AI Pro方案现在在Colab中提供配备80GB显存的A100 GPU。这个显存规模足以在不进行压缩的情况下,运行310亿参数的Gemma模型。
Qwen Image 2.1 Turbo所采用的「8步生成」技术来自扩散模型领域的加速采样方法,核心思路是通过蒸馏(Distillation)或一致性模型(Consistency Model)等技术,将原本需要数十甚至上百步的去噪推理过程压缩到极少步数,同时尽量保持生成质量。传统扩散模型(如早期版本的Stable Diffusion)通常需要20-50步推理,每步都需要完整的前向传播,导致生成耗时较长。步数压缩后,单张图像的生成延迟可降低数倍,对需要高频出图的生产工作流意义显著。开放权重(Open Weights)则意味着研究者和开发者可以下载模型参数自行部署,而无需通过API调用,这在数据隐私要求较高或需要离线使用的场景中尤为重要。
A100 GPU的80GB显存规格对模型运行能力有直接影响。大语言模型在推理时需要将全部参数加载到显存中,以BF16精度为例,310亿参数约占62GB显存,恰好能被80GB的A100容纳而无需量化压缩。量化(Quantization)虽然能将显存占用减半,但通常会带来一定的精度损失;使用足够大的显存直接运行原始精度模型,是对模型能力损耗最小的部署方式,这也是80GB这一规格对研究者吸引力所在。
小结:智能体协作成为主旋律
纵观本周的更新,一条清晰的脉络浮现出来:主流AI厂商都在推动智能体从单任务助手,走向可拆分、可编排、可规模化的协作系统。Claude Code Projects和托管智能体代表了「多智能体并行」的方向,而Devin与ChatGPT的额度打通则体现了「生态整合、降低重复成本」的趋势。
如果本周末只打算尝试一样东西,Claude Code Projects是最值得优先体验的;而如果你同时为ChatGPT和Devin付费,打通额度的开关则应立即打开。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。