Claude Code 实战全解:安装、MCP、Skills 与 SubAgent 技巧
系统讲解 Claude Code 安装、登录绕过、MCP、Skills、SubAgent 与 CLAUDE.md 的实用配置。
文章基于一场公开课,把 Claude Code 的关键使用环节串成一条完整链路。安装环节推荐用 npm 而非 PowerShell/CMD,以规避国内网络下的下载失败;登录环节建议用 CC Switch 配置第三方供应商的 API Key,绕过官方账号登录以规避封号风险,并提醒它是按工具分开配置的。随后介绍权限模式与内置斜杠命令的价值,说明 MCP 如何让 Claude Code 接入数据库、文件系统等外部资源,Skills 如何把反复出现的流程固化为可复用能力包,SubAgent 如何通过拆分任务并行处理复杂工作,以及 CLAUDE.md 作为项目级上下文文件应写什么、不该写什么。最后回到“为什么直接说帮我写个贪吃蛇效果不好”,指出结构化输入才是发挥这些组件作用的前提。
很多开发者用 Claude Code 的方式还停留在"打开终端、敲一句自然语言、等它出代码"。这种用法不是不行,但效果往往一般。问题不在于模型能力,而在于没有把 Claude Code 自身提供的组件用起来。本文基于一场公开课的内容,把安装、权限模式、MCP、Skills、SubAgent 以及 CLAUDE.md 文件这几个关键环节串起来讲一遍。
安装:为什么推荐 npm 而不是 PowerShell
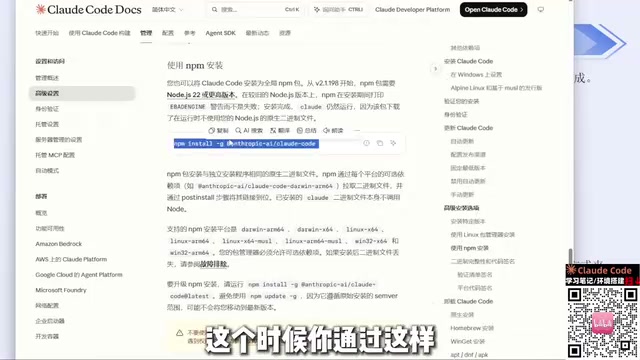
官网提供了多种安装方式,Windows 用户在 PowerShell 或 CMD 里执行对应命令即可。但国内网络环境下,这两种方式的成功率并不稳定——运营商限制一多,很容易卡在下载环节。
更稳妥的路径是走 npm 安装。官网在"高级设置"里有明确指引,执行一条 npm 命令即可完成。前提有两个:装好 Node.js(要求 22 以上版本,直接去官网下最新版),以及装好 Git。两者都是傻瓜式安装,一路下一步就行,C 盘空间紧张可以换安装目录。
安装完成后,在命令行输入 claude --version,能正常输出版本号就说明装好了。这个方式目前没有遇到过报错。
绕过登录:CC Switch 的配置思路
首次启动 Claude Code 时会走三步:是否信任当前文件夹、选择界面主题、选择登录方式。第三步是关键——用官方账号登录,有被封号的风险,而且不少人已经被封过多次。
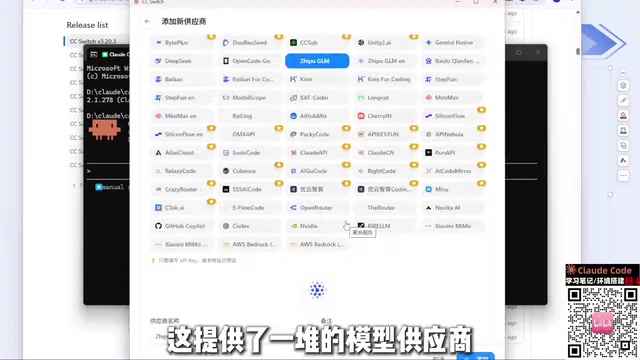
更省事的做法是用 CC Switch 这个工具。它原本是 GitHub 上的开源项目,现在做成了网站,在 Release 页面可以下载 Windows 安装包。装好之后打开,界面上可以针对 Claude Code、Codex 等不同工具分别配置。点加号,选择模型供应商(DeepSeek广告、智谱等市面上通用的供应商基本都覆盖了),填入对应的 API Key,保存即可。供应商列表里没有的,走"自定义配置"填中转站地址和 Key 同样能用。
配置好之后再启动 Claude Code,登录步骤会被直接跳过。没有账号登录,自然也就不存在封号问题。这个方式用了几个月,一直比较稳定。
需要注意的是,CC Switch 是按工具分开配置的。在 Codex 里配了 DeepSeek,不代表 Claude Code 能直接用,切换工具时要记得对应切换配置。另外,之前流行的"在环境变量里配 API Key"的做法同样有封号风险,不建议再用。
权限模式与内置命令
信任文件夹之后,Claude Code 会进入一个权限模式。不同模式决定了它在执行命令、修改文件时是否需要逐次确认。日常开发建议保留确认环节,尤其是涉及删除、批量重写这类不可逆操作时;如果是在隔离的测试目录里跑,可以适当放宽。
内置命令是提升效率的关键。用斜杠开头的命令可以完成上下文管理、会话恢复、配置查看等操作,比反复打字描述需求快得多。很多人只把 Claude Code 当聊天框用,恰恰是漏掉了这一层。
MCP:把外部能力接进来
MCP(Model Context Protocol)解决的是"Claude Code 能看见什么、能操作什么"的问题。通过 MCP 服务器,它可以接入数据库、文件系统、第三方服务等外部资源,而不只是局限在当前代码目录里。
配置方式是在设置中登记 MCP 服务器,重启后生效。实际使用中,MCP 的价值在于减少手工搬运上下文——让模型直接查询真实数据,比把数据复制粘贴进对话要可靠得多。
MCP 由 Anthropic 于 2024 年底提出,其设计思路类似编程领域的 LSP(Language Server Protocol):LSP 把编辑器和各种语言的分析能力解耦,MCP 则把 AI 应用和外部工具、数据源解耦。协议本身基于 JSON-RPC,定义了三类核心能力——Tools(可被模型调用的函数)、Resources(可读取的数据,如文件、表结构)、Prompts(预设的提示模板)。只要某个服务实现了 MCP 服务器接口,Claude Code、Claude Desktop 等任意 MCP 客户端都能直接复用,无需为每个客户端单独写适配。这也是它比早期的“自定义插件”更值得投入的原因:一次实现,多处可用。
Skills 与 SubAgent:拆分复杂任务
Skills 可以理解为可复用的能力包,把某一类反复出现的任务流程固化下来,需要时直接调用,避免每次从零描述。对于团队协作场景,这相当于把个人经验沉淀成共享资产。
SubAgent 则是把复杂任务拆给子代理并行处理。主代理负责规划和汇总,子代理执行具体环节。任务越复杂、涉及面越广,这种拆分带来的收益越明显。
SubAgent 与普通对话的关键区别在于上下文隔离。子代理拥有独立、干净的上下文窗口,只接收主代理下发的任务描述,处理完再把结论回传。这样做有两个好处:一是避免大量中间过程(比如一次检索几十个文件的内容)污染主对话,主代理的上下文始终保持在规划层面;二是子任务可以并行,彼此不阻塞。代价是子代理看不到主对话里的隐式前提,因此任务描述必须写得足够自包含——这也解释了为什么 SubAgent 的效果高度依赖拆分粒度是否合理。
CLAUDE.md:项目上下文的落脚点
CLAUDE.md 是项目级的上下文文件,用来告诉 Claude Code 这个项目的技术栈、目录约定、编码规范和注意事项。把它写好,能显著减少"模型不理解项目结构、生成代码风格对不上"的情况。
写这份文件不需要面面俱到,重点是把那些"新人来了必须交代"的信息写清楚:构建命令、测试方式、哪些目录不要动、有哪些历史遗留的坑。这部分内容的质量,往往比提示词的措辞更影响最终产出。
CLAUDE.md 的加载机制值得了解:Claude Code 启动时会自动读取当前工作目录及各级父目录中的 CLAUDE.md,将其内容作为系统提示的一部分注入,因此项目级约定无需每次在对话中重复交代。相应地,它也有成本——文件越长,占用的上下文预算越多,留给实际代码和对话的空间就越少。实践中建议控制在一屏以内,只写“看代码看不出来”的信息;构建命令、目录用途这类内容尽量精简,历史背景类的说明可以拆到独立文档里按需引用。
关于模型选择的一点观察
在 CC Switch 里可以自由切换供应商。据讲者自己的使用感受,DeepSeek Harness 在缓存命中率上表现相对更好,用起来更省;其他编程 agent 的缓存命中率则没那么高。这属于单一来源的个人体验,仅供参考。
另一点是,国内模型能力已足以覆盖日常开发需求,不必过度追求海外模型。为了体验前沿能力去冒封号风险,性价比并不高。
从自然语言到结构化使用
回到开头的问题:为什么直接说"帮我写个贪吃蛇"效果不好?因为这句话没有框定技术选型、运行环境、功能范围。新版本 Claude Code 已经开始主动追问这些信息,比如让你选择用 HTML 实现还是其他方案、包含哪些玩法——这正说明结构化输入的重要性。
把这些组件用起来之后,Claude Code 才从一个"能聊天的代码补全"变成一个可配置、可沉淀、可扩展的开发工具链。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。