Claude Code 实战指南:掌握 AI 编程代理、MCP 与 Skills
Claude Code 将 AI 从聊天助手升级为终端内自主执行的编程代理,核心在于命令控制、上下文预算、权限分层与 MCP/Skills 扩展。
文章系统梳理了 Claude Code 作为终端内自主编程代理的运作逻辑。它与聊天助手的本质区别在于端到端执行能力,开发者角色转向指挥与校验。控制层依赖斜杠命令,/model 与 /usage 管理模型和成本,/compact 与 /clear 调控上下文,自定义命令固化重复流程。上下文应视为预算,/init 生成的 claude.md 充当项目永久记忆。权限方面提供 Plan、Manual、Accept Edits、Auto 四种模式,配合 Hooks 实现自动化安全校验。MCP 连接外部工具,Skills 注入组织方法,二者互补。TDD 循环让代理以可验证目标自主迭代,最终强调配置边界越清晰,自主空间越大。
从聊天助手到自主执行:AI 编程代理的范式转变
传统的 AI 聊天助手像是一本食谱——它告诉你步骤,但下厨的人始终是你。你仍然需要复制代码、粘贴到编辑器、手动运行。而 Claude Code 的定位完全不同:它直接运行在终端里,能读文件、写代码、执行部署,最后把可用的结果交到你手上。据该教程解释,这种「端到端执行」正是 AI 代理与 AI 助手的分水岭。
这一转变带来的直接影响是工作重心的迁移。开发者不再花时间做搬运和拼贴,而是转向「指挥与校验」:定义任务、设定边界、审查产出。Anthropic 将 Claude Code 形容为一个「不预设工作流的强力工具」,它给你对模型的原始访问权,怎么塑造完全取决于你。理解这一点,后面的所有命令、权限与工作流才有了统一的逻辑起点。
用斜杠命令掌控代理节奏
内置命令:模型切换与成本监控
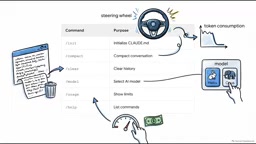
Claude Code 通过斜杠命令进行控制。/model 可在不同模型间切换,比如偏重速度的 Haiku 或能力更强的 Opus;/usage 则用来盯住账单额度,避免费用失控。这些命令构成了日常操作的基础层。
上下文管理:compact 与 clear 是方向盘
随着对话推进,终端里会堆积大量文本,这些内容都会进入上下文。教程强调,上下文过多会显著拖慢响应质量,因此 /compact 和 /clear 是控制代理行为与 token 消耗的关键手段——前者压缩历史,后者清空历史。它们不是可有可无的清理工具,而是维持代理稳定输出的「方向盘」。
自定义命令:把重复流程固化下来
对于反复出现的工作,比如完整的 PR 审查或规范的 git commit,可以在项目的 .claude/commands 目录下创建一个 Markdown 文件,在顶部写 YAML front matter(例如指定用 Haiku 加速、或预先开放 git 工具权限),再用 arguments 关键字接住动态输入。保存后输入类似 /fix-issue 123 的指令,整套流程就会被执行。
上下文预算与 claude.md 项目大脑
把 token 当成预算而非参数
教程建议换一个视角看待 token 上限:不要当作技术规格,而要当成一笔需要精打细算的预算。凡是 Claude 能看到的内容——文件、终端历史——都会消耗上下文。模型确有硬上限,Haiku 支持约 256,000 个 token,Opus 与 Fable 则达到约 100 万个,但一旦越过界限,表现会明显下滑,甚至开始产生幻觉;用超大模型处理琐碎任务同样是浪费预算。
/init 生成项目的永久记忆
/init 命令会生成一个 claude.md 文件,充当项目的「永久大脑」。与其每次开会话都重复解释项目结构、或反复提醒使用 ES modules 而非 CommonJS,不如一次性写进这个文件。Claude 在每个会话开始时自动读取它,瞬间载入架构约定、规则与代码风格。这是用一次性投入换取长期 token 节省的做法。
权限边界:给自主代理套上缰绳
把终端交给一个自主代理,威力巨大,风险同样真实——一旦疏忽,它可能误删整个文件系统。默认情况下 Claude 相当保守,执行危险操作前会暂停请求确认;而 /permissions 打开了自定义界面,你可以维护安全工具的白名单,也可以设定严格的拒绝规则,比如禁止读取环境密钥、禁止随意抓取网络数据。
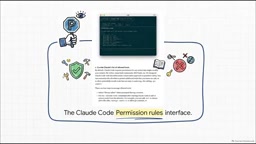
教程介绍了四种权限模式,用 Shift+Tab 快速切换:Plan 模式只读只分析,产出计划而不落地;Manual 模式是最安全的默认值,写文件前必须批准;Accept Edits 模式自动写代码,但执行 shell 命令(如 git、bash)前会停下询问;Auto 模式给予最高自主权,零人工批准直接执行代码与命令——需要格外谨慎,直到你真正信任这套配置再切换过去。
Hooks:把安全校验自动化
如果要追求企业级安全,Hooks 是重点。它允许在代理生命周期的特定节点运行 shell 命令,形成自动化的安全叙事:按下回车的瞬间,user-prompt-submit hook 可以拦截文本,检查是否意外泄露 API 密钥;Claude 执行 bash 命令前,pre-tool hook 可以校验命令内容;文件编辑成功后,post-tool hook 可以立即触发 Prettier 之类的代码格式化工具;任务结束时,stop hook 甚至能向 Slack 推送通知。安全从「人盯着」变成「机制盯着」。
Hooks 的执行模型基于代理生命周期事件,目前主要涵盖 PreToolUse、PostToolUse、UserPromptSubmit、Stop、Notification 等节点。每个 hook 在配置文件中声明匹配条件(如特定工具名)与要执行的 shell 命令,命令通过标准输入接收 JSON 格式的事件上下文,并可返回退出码或结构化输出来影响代理行为——例如 PreToolUse hook 返回非零退出码即可阻止该工具调用。这种机制将安全策略从「提示词约束」升级为「进程级强制」,因为 hook 运行在代理的控制流之外,模型无法绕过。企业可以借此实现密钥泄露扫描、命令白名单校验、审计日志记录与合规检查,而无需修改模型本身或依赖人工监督。
MCP 与 Skills:连接外部世界,注入组织知识
MCP 是通用适配器
大模型默认接触不到公司私有基础设施。MCP(Model Context Protocol)通过安装 MCP 服务器,安全地把外部数据源暴露给代理。教程给出的例子很直观:让 Claude 排查一个异常状态的 Kubernetes pod,它会通过 MCP 拉取集群日志、分析并给出修复方案。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底开源的标准化协议,旨在为 LLM 与外部数据源、工具之间建立统一的交互接口。在 MCP 出现之前,每个 AI 应用要接入数据库、代码仓库或监控系统,都需要单独编写定制化的插件或函数调用逻辑,碎片化严重。MCP 借鉴了 LSP(Language Server Protocol)的设计思想:定义一套通用的客户端-服务器协议,任何符合规范的 MCP 服务器都能被任何支持 MCP 的 AI 客户端调用。这意味着开发者只需实现一次服务器,即可在 Claude Code、Claude Desktop 等不同环境中复用。MCP 服务器通常以本地进程或远程 HTTP 服务的形式运行,通过标准输入输出或 SSE 与客户端通信,并声明自身提供的工具、资源与提示模板。
两者分工:MCP 管能力,Skills 管方法
这里有一个关键区分:MCP 服务器提供的是外部连接,给 Claude「能否」查询 Postgres 的物理能力;Skills 提供的是机构知识,是放在 .claude/skills 目录下的 Markdown 文件,教 Claude 团队认可的做事方式,比如 Kubernetes 部署的标准化流程。一句话概括:MCP 连接工具,Skills 教它怎么用工具。
Agent Skills 是 Anthropic 为 Claude 引入的一种轻量级知识注入机制。与微调或 RAG 不同,Skills 以纯 Markdown 文件形式存放在项目目录中,Claude 在需要时按名称和描述自动加载对应内容,无需人工切换。每个 Skill 文件可以包含流程说明、代码模板、检查清单甚至示例对话,本质上是把团队沉淀的最佳实践写成代理可读的「操作手册」。其设计哲学是渐进式披露:Claude 先看到技能列表与简短描述,判断是否相关后再读取完整内容,从而避免一次性占用过多上下文。这使得组织可以把部署规范、代码审查标准、故障排查流程等隐性知识显式化,并随项目版本一同管理,而不必依赖每次会话中的口头交代。
测试驱动开发:让代理自己逼近正确
因为 Claude Code 能自主运行,它在测试驱动开发(TDD)上优势明显。Anthropic 推荐的循环是:先让 Claude 依据预期输入写测试,并明确要求此刻不要写实现;接着让它运行测试并确认失败;然后放开实现代码,它会自主编写、运行、观察失败、调整、再运行,直到全部通过;最后让它收尾并提交。这个循环给代理一个清晰、可验证的目标,反复迭代后产出的软件韧性更强。
结语
Claude Code 的价值不在于替你写完所有代码,而在于把命令控制、上下文预算、权限模式、安全 Hooks 与 MCP 外部连接这些旋钮交到你手里。真正的差异来自你如何配置它:边界设得越清楚,自主运行的空间反而越大。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。