Claude Code Skills 技能入门:把重复工作流一键自动化
Claude Code 的 Skills 机制用 Markdown 文件封装可复用工作流,支持参数传递、模型指定与动态上下文注入。
Skills 是 Claude Code 中用于封装重复性多步骤工作流的 Markdown 文件机制,旨在解决 CLAUDE.md 和 permissions 只能被动定义规则、无法主动执行任务的局限。每个 Skill 文件放置于 `skills` 文件夹,包含 name、description 及可选的 front matter 配置。默认情况下,模型只接收 name 和 description,完整内容仅在调用时披露,有效控制了 token 消耗。Skills 现已与 Commands 合并,支持通过 front matter 指定模型、控制调用权限、传递运行时参数,企业用户还可通过 Managed Settings 统一管控团队行为。此外,动态上下文注入允许 Skill 在发送前执行 shell 命令并注入输出结果,极大增强了灵活性,但也带来了安全风险,可通过设置禁用。
为什么需要 Skills
在 Claude Code 中,我们可以用 CLAUDE.md 来塑造模型行为,也可以用 permissions 来约束它的操作边界。但这两者本质上都是被动的——它们定义规则,却不会主动帮你完成任务。
真实的开发场景里,往往存在大量需要反复执行的多步骤工作流:部署、集成、Q&A 循环等等。如果每次都要把同一段 prompt 重新敲一遍、把流程重新解释一遍,效率会非常低。这正是 Skills 要解决的问题。
简单说,一个 Skill 就是一个包含特定流程的 Markdown 文件。它把那些你本来要反复向 Claude 解释的多步骤操作固化下来,而且可以做到项目级别的定制。无论是部署脚本、第三方集成,还是代码审查循环,只要是你需要多次执行的事情,都可以封装成 Skill。
用 Skill Creator 快速创建技能
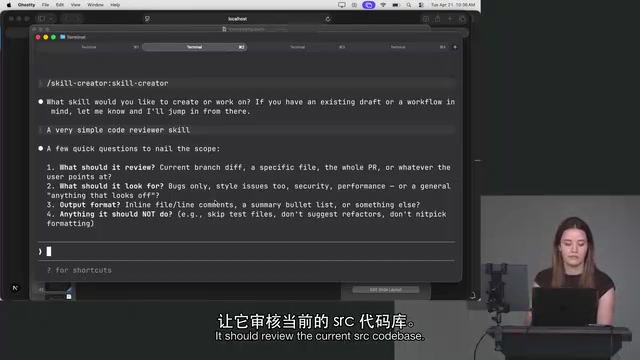
Lydia 在演示中推荐了一个内置的实用工具——Skill Creator。它可以让你用自然语言描述需求,由 Claude 自动帮你生成 Skill 文件,省去手动编写的麻烦。
这里其实隐含了一个更重要的思维转变:当你遇到一个重复性问题时,第一反应不该是"我要去代码库里手写实现",而是先问一句——"Claude Code 是不是已经能自动完成这件事了?"把日常工作尽可能地"Claude 化",是用好这类工具的关键心态。
当然,自动生成有时会"用力过猛"。演示中 Skill Creator 问了太多问题、尝试做太多事,Lydia 索性直接复制结果自己动手创建。这也提醒我们:工具是辅助,最终的流程设计仍然需要人来把关。
Skill 文件的结构与加载机制
创建 Skill 的规则很明确:需要建立一个 skills 文件夹(注意是复数),在其中放置 skill.md 文件。这是 Claude Code 约定的目录结构。
一个 Skill 文件通常包含 name(名称)和 description(描述)两个关键字段。比如名为 review 的技能,描述写成"审查当前项目的 SRC 代码库、报告 bug"等等。
这里有一个容易被忽略、但对成本很重要的细节:默认情况下,发送给模型的只有 Skill 的 name 和 description,而不是完整的 Markdown 内容。也就是说,即使你在 Skill 里写了大段详细流程,这些内容在平时也不会计入你的 token 使用量。只有当这个 Skill 真正被调用时,完整内容才会被披露给模型。
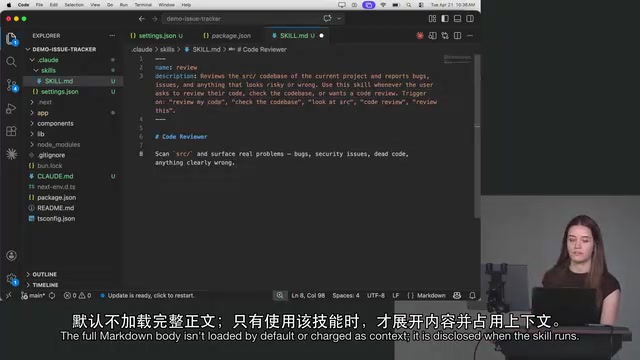
至于 Skill 何时被触发,取决于它的 description。当你在 prompt 里说"审查这个代码库"而模型一时不确定怎么做时,它看到有一个叫 review 的 Skill,就可能自动调用。当然,你也可以作为用户显式调用它。
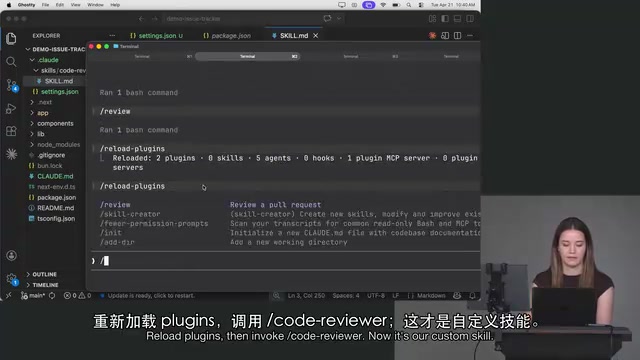
一个值得注意的变化是:过去 Skills 和 Commands 是两套独立机制,现在已经合并为一体——Skills 同时也是 Commands。新增 Skill 后需要执行 reload plugins,Claude Code 才能识别到新内容。
CLAUDE.md 是 Claude Code 项目级配置的核心文件,通常放在项目根目录,用于向模型提供持久性的上下文信息,例如项目架构说明、编码规范、常用命令等。它在每次会话启动时自动加载,相当于给模型的「系统提示词」补充。Skills 和 CLAUDE.md 的分工因此很清晰:CLAUDE.md 负责「模型应该了解什么」,Skills 负责「模型应该如何执行某类任务」。两者结合,可以构建一个既有背景知识、又有行动程序的完整 AI 工作伴侣。Front matter 是 Markdown 文件顶部由 --- 包裹的 YAML 格式元数据块,常见于静态网站生成器(如 Jekyll、Hugo)中,用于描述文档属性。Claude Code 借用了这一约定,让 Skill 文件可以在普通 Markdown 内容之外携带结构化配置信息,而不需要引入额外的配置文件格式。
用前置配置精细控制行为
Skill 的强大之处在于它提供了丰富的配置选项(front matter),让你对每个技能的行为做精细控制。
指定模型
你可以在 Skill 里单独指定使用的模型。比如你整体在用 Opus,但某个代码审查 Skill 并不需要那么强的算力,就可以设定每次调用该 Skill 时固定使用 Sonnet 甚至 Haiku,从而节省成本。
控制调用方式
disable model invocation: true:模型永远无法主动调用该 Skill,只能由用户以斜杠命令方式手动触发。这种情况下内容只保留在本地,不会发送给模型。user invocable: false:反过来,只有模型能调用,用户无法再用斜杠命令触发。
Lydia 也坦承这两个负向配置项的设计略显别扭——按理说应该用一个开关控制,现在却是两个相互否定的设置。但目前只能先接受这样的现状。
企业级管控
对企业用户而言,effort level(努力等级)等设置可以在 Managed Settings 中统一管理。比如你不希望团队成员使用 max effort,就可以设定上限。企业管理员对团队在 Claude Code 中能做什么、不能做什么拥有相当强的控制权。
传参与动态上下文注入
Skill 还支持传递参数,使用标准的 arguments 语法即可。
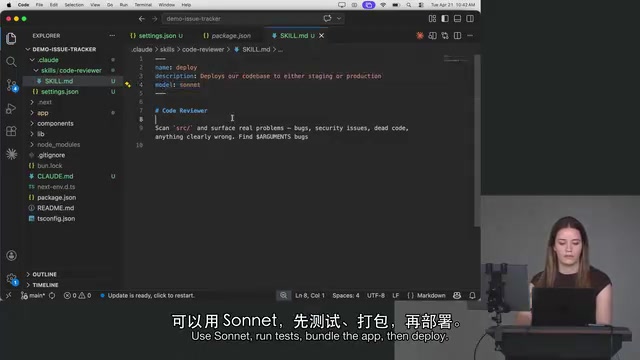
举个部署场景的例子:一个 deploy 技能可以接收环境参数,运行时输入 deploy staging,它就会把代码部署到 staging 环境;换成 production 同理。流程内部可以编排成先跑测试、再打包、最后部署到指定环境。这种参数化让同一个 Skill 能复用于多种场景,非常实用。
另一个未在幻灯片中、但 Lydia 特意演示的高级能力是动态上下文注入。通过特定语法,Skill 在把内容发送给 Claude 之前,会先执行一段 shell 命令,并把输出注入到 Skill 内容前面。比如你安装了 GitHub CLI,就可以在 Skill 发送前把相关信息注入进去。对于需要团队共享的 Skill,这个能力极为强大。
不过这也带来安全隐患:别人安装你的 Skill,就意味着在他们的设备上运行了你写的代码。为此 Claude Code 新增了一个可以禁用该行为的设置,让使用者可以选择不执行这类 shell 命令。
动态上下文注入本质上是一种「预处理钩子」(pre-processing hook)模式:在 Skill 内容真正交给语言模型之前,先触发一个副作用(执行 shell 命令),将运行时环境信息实时拼入 prompt。这与静态写死在 Skill 文件里的信息不同——后者在文件编写时就已固定,而注入的内容每次执行时都可能不同,例如当前 Git 分支、环境变量、远程仓库状态等。这种模式在 CI/CD 和多环境部署场景中尤为有价值,因为目标环境的状态本身就是动态的。安全层面,这与软件供应链攻击的风险点类似:恶意 Skill 若嵌入危险 shell 命令,接收方在不知情的情况下安装并触发,后果可能相当严重。因此在使用来源不明的共享 Skill 时,建议先检查其 shell 命令内容,或通过 Claude Code 的设置彻底关闭该能力。
小结
Skills 把 Claude Code 从"被动响应"推向"主动执行"的层面。它用一个简单的 Markdown 文件,就封装了原本需要反复解释的复杂流程,再配合模型指定、调用方式控制、参数传递和动态上下文注入等能力,形成了一套相当完整的工作流自动化机制。
对个人开发者来说,它能显著减少重复劳动;对团队和企业来说,它既能共享标准化流程,又能通过管控设置守住安全与成本的底线。核心在于转变思维:遇到重复工作,先想想能不能把它"Claude 化"。
相关推荐

Qodo CEO详解AI代码审查:当「智慧」比代码本身更值钱
OpenAI DevDay 2026访谈:Qodo创始人Itamar Friedman详解AI代码审查如何从提示工程演进到群体工程,用wisdom base编码化工程隐性知识,让审查agent与编程agent协作,重新定义「任务」单位。

OpenAI DevDay 2026:Codex 从单人到多人协作的AI工作革命
OpenAI DevDay 2026 上 Codex 团队提出从单人到多人协作的 AI 工作范式:通过 app shot、持续型 agent dot、space 协作空间与可共享插件,让整个团队与 AI agent 在单一事实来源上协同,摆脱个人成为瓶颈的困境。
Databricks上线Workday Data Connect联邦连接器:Unity Catalog打通HR数据
Databricks宣布Workday Data Connect联邦连接器在Unity Catalog进入公开Beta,支持通过查询联邦直接访问Workday的HR与财务数据,实现统一治理与跨域分析,降低ETL工程负担。