Claude Code + Skills 一键生成测试用例实战全解析

用Claude Code三阶段Skills流水线,十分钟将需求文档自动转化为可落地的结构化测试用例
本文介绍了一套基于 Claude Code + Skills 的测试用例自动生成方案。通过一句自然语言指令,系统自动触发三个串行技能:第一阶段按章节拆分需求文档,并将表格、图片转为文字、标记模糊需求;第二阶段从业务需求中提取结构化测试点(JSON格式),并自动跳过非业务章节;第三阶段基于评审后的测试点生成带完整字段的最终测试用例。每个阶段都嵌入自动评审机制。整个流程耗时不到十分钟,产出的用例包含标题、优先级、前置条件、测试数据、操作步骤、预期结果等完整字段,质量达到可直接落地的水平,相比手工编写效率提升数倍。
从需求文档到测试用例:一条指令搞定
软件测试中,编写测试用例往往是最耗时也最枯燥的环节。手工从需求文档里逐条拆解功能点、提取测试点、再补全步骤与预期结果,一个中等规模的项目动辄要花上数天甚至数周。而这个基于 Claude Code + Skills 的实战方案,把整个流程压缩到了不到十分钟。
这位 B 站 UP 主演示的场景很典型:一份包含九个章节的需求文档,第三到第六章是核心业务需求。整个操作的起点异常简单——只需要一句自然语言指令:"请调用技能对需求文档生成测试用例"。Claude Code 会自动解析这条指令,识别出需要执行的任务,并调用预先配置好的 Skills 分阶段完成工作。
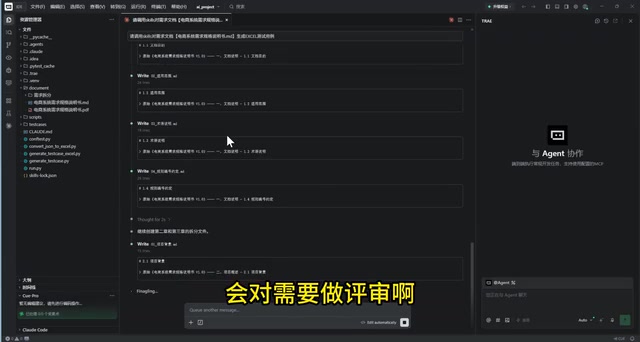
这套方案的核心思路在于把复杂任务拆成三个明确的阶段,每个阶段对应一个独立的 Skill(技能),而非让大模型一次性"端到端"完成全部工作。这种分而治之的设计,正是它能稳定输出落地级别测试用例的关键。
Claude Code 是 Anthropic 推出的面向开发者的 AI 编程助手,可在终端或 IDE 中直接执行代码任务。Skills(技能) 是其工作流扩展机制,允许用户将一段预定义的指令集或工具调用封装为可复用的命名模块。使用时只需在对话中引用技能名称,Claude Code 便会按封装好的逻辑逐步执行,无需每次重新描述任务细节。这种机制类似于将复杂的 SOP(标准作业流程)固化为可调用的函数,是本文方案实现"一句话触发全流程"的技术基础。
三阶段流水线:拆分、提取、生成
整个流程被规划为三个串行阶段,每个阶段都由专门的技能负责:
阶段一:需求文档拆分
第一个技能负责把需求文档按章节"原原本本"地拆分,不增不减。九个章节被拆成九个文件夹,保持原始需求完整。这一步有几个值得关注的处理细节:
- 标记原始位置:每个拆分出来的需求都会记录它在原文档中的位置(如第三章 3.1 环节),方便回溯。
- 表格与图片转文字:文档中的表格、流程图等非文本格式,会被转换成文字描述。UP 主特别强调这是"最难的一个点"——因为纯文字对大模型来说更容易理解和处理,语义也更清晰。
- AI 需求评审:在拆分的同时,AI 会对需求做一次评审,把不明确、模糊的地方标记出来,条件异常、边界、验收标准等也会一并梳理。
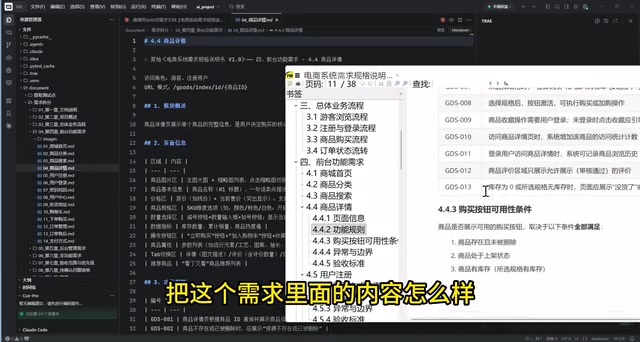
以第三章"游客浏览流程"和第四章"商品详情"为例,AI 都能准确定位原始位置、还原模块描述,并将表格形式的需求转化为文字形式,同时对不明确处做出标注。
阶段二:提取测试点
第二个技能负责从拆分后的需求中提取测试点。这里体现了一个重要的判断能力——AI 会自动跳过概述、说明这类非需求章节(比如文档的第一、第二部分只是文档说明),只针对实际业务需求提取测试点。
提取出的每个测试点都采用统一的结构化格式(JSON),包含所属模块、章节、标题、状态、步骤、预期结果、优先级,以及所使用的测试设计方法。提取完成后,AI 还会对测试点再做一轮自动评审。
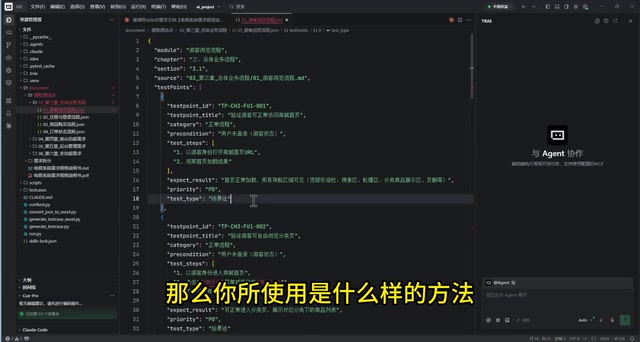
测试点以 JSON 格式输出,是工程化设计的重要体现。JSON 是一种轻量级的结构化数据格式,机器可直接解析,意味着这些测试点可以无缝对接到 Jira、TestRail、禅道等主流测试管理工具,或由下一阶段的技能直接读取处理,无需人工二次整理。相比自由文本,结构化字段(模块、优先级、测试方法等)还让测试覆盖率分析、缺陷追溯变得更加便捷。测试设计方法字段尤为值得关注——AI 会自动标注每个测试点采用的是等价类划分、边界值分析还是场景法等方法,这在手工编写时往往被省略,却直接影响用例的覆盖质量。
阶段三:生成测试用例
第三个技能调用"导出测试用例"能力,基于评审后的测试点,按章节生成最终的测试用例。
生成结果:落地级别的测试用例
最终产出的测试用例包含一份总结(每个章节有多少用例),以及每个功能下的具体用例。UP 主拿第三章第一个功能做了对比:原本需求文档里的一句话,被拆分成了八个测试用例——涵盖游客正常访问首页、分类浏览、搜索功能、商品详情等正常流程,以及购物车、收藏、下单、用户中心等需要引导登录的场景。
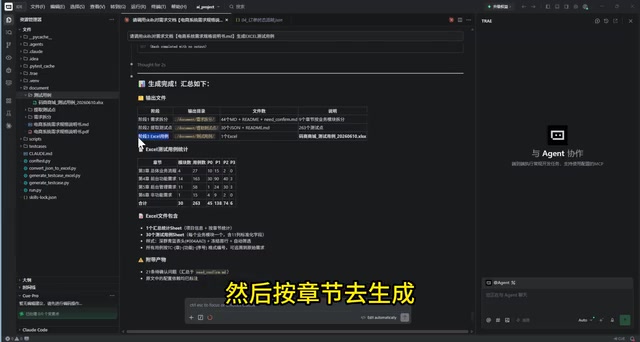
每个用例都具备完整的字段:标题、测试类型、优先级、前置条件、测试数据、操作步骤、预期结果,还额外保留了一列供人工评审,并标注对应的测试点。UP 主评价这种输出"是可以落地的使用级别",甚至比手工编写还要更细致一些。
效率提升到底有多大
从演示来看,整个从需求到测试用例的流程耗时不到十分钟。相比手工编写——UP 主直言同等工作量"至少要写好几天"——效率提升"肯定不止一倍"。
更值得关注的不只是速度,而是质量的稳定性。通过三阶段拆分 + 每阶段自动评审的设计,AI 生成的用例既保持了对原始需求的忠实度(不遗漏、不臆造),又能覆盖到正常流程与边界异常。这种"工程化"的思路,正是把大模型能力落地到实际测试工作的关键。
方法论价值:Skills 化的 AI 工作流
这个案例真正的启发在于它对 Skills 的运用方式。它没有把测试用例生成当成一个"黑盒 prompt",而是把它拆解为可复用、可组合的技能模块:拆分文档是一个技能,提取测试点是一个技能,导出用例又是一个技能。
这种模块化设计带来几个好处:任务边界清晰、每步可独立验证、评审环节可嵌入到流水线中。对于任何希望用 AI 处理结构化、流程化工作的团队来说,这套"分阶段技能 + 自动评审"的模式都具有参考价值,不仅限于测试领域。
需要提醒的是,本文基于单一来源的演示整理,实际效果会受需求文档质量、Skills 配置细节等因素影响,生产环境落地前仍建议做小规模验证。
这种"分阶段技能 + 自动评审"的架构,本质上借鉴了软件工程中的流水线(Pipeline)思想:将大任务拆解为职责单一的原子步骤,每步的输出即下一步的输入,且各步骤可独立测试和替换。与"单一超长 Prompt"方案相比,这种设计有两大优势:一是可维护性,若某一阶段输出质量不理想,只需调整对应技能的配置,不影响其他阶段;二是可观测性,每个阶段都有中间产物(拆分后的需求文件、测试点 JSON),便于排查问题根源。对于希望在团队中推广 AI 工作流的工程师,这也提供了一个渐进式引入的路径——可以先只在某一个阶段引入 AI,验证效果后再扩展至全流程。
相关推荐
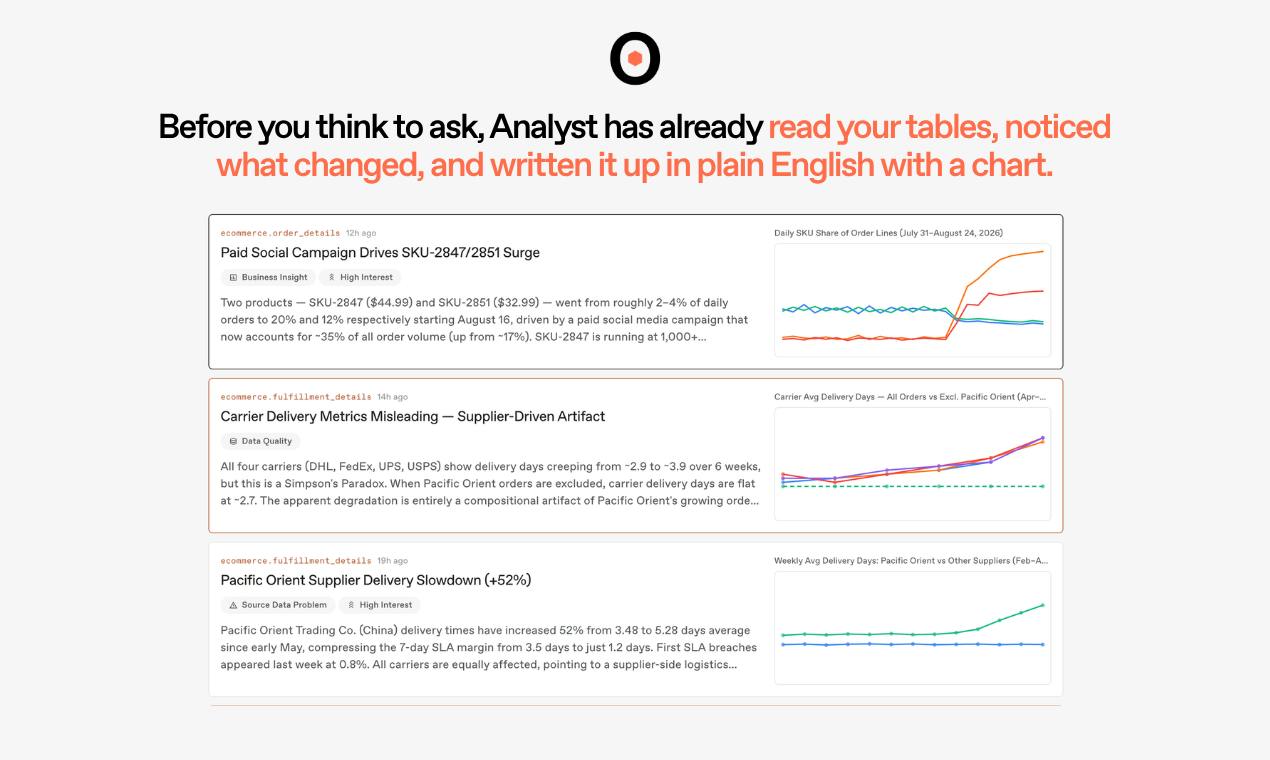
Anomalo Analyst:让数据主动开口的AI分析助手
Product Hunt 排名第二的 Anomalo Analyst 是一款主动式 AI 数据分析工具,可监控 Snowflake、Databricks、BigQuery 数据,自动发现趋势与异常,并支持自然语言追问,帮助区分真实业务变化与数据故障。
WZRD:会说话的AI原生文档、幻灯片与表单
WZRD 是一款 AI 原生办公工具,让文档、幻灯片、表单和表格都能"开口说话"。支持上传或提示词生成,产出对话式、响应式交互体验,在 Product Hunt 排名第 3。
thestory.run:不替你写作,而是教你写作的AI教练
thestory.run 是一款主打“企业影响者写作教练”的AI工具,登上 Product Hunt 第4名。与代笔式AI不同,它通过采访式引导帮你找到观点、搭建故事框架,让你成为真正的作者,同时管理内容发布节奏。