Claude Code 一次改十个文件会乱吗?分批策略与 diff 审查
Claude Code 凭全局上下文与自动调错领先,但多文件批量修改需分批与 diff 审查控风险。
文章围绕 Claude Code 与对话式编码工具的本质差异展开,指出其核心优势在于将整个项目作为上下文、并能在开发环境内直接改文件与自动调试,而 DeepSeek、ChatGPT 等对话工具只能提供零散代码片段。文章梳理了从 Copilot 自动补全、Cursor 自动编码、TRAE 中文优化到 Claude Code 的演进脉络,强调工具能力最终取决于背后大模型,Claude Code 依托 Sonnet 系列在准确性上表现突出。针对一次改十个文件是否会改乱项目的问题,文章分析了多文件修改在接口一致性、diff 审查成本和冷门技术栈错误放大上的风险,并给出分批提交任务、逐次审查 diff、用项目规范约束产出三条实践思路,最后提醒应把 Claude Code 视为需验收的协作者而非黑盒交付者。
Claude Code 是当前讨论度最高的 AI 编程工具之一。它的核心能力在于通读整个项目上下文、自动生成业务代码,并且在出现错误时自动调试,而不像网页端对话那样只能给出零散代码片段。但当任务涉及多个文件时,一个现实问题就浮现了:一次改十个文件,会不会把项目改乱?
Claude Code 与对话式编码工具的本质差异
据 B 站公开课视频中的讲解,很多人最初接触的编码辅助方式是打开 DeepSeek广告 或 ChatGPT 对话页面,让模型给出一段代码,再自己粘贴回项目里运行测试。这种方式的问题在于:模型读不到你项目的全部代码,你需要在对话里反复描述项目结构,最终还要靠人工验证代码能否跑通。
Claude Code 的不同之处在于,它直接安装在本机开发环境中,无需登录任何网站即可使用,并且能够把整个项目内容作为上下文交给大模型。视频作者强调,这是它「能力非常强」并被广泛传播的根本原因。对于拥有上百个代码文件的项目,这种全局视野是对话式工具无法提供的。
从 Copilot 到 Claude Code:编程助手的演进脉络
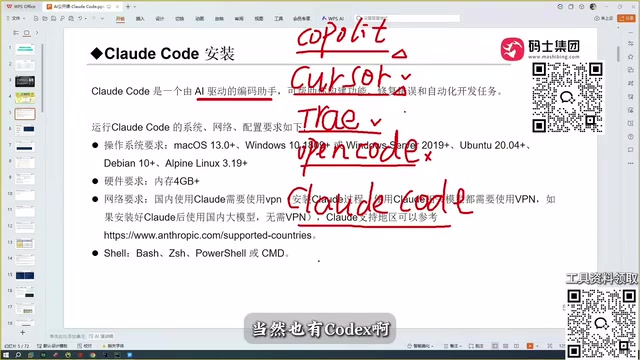
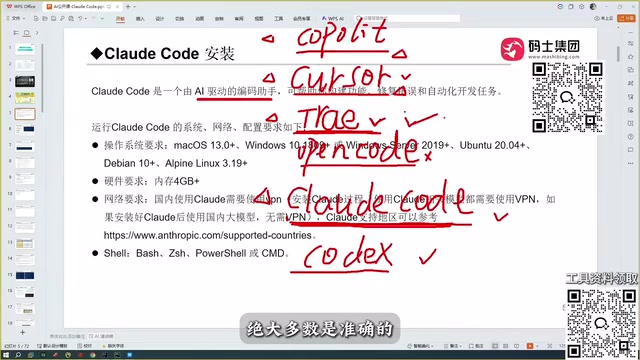
视频中梳理了一条清晰的工具演进线。早期 GitHub Copilot 以自动补全代码带来颠覆感;Cursor 在此之上实现了更智能的自动编码;TRAE 针对中文用户做了优化,理解中文需求较为到位,并且国内版免费。
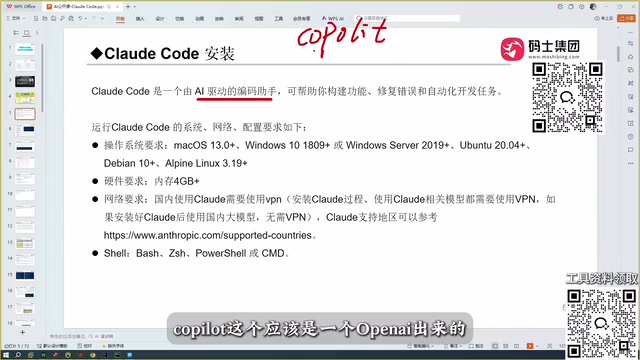
作者的个人体验是:最初认为 TRAE 是最完美的编码工具,但在使用 Claude Code 之后改变了看法,认为 Claude Code 还要再上一个等级。原因在于所有编程助手的能力最终取决于背后的大模型——Claude Code 背后的 Sonnet 系列模型表现强悍。他也提到 Codex 同样是很强的工具,外界评价与 Claude Code 不相上下,只是自己使用不多。
这里的关键判断是:工具层的差异会被模型能力抹平或放大。选择编程助手时,不能只看界面和功能列表,更要看它调用的模型在你的技术栈上是否稳定。
GitHub Copilot、Cursor 与 TRAE 的定位差异
GitHub Copilot 本质上是一个 IDE 插件,核心能力是基于当前文件和光标附近代码做行级或函数级补全,它并不主动规划跨文件的改动。Cursor 则是以 VS Code 为基础改造的独立编辑器,除了补全外还支持「Composer」式的多文件编辑与对话,能根据自然语言指令生成或修改一组文件。TRAE 是字节跳动推出的 AI IDE,形态接近 Cursor,针对中文语境和国内网络环境做了适配,并提供免费版本。三者的共同点是都依赖底层大模型,但开放给模型的上下文范围、工具调用权限(能否读写文件、能否执行终端命令)不同,这直接决定了它们处理多文件任务时的上限。
多文件修改的风险从何而来
原始视频并未展开多文件批量修改的具体流程,但从其强调的「准确性」优势可以推导出风险所在。当一次任务涉及十个文件时,模型需要在多个文件之间保持接口一致、命名一致、依赖关系正确。对话式工具因为看不到全局,往往只能逐个文件给建议,人工拼接时容易产生不一致;而 Claude Code 虽然能通读项目,但一次性改动面越大,单次 diff 的审查成本就越高,出错后定位也更困难。
作者在对比中提到,TRAE 在稍微偏门的技术栈上写出的代码「就比较不行」。这提示了一个共性规律:模型对主流技术栈的把握更可靠,对冷门框架的推断更容易出错——多文件批量修改会放大这类错误的影响范围。
什么是 diff,以及为什么审查成本会随改动面上升
diff 是版本控制系统(如 Git)用来表示两次代码状态之间差异的格式,逐行标出新增、删除和修改的内容。审查 diff 就是人工确认这些行级变动是否符合预期。当一次改动只涉及一个文件时,diff 通常几十行,容易逐行看完;当一次任务横跨十个文件时,diff 可能达到数百甚至上千行,其中既有必要的改动,也可能混入模型顺手改掉的无关代码、重命名的变量或格式变动。审查者需要在更大的信息量中分辨哪些是预期内的、哪些是副作用,注意力容易被稀释。此外,跨文件改动一旦出错,错误往往不是编译报错,而是接口语义不一致这类运行时才暴露的问题,定位需要沿着调用链回溯,成本远高于单文件修改。
分批策略、diff 审查与规范约束的实践思路
结合工具特性,可以形成一套降低多文件修改风险的做法:
分批提交任务。 把十个文件的改动拆成若干逻辑单元,按模块或按依赖顺序分批交给 Claude Code 处理,每批完成后先验证再进入下一批。这样单次 diff 的规模可控,问题更容易定位。
逐次审查 diff。 Claude Code 的运行方式是在你的开发工具内直接改文件,因此每次改动都应通过版本控制查看 diff,确认没有误删、误改无关代码,再进行提交。
用规范约束产出。 在项目里维护清晰的目录结构、命名约定和接口文档,能让模型生成的多文件改动更符合预期。约束越明确,模型自由发挥的空间越小,批量修改的一致性越高。
如何把多文件任务拆成可验证的批次
分批的核心原则是让每一批改动都能被独立验证。一种可行做法是按依赖方向切分:先改被其他模块引用的底层接口或数据结构,验证通过后再改调用方,避免上下游同时变动导致问题难以归因。另一种是按功能垂直切分,让每一批对应一个可单独测试的行为,改完即可运行相关测试用例。每批开始前先用一句话向模型明确本批的范围和「不要改动」的文件,能减少它越界修改的概率。批次大小没有统一标准,一般以 diff 能在几分钟内被完整读完为宜;对于冷门框架或模型不熟悉的代码,批次应更小。
工具之外的判断
视频作者提到,程序员用了 Claude Code 之后「会有深深的危机感」。这种感受背后是 AI 编程工具从补全走向自动化开发的现实。但工具再强,多文件改动的最终质量仍取决于人的审查与约束。把 Claude Code 当作一个能力很强但需要验收的协作者,而不是黑盒交付者,才是当前阶段更稳妥的用法。
据视频作者的横向对比,Claude Code 在准确性上的表现是其相对 Cursor、TRAE 等工具的核心优势。这一结论来自单一使用者的主观体验,尚未经过系统性基准测试验证,读者可结合自己的技术栈实际试用后再做判断。
相关推荐
Gemini 4双模型曝光,Genie 4世界模型上线,AI研发自我加速
11月19日AI晚报汇总:DeepMind Gemini 4 Sodium传闻曝光,Cursor上线Gemini 4 Neon拿下CursorBench 4.1 63.7%;Genie 4世界模型上线支持实时编辑与原声音频;WorkBuddy接入GPT-6.2系列;OpenAI披露AI芯片设计提效与RSI研究指标。
HY Roundtable:本地开源多智能体圆桌,让多个大模型盲评互怼审论文
HY Roundtable 是一款本地开源多智能体圆桌工具,把 Gemini 4、Claude Opus 5.5 与 GPT 6.2 请进本地研讨室,通过盲评互怼、交叉质询与代码复算,在投稿前揪出论文硬伤,并内置 Open Science 协议校验统计与配图。
GPT 6.2、Fable 5.2、Gemini 4 实测:一张图生成游戏UI谁最强
B站UP主实测GPT 6.2、Fable 5.2、Gemini 4用一张游戏原图生成完整UI:功能都能跑通,但设计还原度和交互质感差距明显。Fable 5.2表现力最佳却出现死循环事故,GPT 6.2均衡但图标跑偏,Gemini 4观感廉价。附LGUI Agent工作流与引擎导出方案解析。