Claude Code本地化部署指南:用本地模型跑CC省Token
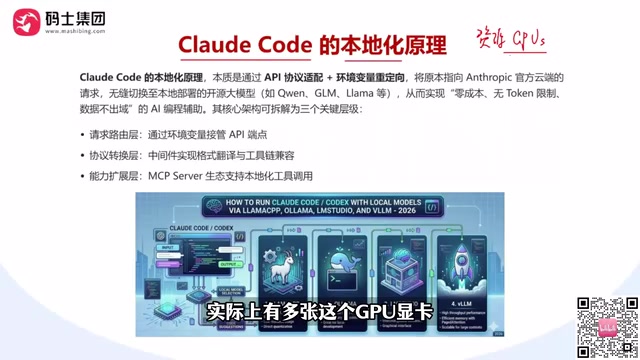
将Claude Code与本地大模型整合,可实现离线运行、规避高Token成本,关键在于按硬件显存选型合适的模型与量化方案。
本文介绍如何将Claude Code(一个面向代码任务的Agent智能体)与本地部署的大模型整合,以解决国内开发者面临的网络访问限制和高Token费用问题。核心逻辑是:Claude Code负责Agent调度与工程能力,本地模型负责推理,两者解耦后成本可控。模型选型应从任务复杂度出发倒推所需参数量,模型越大能力越强但对硬件要求越高。显卡选择的核心指标是显存大小,量化模型可显著降低显存占用。GPU加速通常依赖英伟达CUDA生态,AMD/英特尔显卡配置门槛更高。本地硬件不足时,租用云服务器GPU是灵活且经济的替代方案。
Claude Code是什么:面向代码的Agent智能体
Claude Code(简称CC)本质上是一个面向代码任务的Agent智能体。从名字就能看出,它的核心定位是借助智能体的能力帮助开发者完成代码相关的工作,而不是单纯的对话工具。
对国内开发者来说,直接连接官方云端服务存在两个绕不开的痛点:一是需要稳定访问互联网,二是按Token计费带来的成本压力。本文聚焦的思路是——把Claude Code这个工具与本地已部署的大模型进行整合,让CC在离线环境下也能工作,从根本上规避Token花费过高的问题。
这套方案的价值在于:工具(Claude Code)负责Agent的调度与工程能力,本地模型负责推理,两者解耦后,成本可控性大幅提升。
Agent智能体(AI Agent)与普通对话式AI的核心区别在于"自主执行能力"。普通对话模型只负责生成文字回复,而Agent会主动拆解任务、调用工具(如读写文件、执行终端命令、搜索代码库)、根据执行结果调整下一步行动,形成"感知→规划→行动→反馈"的闭环。Claude Code正是在这个框架下工作:它不只是建议你怎么改代码,而是直接打开文件、修改内容、运行测试、查看报错,并持续迭代直到任务完成。这种自主性使其与GitHub Copilot等代码补全工具有本质区别——后者是被动辅助,前者是主动执行。
本地模型效果好不好,取决于模型体积
很多人担心本地模型能力会不会太差。答案并不绝对,关键取决于你部署的模型大小(size)。
一般规律是:模型的体积越大、参数量越多,其本身的能力往往越强、越"聪明"。反之,7B、8B甚至更小的4B模型,能力相对有限,但对硬件的要求也友好得多。
是否"够用"并不是一个孤立的技术指标,而要结合你的实际需求来判断。如果你让模型完成的任务越复杂,对模型能力的要求就越高,需要的模型size也就越大。换句话说,先明确"要模型做什么样的事情",再倒推需要多大的模型,这是选型的正确顺序。
模型参数量通常用"B"(Billion,十亿)表示,如7B代表70亿参数。参数量越大,模型在预训练阶段学习到的知识与模式越丰富,处理复杂推理、长上下文和多步骤任务的能力也越强。目前主流的本地可部署开源模型包括Meta的Llama系列、阿里的Qwen系列、Google的Gemma系列等,参数规模从1B到70B甚至更大不等。对于代码Agent这类需要多步推理、理解项目结构并生成可运行代码的任务,业界经验表明14B以上的模型效果明显好于7B以下,32B左右的模型在大多数中等复杂度任务上已能达到可用水平。
显卡怎么选:显存是核心指标
显卡(GPU)的选择与模型大小是配套关系——模型越大,需要的GPU越好,甚至需要多张显卡并联。反之,跑7B、8B或更小的模型,通常单张显卡就够用。
判断显卡是否够用,核心看显存大小。视频中给出了几个具体参考:
- MacBook M5 Pro 48G:属于相当不错的配置,48G统一内存可以支撑较大的模型部署。
- RTX 3070 8G:计算能力偏弱,8G显存也偏小,只能勉强跑较小的模型。
- RTX 2080Ti 11G:作者自己台式机的配置,11G显存做模型部署仍显吃力。
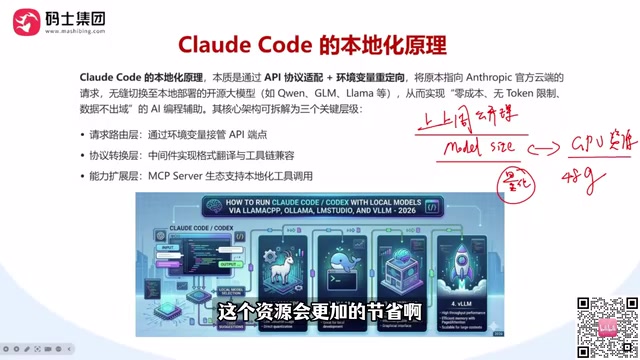
一个实用技巧是:知道显存容量后,可以反推能部署多大的模型。此外,是否使用量化模型会显著影响显存占用——同样的模型经过量化后,占用的GPU资源更少,因此更节省。这也是显存有限时的重要优化手段。
量化(Quantization)是一种压缩模型体积的技术,通过降低模型权重的数值精度来减少内存占用。原始模型通常以32位或16位浮点数存储参数,量化后可压缩至8位(Q8)、4位(Q4)甚至更低。以一个7B参数模型为例:FP16精度约需14GB显存,Q4量化后仅需约4GB,显存占用降低约60%。常见量化格式有GGUF(用于llama.cpp/Ollama)和GPTQ、AWQ(用于vLLM等框架)。量化的代价是模型能力会有轻微下降,量化位数越低损失越明显,但Q4/Q5量化在多数场景下与原始精度差距不大,是显存受限时性价比最高的方案。
N卡、A卡与云服务器的取舍
通常所说的GPU加速默认指英伟达(NVIDIA)显卡。只要安装了CUDA,模型就能在GPU上加速计算。如果你用的是AMD或英特尔的显卡,则需要另外查找并安装对应的加速套件,配置门槛更高。
对于本地显卡较弱的用户,作者给出的现实方案是上云。由于自己的2080Ti显存有限,作者本人在做模型部署时会选择云服务器,在上面挑选更好的显卡使用。云服务器提供的GPU覆盖从低端到高端,可以按需选择,既解决了硬件不足的问题,也比购置高端显卡更灵活。
CUDA(Compute Unified Device Architecture)是英伟达推出的并行计算平台与编程模型,自2006年发布以来已成为深度学习领域的事实标准。PyTorch、TensorFlow等主流AI框架均以CUDA为第一优先级进行优化,绝大多数开源模型的推理框架(如Ollama、llama.cpp的GPU加速版、vLLM)也默认支持CUDA。AMD显卡对应的替代方案是ROCm平台,英特尔Arc显卡则使用oneAPI/IPEX-LLM,两者在软件生态成熟度和社区支持上与CUDA仍有明显差距,部分模型框架对非CUDA平台的支持存在版本滞后或功能缺失的情况。因此在以模型推理为主要目的的场景中,英伟达显卡的"开箱即用"优势显著。
小结:本地化部署的核心逻辑
把Claude Code与本地模型整合,本质是在"能力、成本、硬件"三者之间找平衡:
- 需求越复杂 → 模型越大 → 显卡要求越高;
- 显存有限 → 用量化模型或转向云服务器;
- N卡装CUDA即可加速,A卡/I卡需额外套件。
理解了这条逻辑链,就能根据自己手上的硬件(无论是M5 Pro还是入门级N卡)合理选择模型规模,让Claude Code在国内环境下低成本、可离线地跑起来。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。