Claude Code后台任务机制:慢命令如何不阻塞Agent
Claude Code Harness用后台任务机制让慢命令不再阻塞主循环,实现agent并发。
文章拆解了 Claude Code 的 Harness 层如何解决「慢命令阻塞主循环」这一工程难题。由于模型多轮工具调用要求 tool_use 与 tool_result 严格配对,同步执行会让整个 agent 跟着一条 pytest 命令停摆。Harness 的解法是给 bash 工具增加 `run_in_background` 参数,由模型自主决定是否把独立命令挪到后台:主循环立刻回一条类似 HTTP 202 Accepted 的站位 tool_result,编个 bg0001 号,后台线程继续跑,完成后把结果排进完成队列,主循环每轮开头收一次并装成 task notification 并进 messages。文章还解释了 GIL 不影响此类「等子进程」的场景、加锁读写队列的必要性,以及 BackgroundManager 的 start/run/collect 三个方法。最后指出该设计仍留缺口:主循环只在你发言后才转,定时任务尚无法自主唤醒。
在AI编程agent的构建中,一个容易被忽视却极其关键的工程问题是:当一条命令要跑很久时,整个agent是否必须陪着它空等?B站UP主Cogent在"Claude Code拆解"系列第11集中,深入分析了Harness层如何通过后台任务机制解决这一阻塞问题。
问题的本质:同步执行导致主循环停摆
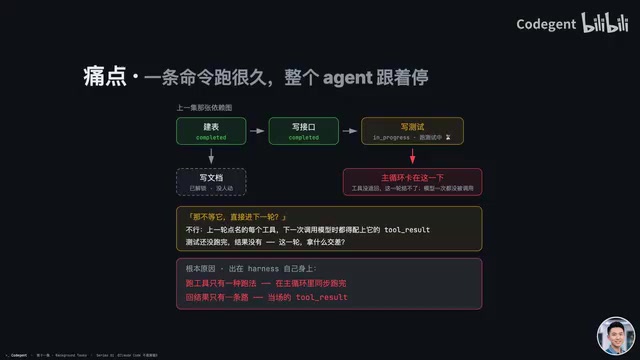
想象这样一个场景:模型正在写测试代码,写好后需要运行pytest验证。这条命令可能要跑好几分钟。另一边,旁边写文档的任务只依赖已经完成的键表接口,早就解锁了,随时可以开始。但主循环卡在pytest这一步——Harness执行工具是同步的,命令不返回,主循环就一直等。
这段时间里,模型一次都没被调用。不是它在思考,而是根本没人叫它。整个agent跟着一条命令停摆。
那能不能不等它,直接进下一轮?不行。模型上一轮点名的每个工具,下一次调用时都必须配上对应的tool result。缺一个,这次调用就会被API打回。测试还没跑完,没有结果,这一轮拿什么交差?
根本原因出在Harness自己身上:到这一集为止,Harness跑工具只有一种方式——在主循环里同步跑。跑多久,主循环就等多久。回结果也只有一条路——当场的tool result。结果晚到了,就没有路回到模型手里。
tool result 与 tool use 的配对约束是理解这一问题的前提。在大模型的多轮工具调用中,API 对消息序列有严格的配对要求:模型上一轮返回的每一个 tool_use(点名要调用的工具及其参数),在紧随其后的消息里都必须有一条对应的 tool_result(工具执行结果)。这个约束不是 Harness 自己定的,而是 Anthropic、OpenAI 等厂商 API 的硬性校验规则,缺一条或顺序错乱,整次请求会被直接拒绝并返回错误。
这条约束正是同步执行无法绕开的原因。如果模型同时点名了 pytest 和写文档两个工具,Harness 就必须等 pytest 真的跑完、拿到结果,才能把两条 tool_result 一起交出去。不能先返回一条、把另一条留到后面补,也不能用「正在跑」这种占位文本糊弄过去(除了后面会讲到的 202 式站位结果)。所以只要工具执行是同步的、结果只能当场返回,慢命令就必然拖着整轮调用一起等。
解决方案:多一种跑法,多一条路
Harness的做法很直接:慢命令挪到后台,主循环接着转。
具体来说,模型在点名bash工具时,可以多带一个参数run_in_background设为true。这个参数是否启用,由模型自己决定。System prompt里交代一句:只有独立的命令才放后台,后面的活儿不等它的结果。
Harness一看这个参数,就开一个后台线程,把命令交过去,编个号bg0001,然后不等它。主循环立刻回一个站位的tool result——"后台任务bg0001已经开始"。
写过Web后端的开发者会觉得眼熟:这跟HTTP的202 Accepted一个路数。活儿收下了,还没做完,先给你个编号。tool use配上了tool result,下一轮照常开。主循环接着转,模型去写文档,后台那条线程上测试还在跑,两件事同时在推进。
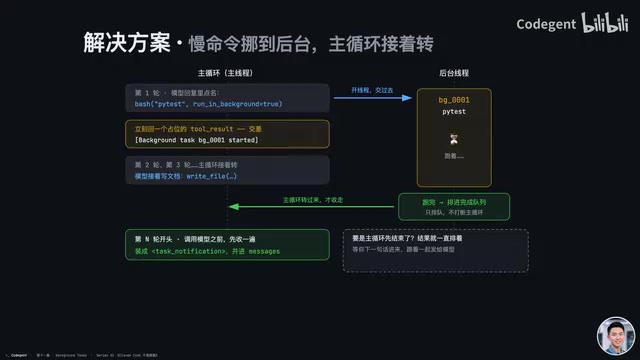
测试跑完了,后台线程不打断主循环,只把结果放进一个完成队列排着。等主循环转到第N轮调用模型之前,Harness先去队列里收一遍结果,装成一条task notification并进messages,这次调用就带给模型。那个tool use已经配过站位了,一个tool use只配一个tool result,所以结果换个身份回来——一条通知。
那要是测试还没跑完,模型那边的活儿先干完了呢?模型不再点名工具,主循环就结束了,把话交回给你。后台线程照样跑,跑完照样排队。可主循环不转,没人来收,结果就一直排着,等你下一句话。你一开口,主循环转起来,开头那一下把它收走,跟你的话一起发给模型。如果直接退出,没跑完的命令会被一并清掉。
HTTP 202 Accepted 是 202 类状态码中唯一被正式采用的一个,语义是「服务器已接受请求,但尚未处理完成」。它不承诺什么时候办完,通常会在响应体里返回一个用于后续查询的 URL 或任务 ID,客户端凭这个 ID 之后再来问结果。这跟「同步的 200 OK(办完了才回)」和「201 Created(新建了资源)」有本质区别:202 是一种主动的「异步收据」。
文章里拿它类比后台任务的站位 tool_result 非常贴切。Harness 收到 run_in_background=true 后立刻回一条「任务 bg0001 已启动」,就是给模型开了一张收据;真正的结果不走这条通道,而是稍后以 task notification 的身份独立回来。这样的设计让同一个 tool_use 只用一条站位结果就完成了配对闭环,既满足了 API 约束,又让主循环得以继续推进。
线程补课:等这件事可以换个角色来做
熟悉Python的读者可能会问GIL的问题。GIL(全局解释器锁)是CPython解释器里的一把锁,用来保护解释器内部数据。副作用是同一时刻只有一个线程在跑Python代码。
这里不碍事。后台线程大部分时间在等子进程——pytest真正跑在子进程里,后台线程只负责等它跑完。等的时候它把GIL让出来,主线程照常转。
真正需要小心的环节是线程间通信。两条线程在同一个进程里共用内存,后台线程把结果写进results编号、排进ready完成队列。要是不加锁,主循环刚把队列数完还没清空,后台恰好排进来一条,一清空这条结果就丢了。
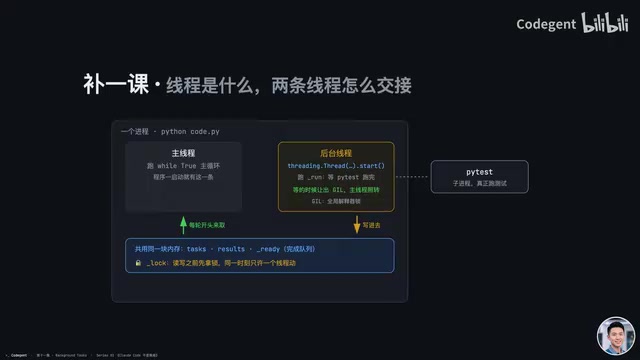
所以读写在代码之前先拿锁,同一时刻只允许一个线程动。还要注意一点:这里只有共享和加锁,没有通知机制。后台线程放进去就走,不会去叫主线程。主线程只在每轮开头自己来看一眼。前面那种主循环一结束结果就只能排着的情况,原因就在这。
daemon 线程(守护线程) 是 Python threading 模块里线程的一个属性,通过 thread.daemon = True 或 Thread(daemon=True) 设置。它的特殊之处只在程序退出时的行为:主线程结束时,所有非 daemon 线程必须自己走完或被显式 join,解释器才会真正退出;而 daemon 线程会被直接强行终止,不会被它拖住。
这正是文章强调 daemon=true 的原因。后台任务可能是一条跑了几分钟的 pytest 或一条挂住的网络请求,如果它是非 daemon 线程,用户想退出程序时就得等它,体验会很差。设成 daemon 后,用户一按退出,主线程结束,后台线程随之被丢弃。代价是那些没跑完的后台命令会被一并清掉、结果永久丢失——这与文中「直接退出,没跑完的命令会被一并清掉」的描述完全对应,是 daemon 语义的另一面。
代码落点:BackgroundManager的三个方法
后台这一套在Harness里落在两处:主循环开头一行,和执行工具时一个分叉。
主循环还是那个while true,只加了一行:每一轮调用模型之前,先把后台做完的收进来。模型回复里点名的工具,主循环挨个交给execute分叉处理。进来第一件事照旧先过pre-tool use全线检查——放后台的命令也一样要过,放后台不等于绕过检查。
然后是分叉条件:工具是bash,而且run_in_background明确为true。Harness不去猜,不看命令里有没有install、test这种字眼,模型说了算。走后台就开线程、拿编号,回一句"后台任务已经开始,结果以后某一轮再收"。
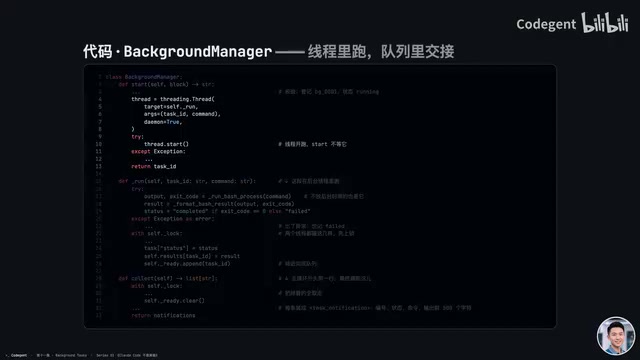
核心是BackgroundManager的三个方法:
- start:登记好编号,开一个
daemon=true的线程让它去跑。daemon确保程序退出时不会被这条线程拖住。 - run:在后台线程里跑命令,用的还是不放后台时那个函数,超时规矩也照旧。放后台图的是不挡路,不是让它跑得更久。退出码为0即completed,非0或超时即failed。跑完在锁里登记状态和结果,把编号排进ready队列。
- collect:主循环开头调用,在锁里把队列里排着的全取走然后清空。每一条装成task notification——编号、状态、命令、加输出的前500个字符——交给主循环开头那一行,并进messages。
不放后台的照旧同步跑完,跟以前一模一样。两条路最后都过post-tool use,把output交回主循环,这个tool use当场就配上了它的tool result。
这里涉及的是生产者—消费者模式的一种变体。后台线程是生产者,把完成的结果排进 ready 队列;主循环在每轮开头扮演消费者,把队列一次清空。文章特别指出两个细节值得注意。
其一,队列的「读—清空」必须整体持锁。如果按「先看长度、再逐个取、最后清空」分步操作且不加锁,中间就可能被后台线程插进来写入,清空时把新写入的那条一起抹掉,造成结果丢失。所以 collect 是把队列操作包成一个临界区一并完成。
其二,这个实现刻意去掉了通知机制,只保留共享与加锁。后台线程放完就走,不会 notify 或 set event 去唤醒主循环;主循环也不阻塞在队列上等待,而是在每轮固定时间点主动来查。这样做的好处是主循环永远不会被后台线程「意外叫醒」,所有时序都收在主循环自己的节奏里,行为可预测;代价是结果何时被收取决于主循环何时下一轮开跑——这正是文章末尾「主循环不转,结果就一直排着」的根源,也为下一集引入自主唤醒的调度器埋下伏笔。
这套设计留下了什么缺口
后台任务立起来了,命令再慢也不挡路。但什么时候开跑,还得有人开口。比如你交代一句"以后每天早上9点把测试跑一遍",9点到了,可主循环只在你发了消息之后才转。你不在电脑前,它就一动不动,测试没人叫它跑,这一集的后台结果也没人来收。
这正是系列下一集要解的问题:到点了没人开口,agent如何能自己动起来?Cogent预告的Crown Scheduler将处理定时调度与agent自主唤醒的难题,值得持续关注。
对于正在构建AI agent的开发者来说,这一集的核心启示在于:Harness层的工程细节决定了agent能否真正高效并行。把"等待"从主线程挪给后台线程,看似简单的架构调整,实则是agent从"单线程执行器"进化为"并发任务协调者"的关键一步。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。