Claude Code会话变笨?5个习惯让它保持便宜又犀利

Claude Code 长会话越用越笨,5 个习惯主动管理上下文保持犀利。
文章针对 Claude Code 会话越久越迟钝、越跑偏的现象,指出根源在于每条消息都携带完整会话历史,上下文窗口被早期试错、废弃方案和纠正记录不断塞满,导致推理受干扰。作者提出 5 个主动管理上下文的习惯:用 /usage 定期查看会话成本与套餐余量;新会话先跑 /context 查看技能、工具、记忆等初始占用并精简;完成阶段后主动 /compact 并指定保留内容,而非依赖自动压缩;同一问题纠正两次仍错就 /clear 重开并换更好的提示词;定期用 /memory 检查并删除错误的自动笔记。五个习惯覆盖会话从开始、推进到结束的完整生命周期,核心逻辑是对上下文保持主动管理,让会话该长则长、该断则断。
用 Claude Code 写代码时,你有没有这种体验:同一个会话聊得越久,它的回答就越迟钝、越跑偏,甚至开始重复犯错?YouTube 频道在系列视频第 6 部分专门讨论了这个问题,并给出 5 个习惯,让会话保持“便宜又犀利”。
为什么会话会变“笨”?
问题的根源在于上下文窗口的工作方式。你发出的每一条消息,都会把整个会话历史一并带上。会话越长,携带的内容越多,模型要处理的信息就越臃肿——视频里用“Clog”来代指这种越用越迟钝的状态,形容得相当贴切。
这并不意味着模型本身变差了,而是它被塞进了太多无关的旧信息:早期试错的代码、已经废弃的方案、中途纠正过的错误。这些内容堆积在上下文里,持续干扰后续的推理。
上下文窗口(context window) 是模型单次推理时能“看到”的 token 总量上限,包括系统提示词、工具定义、历史对话、文件内容等所有内容。Claude 的上下文窗口有固定容量(例如 200K token),当会话历史不断累积,模型必须在有限容量内处理全部信息。这带来两个后果:一是接近上限时,早期关键信息可能被挤出或被压缩,导致模型“遗忘”重要约束;二是即使未达上限,过多无关 token 也会稀释注意力,使模型在长上下文中更难聚焦当前任务。因此,上下文管理本质上是在有限窗口内做信息取舍,而不是单纯让模型“记住更多”。
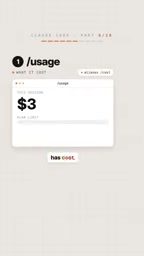
习惯一:先看会话成本——/usage
第一个习惯是主动查看会话的消耗情况。运行 /usage,可以清楚看到当前会话已经花了多少,以及距离套餐上限还有多远。
这个动作的价值在于建立成本意识。长会话不仅拖慢响应质量,也在持续消耗额度。很多人直到撞上限制才发现自己一个会话已经跑了大半天。把 /usage 当成定期体检,能让你在成本失控前做出调整。
习惯二:新会话先跑 /context
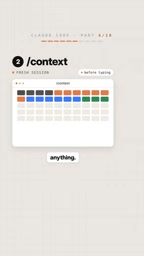
第二个习惯针对会话的起点:开启一个全新会话后,先别急着输入任何内容,而是运行 /context。
这个命令会显示当前已经有那些东西在占用空间——技能(skills)、工具(tools)、记忆(memory)等。视频强调,它还会给出精简这些占用的建议。也就是说,你可能还没说第一句话,上下文里就已经躺着一堆默认加载的内容了。
先看清家底再动笔,避免一开局就背着一身包袱。
习惯三:别等自动压缩——主动 /compact
第三个习惯是关于压缩时机的。不要等到系统触发 autocompact 才被动压缩上下文。
视频给出的操作节奏是:完成一个阶段后,主动运行 /compact,并明确告诉它要保留什么,例如“focus on the API changes”(聚焦 API 变更)。这比让系统自动判断保留什么要精准得多——你清楚自己下一阶段要做什么,而自动压缩只能靠猜。
autocompact(自动压缩) 是 Claude Code 在上下文接近容量上限时自动触发的机制:它会将较早的对话历史总结成一段精简摘要,以释放 token 空间。自动压缩的局限在于,它只能根据已有对话推测哪些内容重要,无法预知你下一步要做什么。如果你即将进入一个新阶段(比如从调试转向写测试),自动压缩可能保留了大量与下一阶段无关的细节,却丢掉了你真正需要的约束。主动 /compact 并附带指令(如“focus on the API changes”),相当于把“什么该留”的判断权从系统交回给你,压缩结果更贴合后续任务。
习惯四:纠正两次仍错就 /clear
第四个习惯更像是一条止损纪律:如果你已经纠正了同一个问题两次,它还是错,那就停下来,运行 /clear 重开一个新会话,配一个更好的提示词。
继续在旧会话里纠缠,往往是在为已经污染了的上下文买单。越纠正,上下文里堆积的错误示例越多,模型越容易被带偏。果断清空重来,成本反而更低。
习惯五:定期检查 /memory 里的自动笔记
最后一个习惯容易被忽视:运行 /memory 查看模型自己写的笔记。
视频指出,Clog 会根据你的纠正自动写笔记。这些笔记本意是帮助模型记住你的偏好,但如果某条笔记记录有误,它会在后续会话中持续误导模型。定期检查并删掉错误的内容,等于给模型做一次记忆校准。
Claude Code 的 memory 机制 是一套跨会话的持久化记忆:模型会把从对话中提炼出的用户偏好、项目约定、纠正过的错误等写成笔记,保存到项目或用户级别的记忆文件中,并在后续会话中自动加载。它的设计目标是减少重复说明,但记忆是模型“自认为”重要的内容,可能记录不准确、过时或过度概括。错误笔记一旦写入,会在每次新会话中作为上下文的一部分被加载,持续影响模型行为,且不易被察觉。定期运行 /memory 审查并删除错误条目,是维持记忆质量、防止“错误偏好”长期污染的必要操作。
这 5 个习惯背后的共同逻辑
把五个习惯放在一起看,它们指向同一个思路:对上下文保持主动管理,而不是放任它自然膨胀。
/usage 管的是成本可见性,/context 管的是初始负载,/compact 管的是阶段切换时的信息取舍,/clear 管的是止损,/memory 管的是长期记忆的准确性。它们覆盖了一次会话从开始、推进到结束的完整生命周期。
视频结尾抛出了一个问题:你保持过的最长会话是多长时间?这其实也是在提醒,长会话本身不是目标,让会话在该长的时候长、该断的时候断,才是用好 Claude Code 的关键。
下一个部分将讨论“从任何地方写代码”(coding from anywhere),属于该系列 10 个习惯中的第 7 部分。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。