Claude Code记忆功能实测:45条记录26条从未被读,该关掉吗?
Theo实测证明AI代码记忆系统几乎无效,主张用架构设计和AGENTS.md替代自动记忆。
Theo(t3.gg)通过实测发现Claude Code自动记忆的45条内容中有26条从未被读取,写读比高达3:1,由此得出结论:AI编程不需要独立的记忆系统。这一观点与Pi创作者Mario、Flask创作者Armin的判断高度一致——"代码即真相",多一个需要维护的记忆层只会带来信息分裂与误导。替代路径是:优先从架构层面消灭整类错误,其次用lint/CI兜底,最后才是写skill/rule;而跨session的方向性知识,应通过精心撰写的AGENTS.md传递——告诉agent"如何思考",而非逐条纠错。Cursor从代码图谱转向工具+bash的路径转变,印证了复杂上下文管理系统已被模型自身的工具使用能力取代。
AI要在代码库里高效工作,前提是理解代码库长什么样、东西放在哪、以及如何完成任务。过去几年里,无数人尝试用各种系统、插件和"记忆"机制,把"该怎么做"自动编码进agent的大脑。Theo(t3.gg)在最新视频中直接给这套思路泼了盆冷水,并用自己的机器做了一次相当扎心的实测。
本文结合Theo的实测过程,以及Pi创作者Mario与Flask创作者Armin的对谈观点,梳理一个正在AI编程圈发酵的共识:代码不需要独立的记忆系统。
核心论点:代码即真相,记忆是多余的维护负担
Mario在对谈中的第一句话就足够犀利:"对于编程,我不需要记忆系统。代码就是真相(Code is truth),它是ground truth,而且它一直在演化。我不需要另一个需要维护的地方——我已经有一个代码库要维护了。"
Theo对此完全认同。他指出,即便是代码注释都会过期:某段注释解释了代码为何要这样写,但代码改了、注释没改,这条注释就从"没用"变成了"有害"——它会把人和agent引向错误方向。
信息越分散,"精神分裂"(split-brain)问题越严重。你在一处改了东西,忘了同步其他地方,整个系统就崩了。在AI时代这个问题更普遍——人们随手写下的markdown计划文件被留在repo里,几个月后严重过时,持续污染模型的上下文。
bash就是你需要的一切
对谈中另一个关键判断是:bash is all you need。Mario和Armin在不同路径上都发现,如今的模型天生被训练得擅长使用bash。给它工具和bash,它就能相对可靠地找到自己需要的东西。
Theo用Cursor做了一个有说服力的佐证。Cursor团队曾经是把AST、embedding、代码图谱做到极致的公司——他们靠动态喂给模型"正确的上下文"起家。当年Cursor的CEO Michael最爱谈的话题是:上下文窗口会越来越大,直到能装下整个代码库。
但Claude Code证明了另一条路:不需要花哨的动态上下文图谱,只要给模型工具和bash,它自己就能找到需要的东西。当模型开始被训练成这样工作,那些复杂的上下文管理系统就失去了意义。连Cursor自己都基本放弃了当年赖以起家的代码遍历系统。
Theo的结论很直接:"如果你现在还在造花哨的上下文管理系统,而不是直接给agent找东西的工具,你已经落后于曲线了。"
AST(抽象语法树)是代码的树形结构表示,能捕捉语言的语法关系;embedding是将代码片段映射为高维向量的技术,便于按语义相似度检索;代码图谱则把函数调用、模块依赖等关系显式建模为图结构。这三者共同构成了"传统RAG式"代码理解的技术底座——系统预先解析整个代码库,在模型生成回答前动态检索最相关的片段塞入上下文。Cursor早期的核心竞争力正是这套流水线的精细程度。Claude Code的崛起说明,当模型本身被充分训练成"会用工具找东西"的agent,预处理式的索引和检索层就变成了额外的工程负担,而非真正的护城河。bash命令(如grep、find、git log)相当于给模型一把手电筒,让它在需要时自己探索代码库,而不是依赖预先铺好的路线图。
实测暴击:45条记忆,26条从未被读
视频最有价值的部分是Theo在自己机器上的实测。他在多台机器上用Claude Code和Codex开发t3 code,最近注意到agent频繁往memory里存东西,于是决定查一查这些记忆到底存了什么。
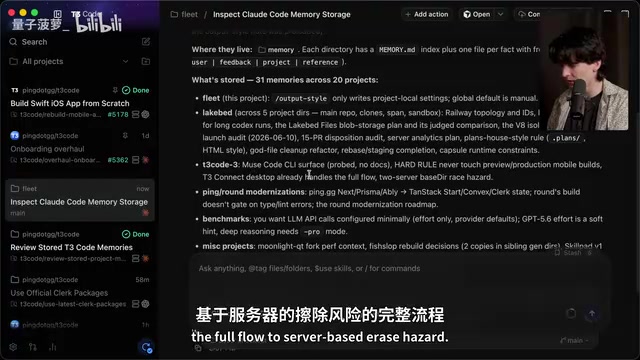
结果令人无语:
- 一台机器上唯一的一条记忆,是9天前一个他根本没打算发布的功能spec;
- 主clone里存了45条记忆,包括"onboarding改版""侧边栏改版偏好variant C"这类早已过时的临时状态;
- 大量记忆是point-in-time状态(某个PR是否合并、某个泄漏是否修复、GitHub CLI版本过期已更新),这些一旦时过境迁就变成误导;
- 很多内容与AGENTS.md重复——本该被每个agent读取的规则,却被冗余地塞进了memory。
最扎心的数据来自使用频率统计:在这台机器超过355个session里,只有19个打开过某条记忆文件,却有80个session在写入或编辑记忆——写读比达到3:1。而45条记忆中,26条从未被读取过一次。
Theo当场决定:在整个机器集群上关闭Claude Code的memory,归档、打标签后全部删除。"我早知道它会很糟,但没想到糟成这样。"
替代方案:把知识做进架构,而非塞进记忆
关掉记忆之后,正确的做法是什么?Theo提出了一套分层思路,并引用了前React圈、现Cursor工程师Lauren(potato)的价值排序框架——每次你纠正agent,都应该思考如何"彻底消除"那个错误。
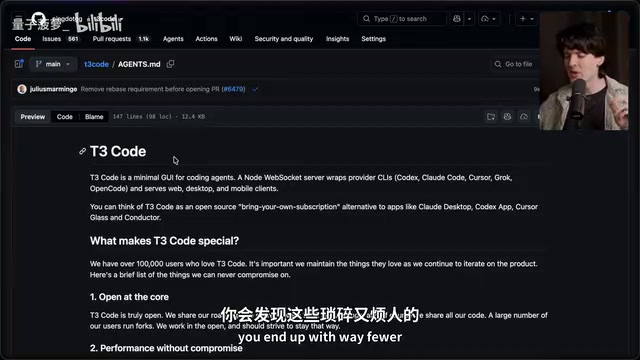
第一层,从架构上消灭整类错误。 这是Theo从AI时代之前就在做的事,也是他做t3 stack、爱用tRPC和Convex的原因——前后端类型安全能让整类bug直接消失。他分享了一个真实案例:t3 code的数据传输层曾膨胀到加载一个thread要传几十MB,他优化到10K以内后,回归问题仍不断出现。于是他在CI里加了一个复杂检查,对真实thread做回放、测量WebSocket实际传输的数据量,并设了比优化后高30%的天花板。任何改动越线,PR直接失败。"现在agent做的改动引发回归时,它会在告诉我完成之前自己修好。"
第二层,做成lint规则或测试。 如果架构层面无法根除,就用CI能捕捉的方式兜住,让agent在打扰你之前就发现问题。
第三层,才是skill和rule。 Theo强调skill应该是"安全网"和"兜底",而不是动不动就去堆砌的东西。它更适合处理流程相关的事(比如远程暴露服务器),而非代码本身。
AGENTS.md的正确写法:传递方向,而非纠正细节
Theo展示了自己"最不generic"的AGENTS.md,核心理念是:不要只告诉agent不许做什么,而要让它理解你希望它如何思考。
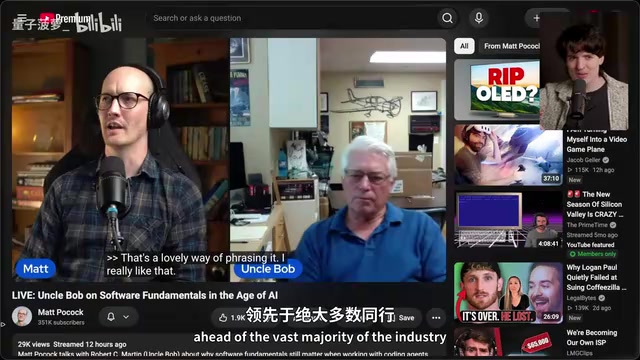
他的AGENTS.md先讲清"这是什么"和"它如何工作",再用"什么让t3 code特别"这一节传递方向:
- 开源为核——提醒模型不要建议闭源任何部分(模型确实提过这类建议);
- remote ready——强调远程体验很重要,避免模型只在本地测试通过就交差;
- glossary术语表——让agent和人共享同一套语言;
- taste品味——把合作者Julius的偏好(复杂度收敛在adapter边界、拒绝不必要的any类型、注释描述用途而非逐行标注)写进去,持续校准方向。
视频中引用的一句Uncle Bob的话被Theo奉为金句:"给agent强加人类的纪律(discipline)可能是错的,但给agent强加人类的价值观(values)不是错的。"
AGENTS.md(有时也叫CLAUDE.md或Cursor Rules)是存放在代码库根目录的纯文本文件,在每个新session启动时被自动注入到模型的上下文窗口最前端,相当于"每次唤醒agent时第一句要说的话"。它的优先级高于通用系统提示,低于用户在会话中的实时指令。正因为每个session的上下文都从零开始,AGENTS.md是目前最可靠的跨session"持久化知识"载体——不同于自动记忆的随机写入与极低读取率,它是开发者主动策划、每次必读的内容。Theo强调写法上要"传递方向",本质上是在利用这个机制的稳定性:与其用它打补丁("不要用console.log"),不如用它建立共同的世界观,让模型在没有明确指令时也能做出符合项目气质的判断。
结语:让agent足够懂你
Theo的最终落点是:你和agent应该配合到"你经常惊讶于它有多懂你"的程度。每开一个新thread,agent的大脑都被清空——这不意味着需要自动记忆来"保鲜",恰恰相反,自动记忆让它变得更糟。真正需要的,是在它"醒来"时就把对你重要的东西装进它脑子里。
对于正在用Claude Code的开发者,Theo给出了明确建议:把memory关掉。把精力花在架构设计、CI防护和精心撰写的AGENTS.md上,收益远比自动记忆来得实在。
相关推荐
AI Agent实战指南:三层用法让效率翻倍
一篇系统梳理AI Agent用法的实战指南,从填表格、视频转录等基础杂事,到CLI、Skill、插件的能力叠加,再到行程规划、Final Cut Pro剪片等复杂目标的自主实现,三层递进讲透如何用Agent让工作效率翻倍。
从0到1搭建企业级AI Agent:三阶段学习路径全解析
一套从0到1搭建企业级AI Agent的748集教程解析,涵盖ReAct框架、LangChain与AutoGen实战、RAG混合架构及智能客服、数据分析、多Agent协作三大落地项目,附完整学习路径。
好莱坞对AI末日警告的态度:眼前的威胁比生存危机更紧迫
科技行业警告AI可能毁灭人类,好莱坞娱乐劳工组织却呼吁关注眼前现实:生成式AI对创意工作岗位、版权和演员形象的冲击。迪士尼、Netflix等制片厂已在使用AI,两种AI焦虑正在碰撞。